
MACE基础模型推断与微调
使用固定版本的MACE-MPA-0,完成推断、Si小数据微调及能量力应力的前后比较。
阅读本篇目录
下载本专题输入、Si实算数据、教学模型与工具(ZIP)。微调沿用已有模型的参数,通常比从随机权重开始更容易得到可用预测,但改善哪些性质仍要看独立测试。
1 固定模型,先做基线推断#
bash calculate.sh foundation
head -n 20 work/foundation/RESULTS.json
使用本集群只读的 mace-mpa-0-medium.model,文件SHA256为:
75428afe3a1d7d8062e19bcaabd5c433623cabf308242ec9fb493e38604fb638
脚本核对模型哈希,读取附件 data/foundation-structures/ 中的8个原始POSCAR,重新计算PBE独立测试构型的能量、力、应力和由应力得到的virial。使用原始坐标,避免extxyz写出小数位数的差别影响严格数值对照。原始基础模型不被修改。模型来源与许可见 MACE foundations;附件不重复打包这份基础权重。
关键Python写法为:
from mace.calculators import MACECalculator
calc = MACECalculator(
    model_paths="/public/software/mace/models/mace-mpa-0-medium.model",
    device="cpu", default_dtype="float64")
atoms.calc = calc
energy = atoms.get_potential_energy()
forces = atoms.get_forces()
stress = atoms.get_stress(voigt=False)
virial = -atoms.get_volume() * stress
2 提交微调#
bash train.sh finetune64
squeue -u "$USER"
数据仍为32个PBE训练构型和8个验证构型。configs/finetune64.yml 中的关键差异是:
foundation_model: /public/software/mace/models/mace-mpa-0-medium.model
multiheads_finetuning: false
default_dtype: float64
lr: 0.001
ema: true
ema_decay: 0.999
max_num_epochs: 80
energy_weight: 1.0
forces_weight: 100.0
stress_weight: 1.0
这里做单头微调,结构架构和截断继承基础模型,不套用从头训练小模型的5 Å配置。它与官方的带预训练数据回放的多头微调是不同流程,后者见官方说明。
3 对比全部目标,不能只挑变好的指标#
bash run.sh
cat analysis/heldout-metrics.csv
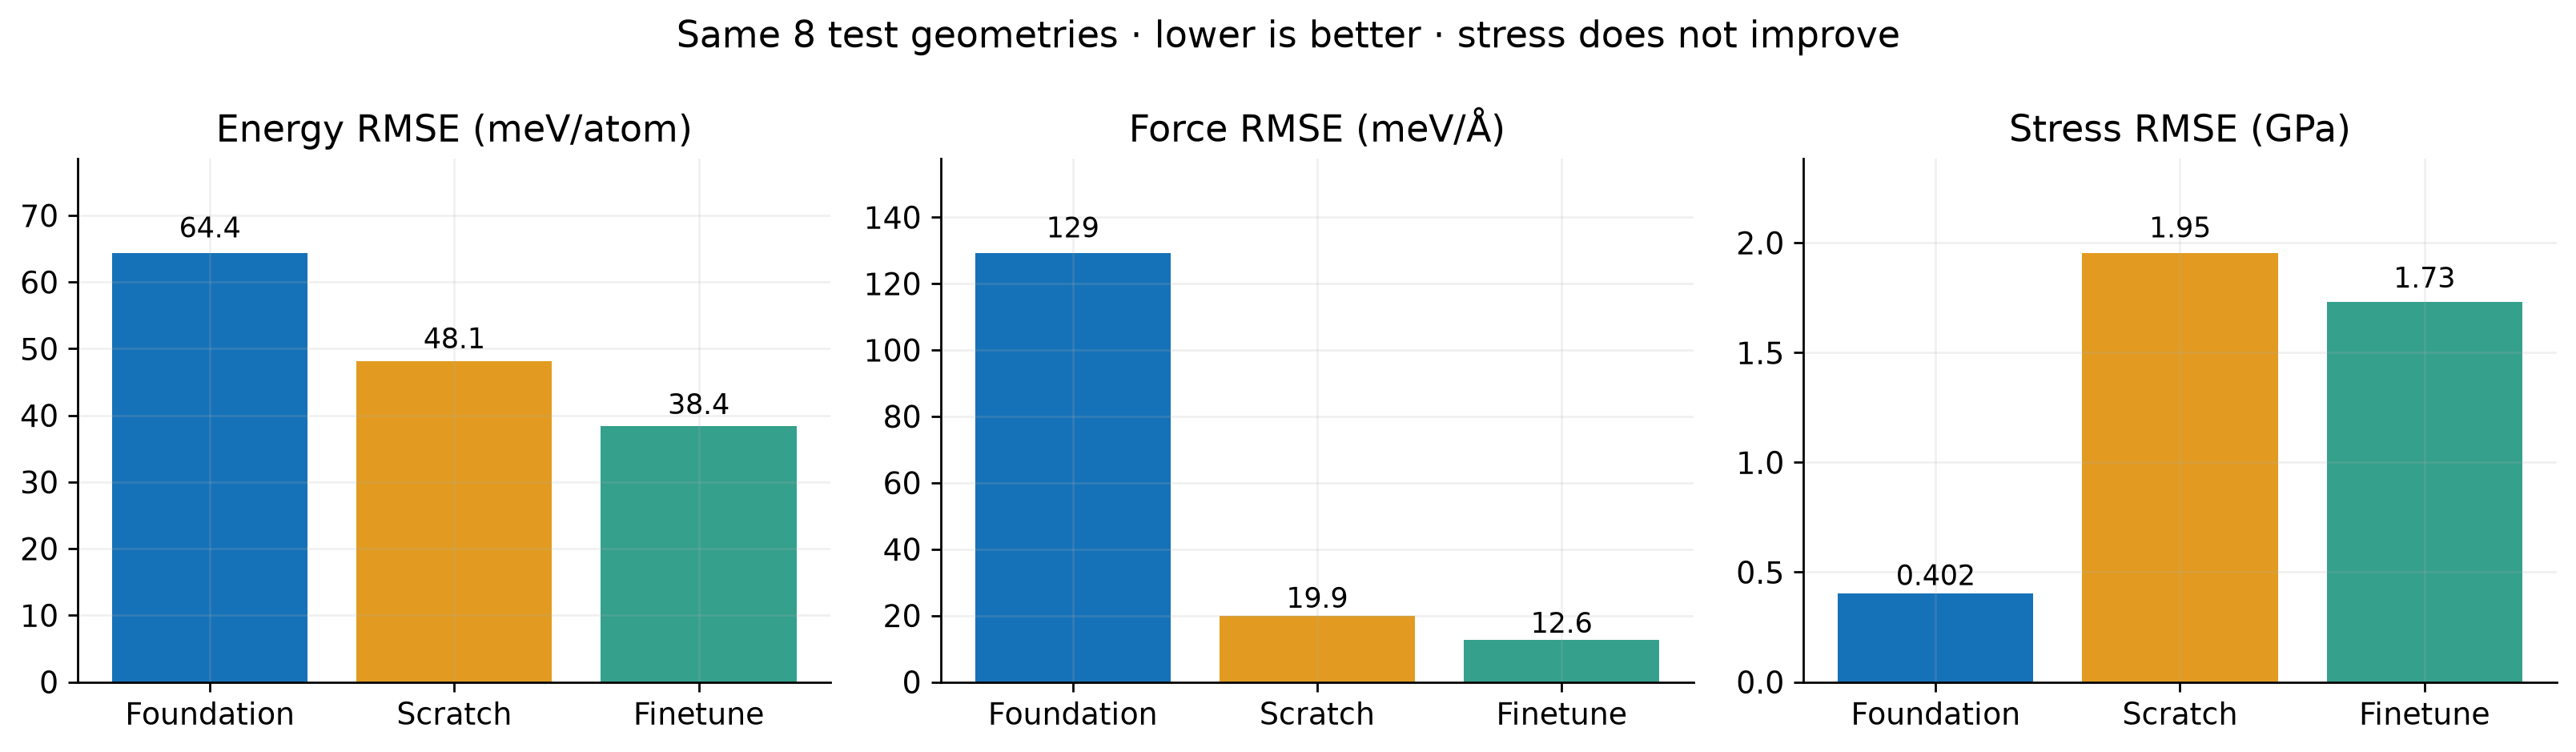
| 模型 | 能量RMSE(meV/原子) | 力RMSE(eV/Å) | 应力RMSE(GPa) |
|---|---|---|---|
| 基础模型 | 64.412 | 0.12931 | 0.4024 |
| 从头训练seed13 | 48.107 | 0.01994 | 1.9548 |
| 本次微调 | 38.430 | 0.01255 | 1.7308 |
本次微调让能量和力误差降低,应力误差增大。因此它不能被直接推荐为压力、变胞或NPT计算的更优模型。若目标主要是应力,应重新检查数据覆盖与损失权重,并用独立结构测试。
4 使用微调模型#
module load mace/0.3.16
mace_eval_configs --configs data/PBE-test.xyz   --model models/finetune64.model --output work/finetuned.xyz   --device cpu --default_dtype float64 --batch_size 1 --compute_stress
python inspect_data.py work/finetuned.xyz
附件模型已转换为可在CPU读取的权重。新训练模型若来自GPU保存,应先按转换教程处理。当前测试反映的是同一Si小应变、小位移分布内的预测表现,不能据此声称跨温度、跨相或缺陷泛化。
需要根据你的体系选择资源?联系讨论计算需求。实际可用软件与权限,以当前账户和运行环境为准。