
MACE设备、精度与模型转换
说明CPU、P100、V100 16G上的实际推断对照,以及GPU保存模型转CPU和单双精度的区别。
阅读本篇目录
下载本专题输入、Si实算数据、教学模型与工具(ZIP)。本例环境为MACE 0.3.16、Python 3.11、PyTorch 2.8.0+cu126与e3nn 0.4.4。MACE通过Python/PyTorch运行,模型文件本身不等同于LAMMPS插件。
1 确认环境#
module load mace/0.3.16
python -c 'import torch,mace; print(torch.__version__); print(torch.cuda.is_available())'
cuda.is_available() 需要在已分配GPU资源内看才有意义。载入模块不等于申请到GPU。训练入口 bash train.sh scratch64-s13 会通过Slurm申请单张P100;distributed64 则申请两张。
2 FP64与FP32的实际差异#
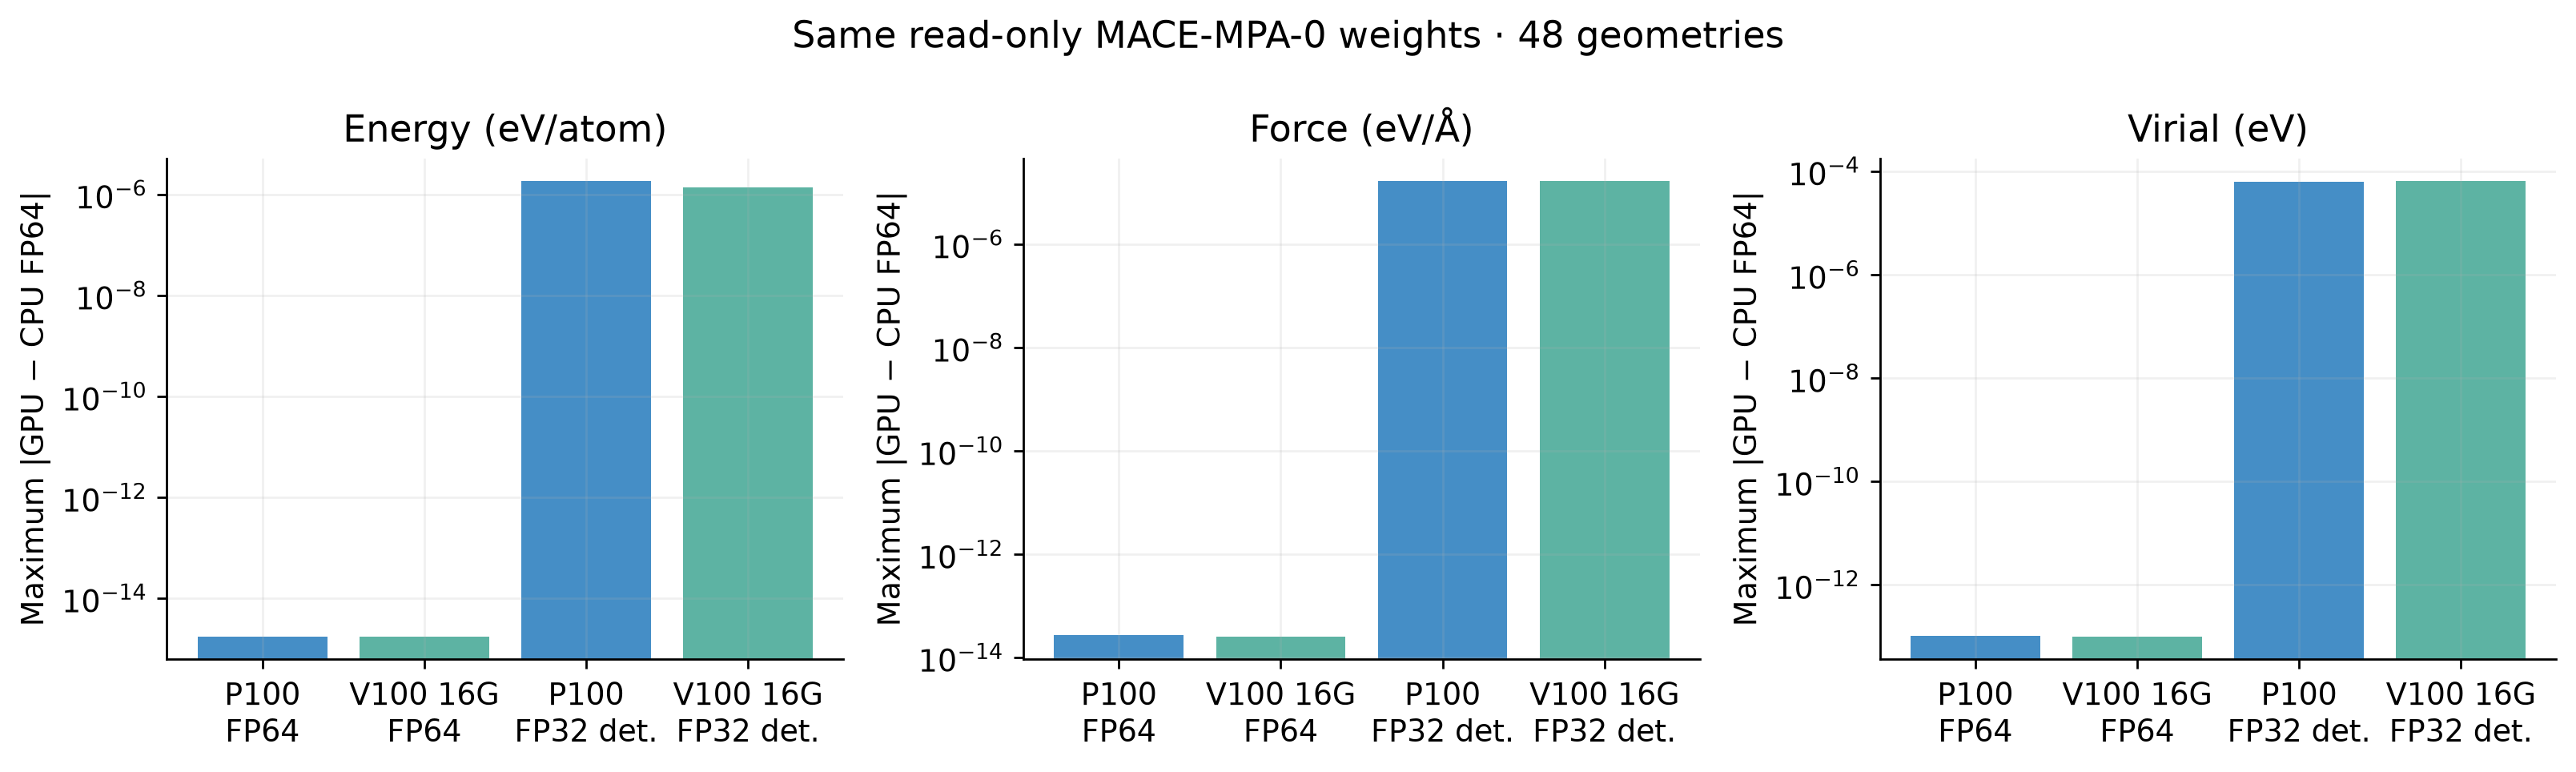
固定同一份MACE-MPA-0模型,对48个相同Si构型分别做CPU FP64、P100 FP64、V100 16G FP64及两个GPU上的确定性FP32推断。
bash run.sh
cat analysis/precision.csv
| 相对CPU FP64 | 最大能量差(eV/原子) | 最大力分量差(eV/Å) | 最大virial分量差(eV) |
|---|---|---|---|
| P100 FP64 | 1.78E-15 | 2.71E-14 | 1.04E-13 |
| V100 16G FP64 | 1.78E-15 | 2.60E-14 | 1.01E-13 |
| P100 FP32,确定性设置 | 1.83E-6 | 1.65E-5 | 6.39E-5 |
| V100 16G FP32,确定性设置 | 1.35E-6 | 1.63E-5 | 6.51E-5 |
FP32示例使用 CUBLAS_WORKSPACE_CONFIG=:4096:8 和 torch.use_deterministic_algorithms(True)。默认非确定性FP32下,两次独立前向的virial会出现约1E-5 eV的小差,不能要求每次逐位一致。这是浮点计算问题,不是重新训练的精度保证。本表是数值一致性,不是GPU加速比。
3 转换设备标签#
bash calculate.sh convert
ls work/scratch-cpu.model
助手实际调用:
mace_convert_device models/scratch64-s13.model --target_device cpu --output_file work/scratch-cpu.model
自己新训练的GPU模型可直接提交转换作业:
bash convert-new.sh work/train-scratch64-s13/models/scratch64-s13.model
这一步申请单张P100完成原生转换,输出 work/trained-cpu.model。上面的 calculate.sh convert 则演示附件现成CPU模型的转换工具。
GPU上保存的模型可能在嵌套TorchScript中保留CUDA信息。仅给加载函数加 map_location=cpu 不一定足够;需要在可以读取原模型的GPU环境中调用转换工具。这里的新文件是CPU副本,原权重保留。实际还做了CPU→CUDA→CPU往返,再在CPU对独立测试集检查E、F、应力、virial,差均小于 1E-8。
4 改精度不是改设备标签#
from mace.calculators import MACECalculator
calc = MACECalculator(model_paths="models/scratch64-s13.model",
                      device="cuda", default_dtype="float32")
这段代码应放入申请到GPU的计算脚本中。device 选择CPU/GPU,default_dtype 选择浮点精度,mace_convert_device 处理保存模型的设备信息;三者作用不同。改变为FP32后,应重新检查目标性质所需误差。
5 结果如何核对#
bash calculate.sh eval
cat work/eval-metrics.json
head -n 4 work/predictions.xyz
物理virial采用 -V × ASE应力。比较应在同一结构、相同晶胞、同一模型头和相同单位下进行。当前教程实测了CPU/P100/V100 16G推断;训练示例使用P100。可选cuEquivariance加速未用于本次结果,不把未安装的扩展当成可用功能。