
MACE从头训练与独立测试
用真实Si DFT数据训练小模型,查看损失、独立测试误差,并比较应力权重的影响。
阅读本篇目录
下载本专题输入、Si实算数据、教学模型与工具(ZIP)。先完成数据准备,并进入解压目录。附件已提供训练好的小模型,可以先评估,再自行重训。
1 先评估现成模型#
bash calculate.sh eval
cat work/eval-metrics.json
脚本调用原生 mace_eval_configs,对8个独立测试构型输出能量、力、应力和不变描述符,结果在 work/predictions.xyz。实际命令为:
mace_eval_configs --configs data/PBE-test.xyz --model models/scratch64-s13.model --output work/predictions.xyz --device cpu --default_dtype float64 --batch_size 1 --compute_stress --return_descriptors
这是上面助手内部同一条命令的展开形式,二者选一个执行即可。已有同名结果时应保留或改输出路径,再重新运行。
2 提交一次从头训练#
bash train.sh scratch64-s13
squeue -u "$USER"
助手创建 work/train-scratch64-s13/,复制配置,通过Slurm申请P100单卡运行80轮。完成后查看:
tail -n 30 work/train-scratch64-s13/slurm-*.log
ls work/train-scratch64-s13/models
新模型从GPU保存后,可在GPU作业中转换为CPU副本,再测试:
bash convert-new.sh work/train-scratch64-s13/models/scratch64-s13.model
squeue -u "$USER"
转换结束后输出 work/trained-cpu.model,保留原模型。不要在作业尚未结束时读取未写完的模型。
真正训练入口是 mace_run_train --config train.yml。完整教学配置如下;文件相对路径以 work/train-scratch64-s13/ 为起点:
name: scratch64-s13
energy_key: REF_energy
forces_key: REF_forces
stress_key: REF_stress
virials_key: REF_virials
E0s: average
model: MACE
batch_size: 4
valid_batch_size: 4
max_num_epochs: 80
default_dtype: float64
seed: 13
loss: stress
energy_weight: 1.0
forces_weight: 100.0
stress_weight: 1.0
compute_stress: true
ema: true
ema_decay: 0.99
swa: false
num_workers: 0
device: cuda
log_dir: logs
model_dir: models
checkpoints_dir: checkpoints
results_dir: results
lr: 0.01
weight_decay: 0.0
config_type_weights: '{''Si2'':1.0,''Si8'':1.0}'
r_max: 5.0
hidden_irreps: 32x0e+32x1o
num_interactions: 2
correlation: 3
max_ell: 2
train_file: ../../data/PBE-train.xyz
valid_file: ../../data/PBE-valid.xyz
energy_key 等必须与extxyz一致。E0s: average 从训练数据估计元素能量基准,不代表计算了孤立Si原子。r_max 是单层局部截断,num_interactions 是消息传递层数;它们共同影响有效感受范围。hidden_irreps 控制模型通道与等变分量。这里用小模型说明操作流程,不把80轮当作通用收敛标准。
3 看训练曲线#
bash plot-training.sh
ls work/training-plot
该工具调用原生 mace_plot_train。附件的单头绘图数值副本移除了未使用的文字字段,避免当前Pandas对文字列求平均时报错;所有数值与原训练记录一致。eval 曲线是验证集,opt 是训练批次损失,二者不要混称为独立测试误差。
4 独立测试结果怎么看#
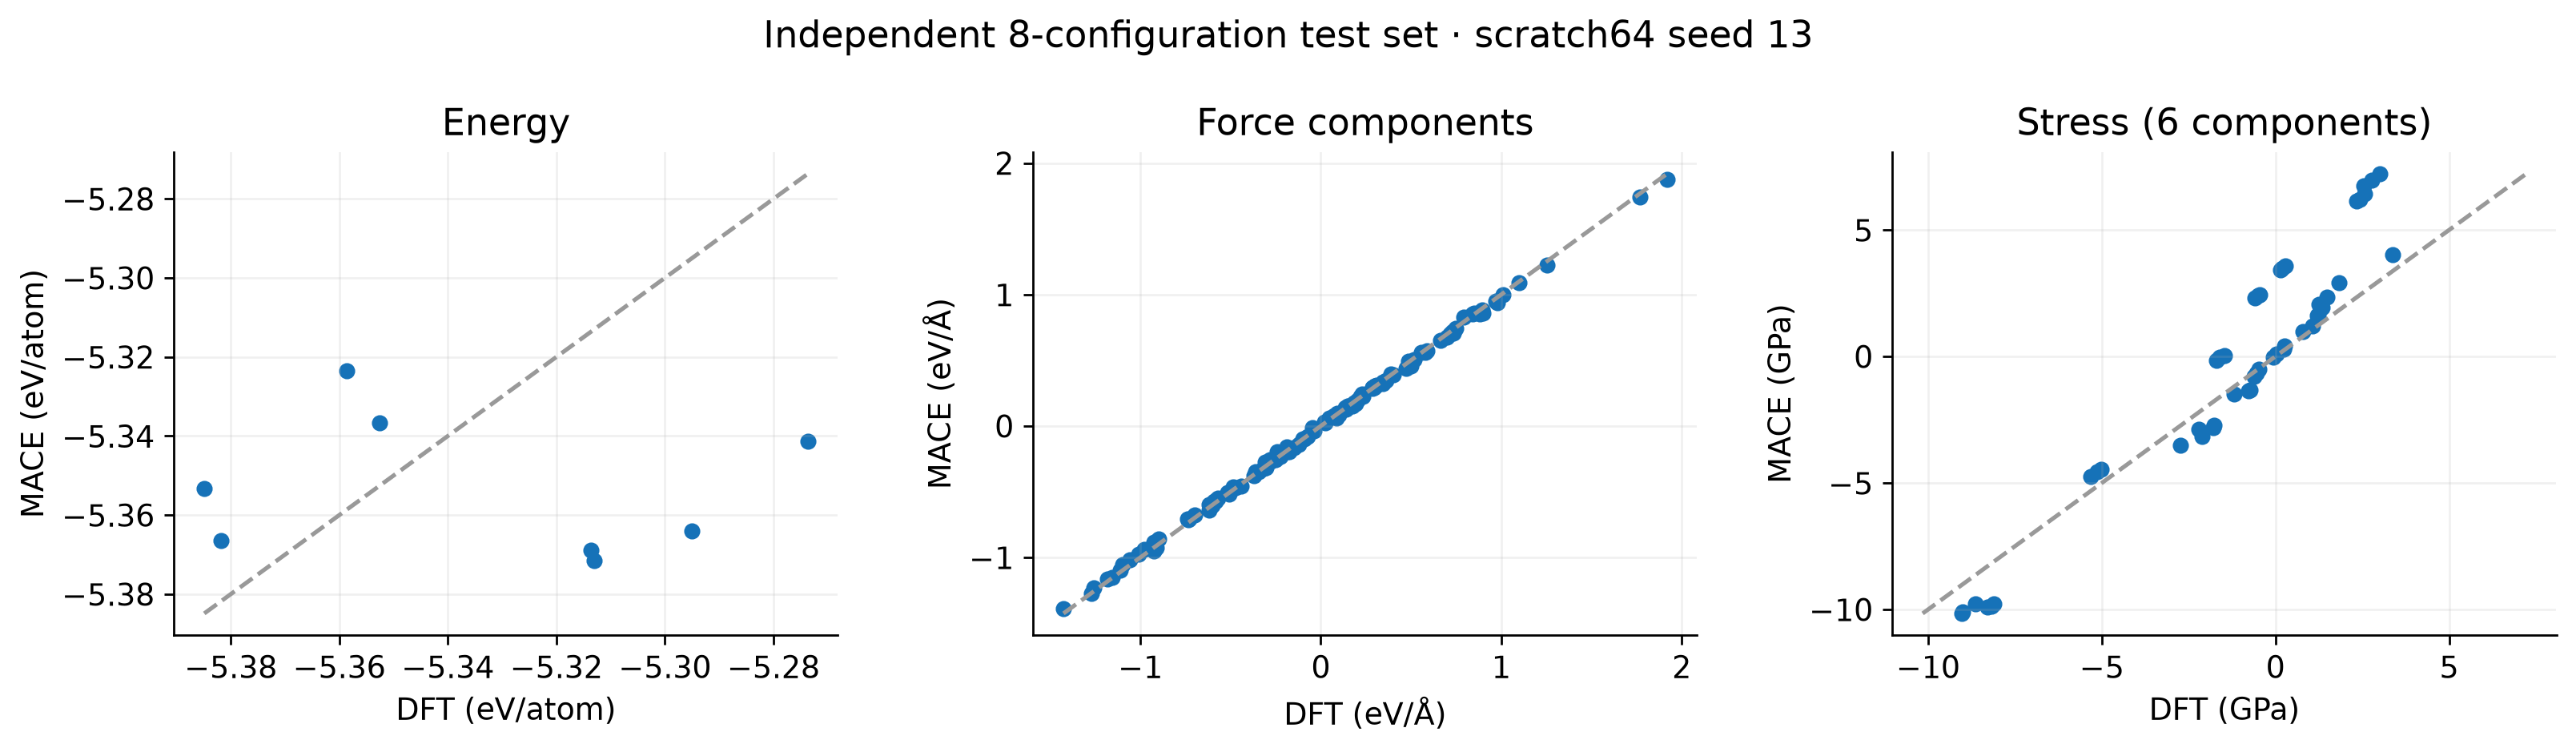
本例三个随机种子各训练80轮,使用同一个独立测试集:
| 模型 | 能量RMSE(meV/原子) | 力RMSE(eV/Å) | 应力RMSE(GPa) |
|---|---|---|---|
| FP64 seed13 | 48.107 | 0.01994 | 1.955 |
| FP64 seed29 | 43.70 | 0.01383 | 3.588 |
| FP64 seed47 | 39.74 | 0.02045 | 1.541 |
| 双P100 DDP | 41.825 | 0.01815 | 1.150 |
能量误差先除原子数再统计;力RMSE统计所有力分量;应力RMSE统计六个独立张量分量。随机种子、批次分配会影响短训练结果,双卡和单卡的权重不要求逐位一致。
bash train.sh scratch64-s29
bash train.sh distributed64
cat analysis/heldout-metrics.csv
双卡入口实际使用 torchrun 两进程、每进程一张P100,属于数据并行训练。这里没有给出短任务加速比。
5 力准,应力就一定准吗#
不一定。FP32 seed13使用应力权重1时,测试力RMSE为0.02064 eV/Å,应力RMSE却为5.374 GPa。保持数据、架构、随机种子和80轮不变,把 stress_weight 改为100,重新训练另一模型,得到能量RMSE41.819 meV/原子、力RMSE0.01998 eV/Å、应力RMSE0.4323 GPa。
bash train.sh scratch32-s13
bash train.sh scratch32-stress100
bash run.sh
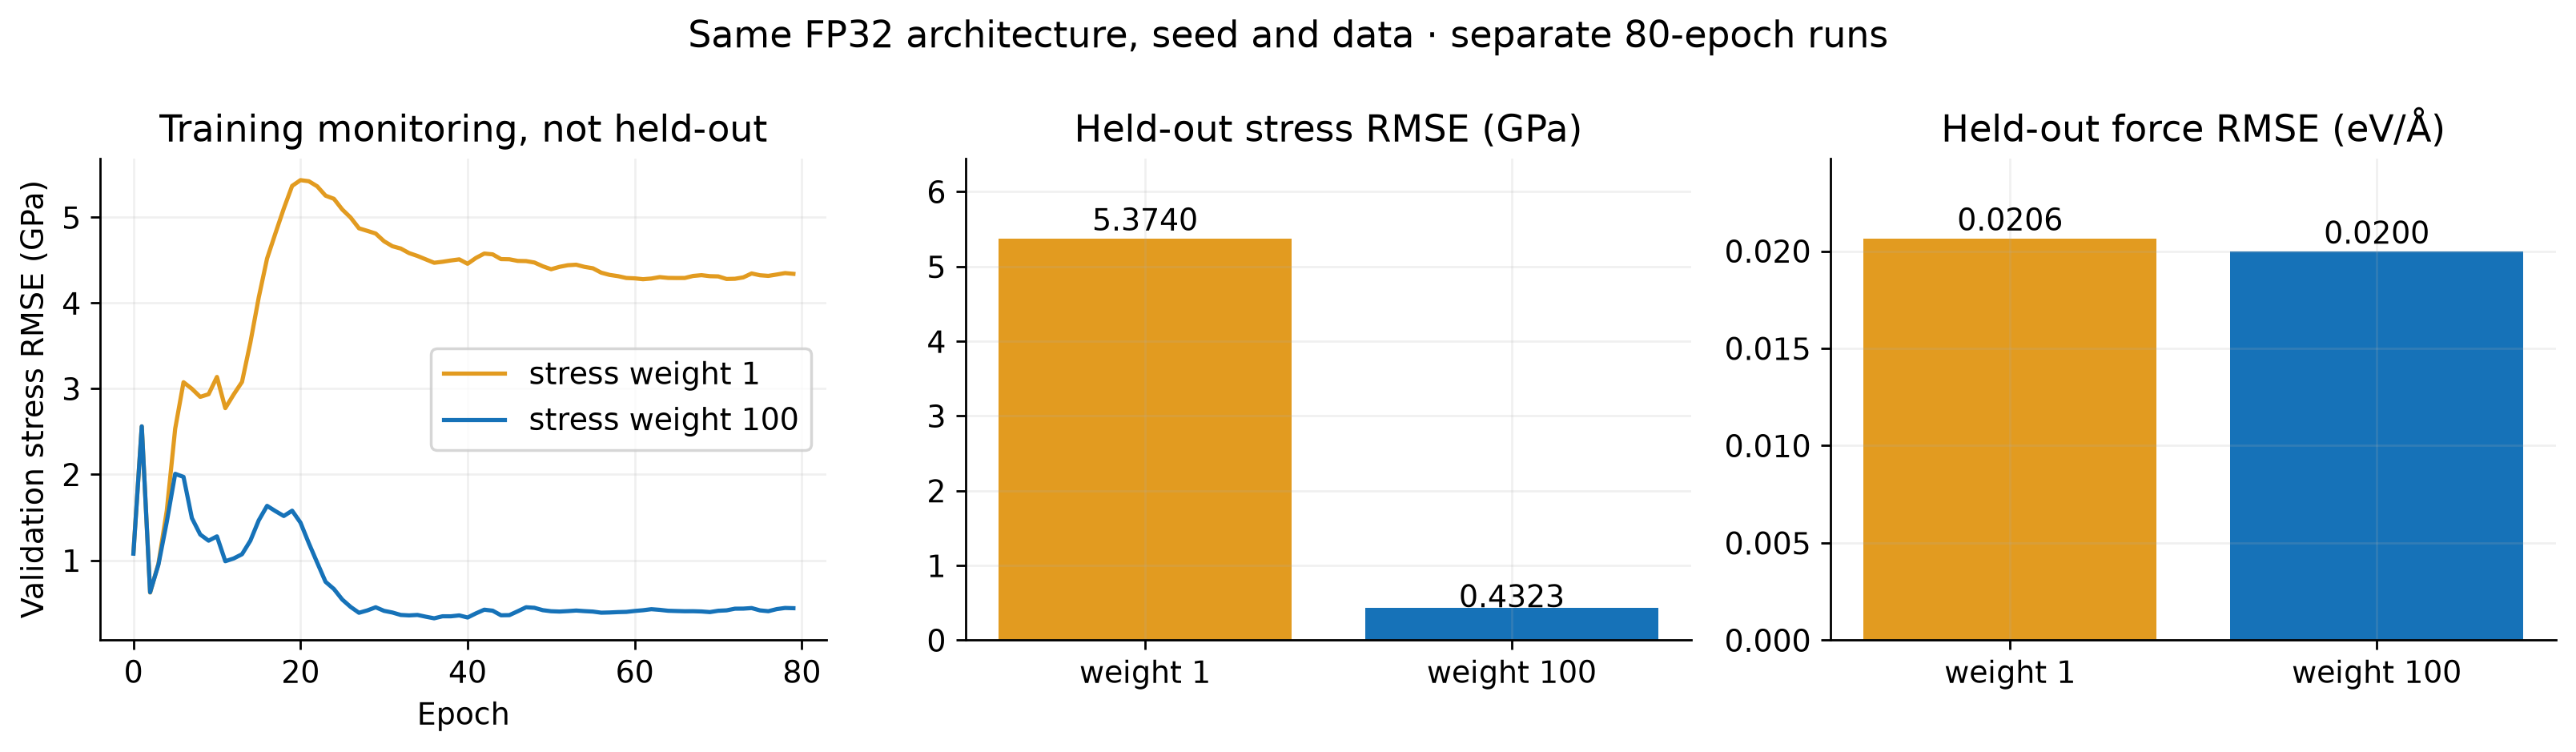
这是损失权重对照,不能解释成FP32天然比FP64更准。两个模型均保留在附件中,原模型没有被改写。需要变胞优化、NPT、弹性性质时,应力数据与应力误差尤其值得单独检查。