
DP-GEN模型偏差与候选筛选
读懂model_devi.out,运行原生比较工具,并区分委员会分歧、DFT误差与NPT稳定性。
阅读本篇目录
下载完整输入、教学模型、实算数据和操作脚本(ZIP)。本篇沿用完整循环中的四模型委员会,也可直接使用下载包中的参考模型和轨迹。
1 查看偏差文件#
head reference/md/task.000.000000/model_devi.out
head analysis/model-deviation.csv
原生文件的表头说明列含义,包括步数和virial、力的最大/最小/平均分歧。max_devi_f 是同一原子上各模型力分量的总体标准差合成三维模长,再对所有原子取最大值;不是模型预测力本身,也不是相对于DFT的误差。
对四模型预测力 F,先对模型轴计算总体标准差(分母为模型数,不是模型数−1),再对x/y/z合成。附件 compare_models.py 保留了具体计算,便于核对原生工具和LAMMPS输出的含义。
2 用多少阈值选候选#
{
  "model_devi_f_trust_lo": 0.001,
  "model_devi_f_trust_hi": 0.5,
  "fp_task_max": 4,
  "fp_task_min": 1
}
| 本例分组 | 偏差范围(eV/Å) | 实际帧数 |
|---|---|---|
| 低分歧 | 小于0.001 | 0 |
| 候选 | 0.001至小于0.5 | 43 |
| 高分歧 | 大于等于0.5 | 1 |
这是为展示筛选而选的教学阈值,不是Si或其他材料的通用推荐值。四个新标签来自候选集合;超过上限的一帧没有因为“分歧最高”就自动成为可靠训练样本。
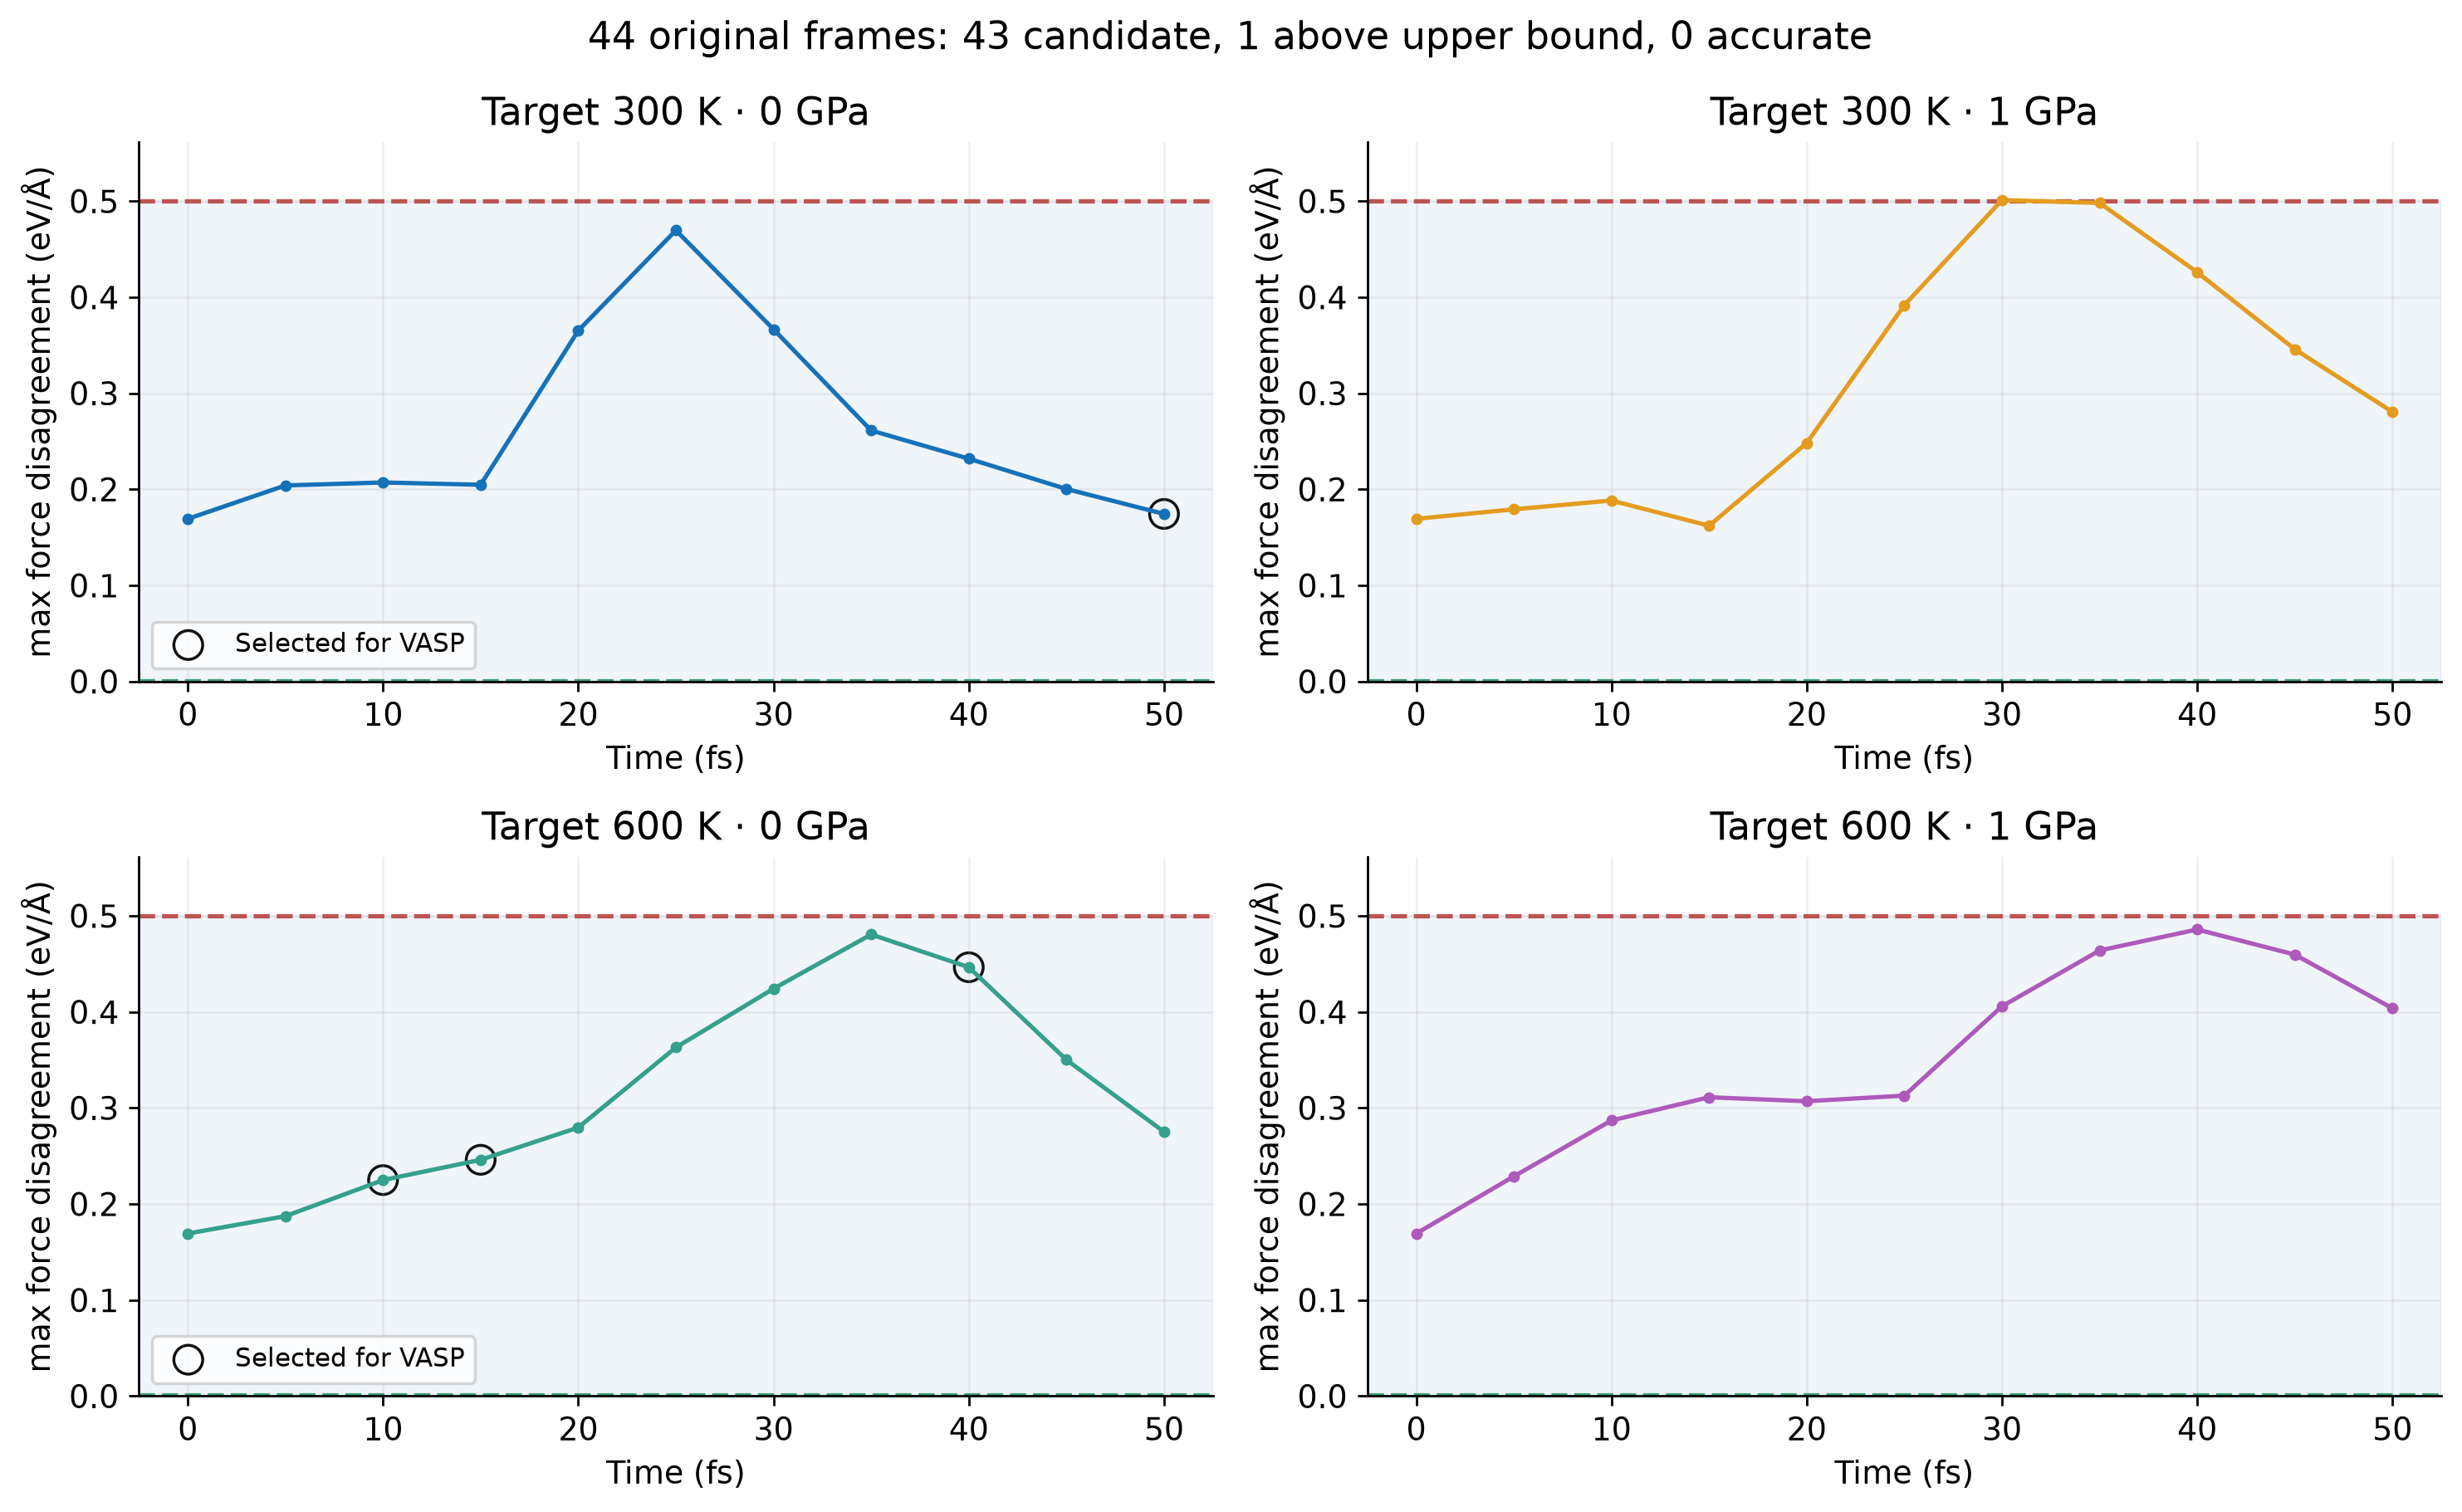
head analysis/selected-labels.csv
cat configs/param.json
每条候选的原始任务和MD步数都在数据表中。标注任务编号会经筛选排序,不能把第一个候选文本行直接当成第一个DFT任务。
3 实际运行原生model-devi工具#
bash compare.sh
bash status.sh
compare.sh 会通过Slurm计算十二个固定构型:四个MD任务各取第0、25、50步。它同时执行原生 dp --tf model-devi 和四个DeepPot推断,再用独立公式核对偏差。
cat work/model-devi-check/native-cli-devi.out
cat work/model-devi-check/RESULTS.json
cat compare_models.py
本集群P100与V10016G分别实跑;相同十二帧下,独立计算与原生LAMMPS的最大偏差差约4.87×10⁻⁸ eV/Å。下载包的短入口会申请其中一种匹配资源,不要求用户手动切换多个环境。
原始轨迹默认坐标只有六位有效数字,对截断后的坐标重新推断会与MD内部全精度坐标产生差别。附件另存独立的16位坐标输出对照,保持模型、初态和MD参数相同;两套44帧原生偏差完全一致。原轨迹和高精度对照分别保存,不把低精度文件改写成高精度“原始数据”。
4 偏差小,也可能一起预测错#
四个相似模型可能共同偏离DFT。判断可用性至少要分别看:独立测试能量/力/应力误差;探索结构是否进入训练分布之外;目标系综的稳定性。委员会分歧不能代替上述任意一项。
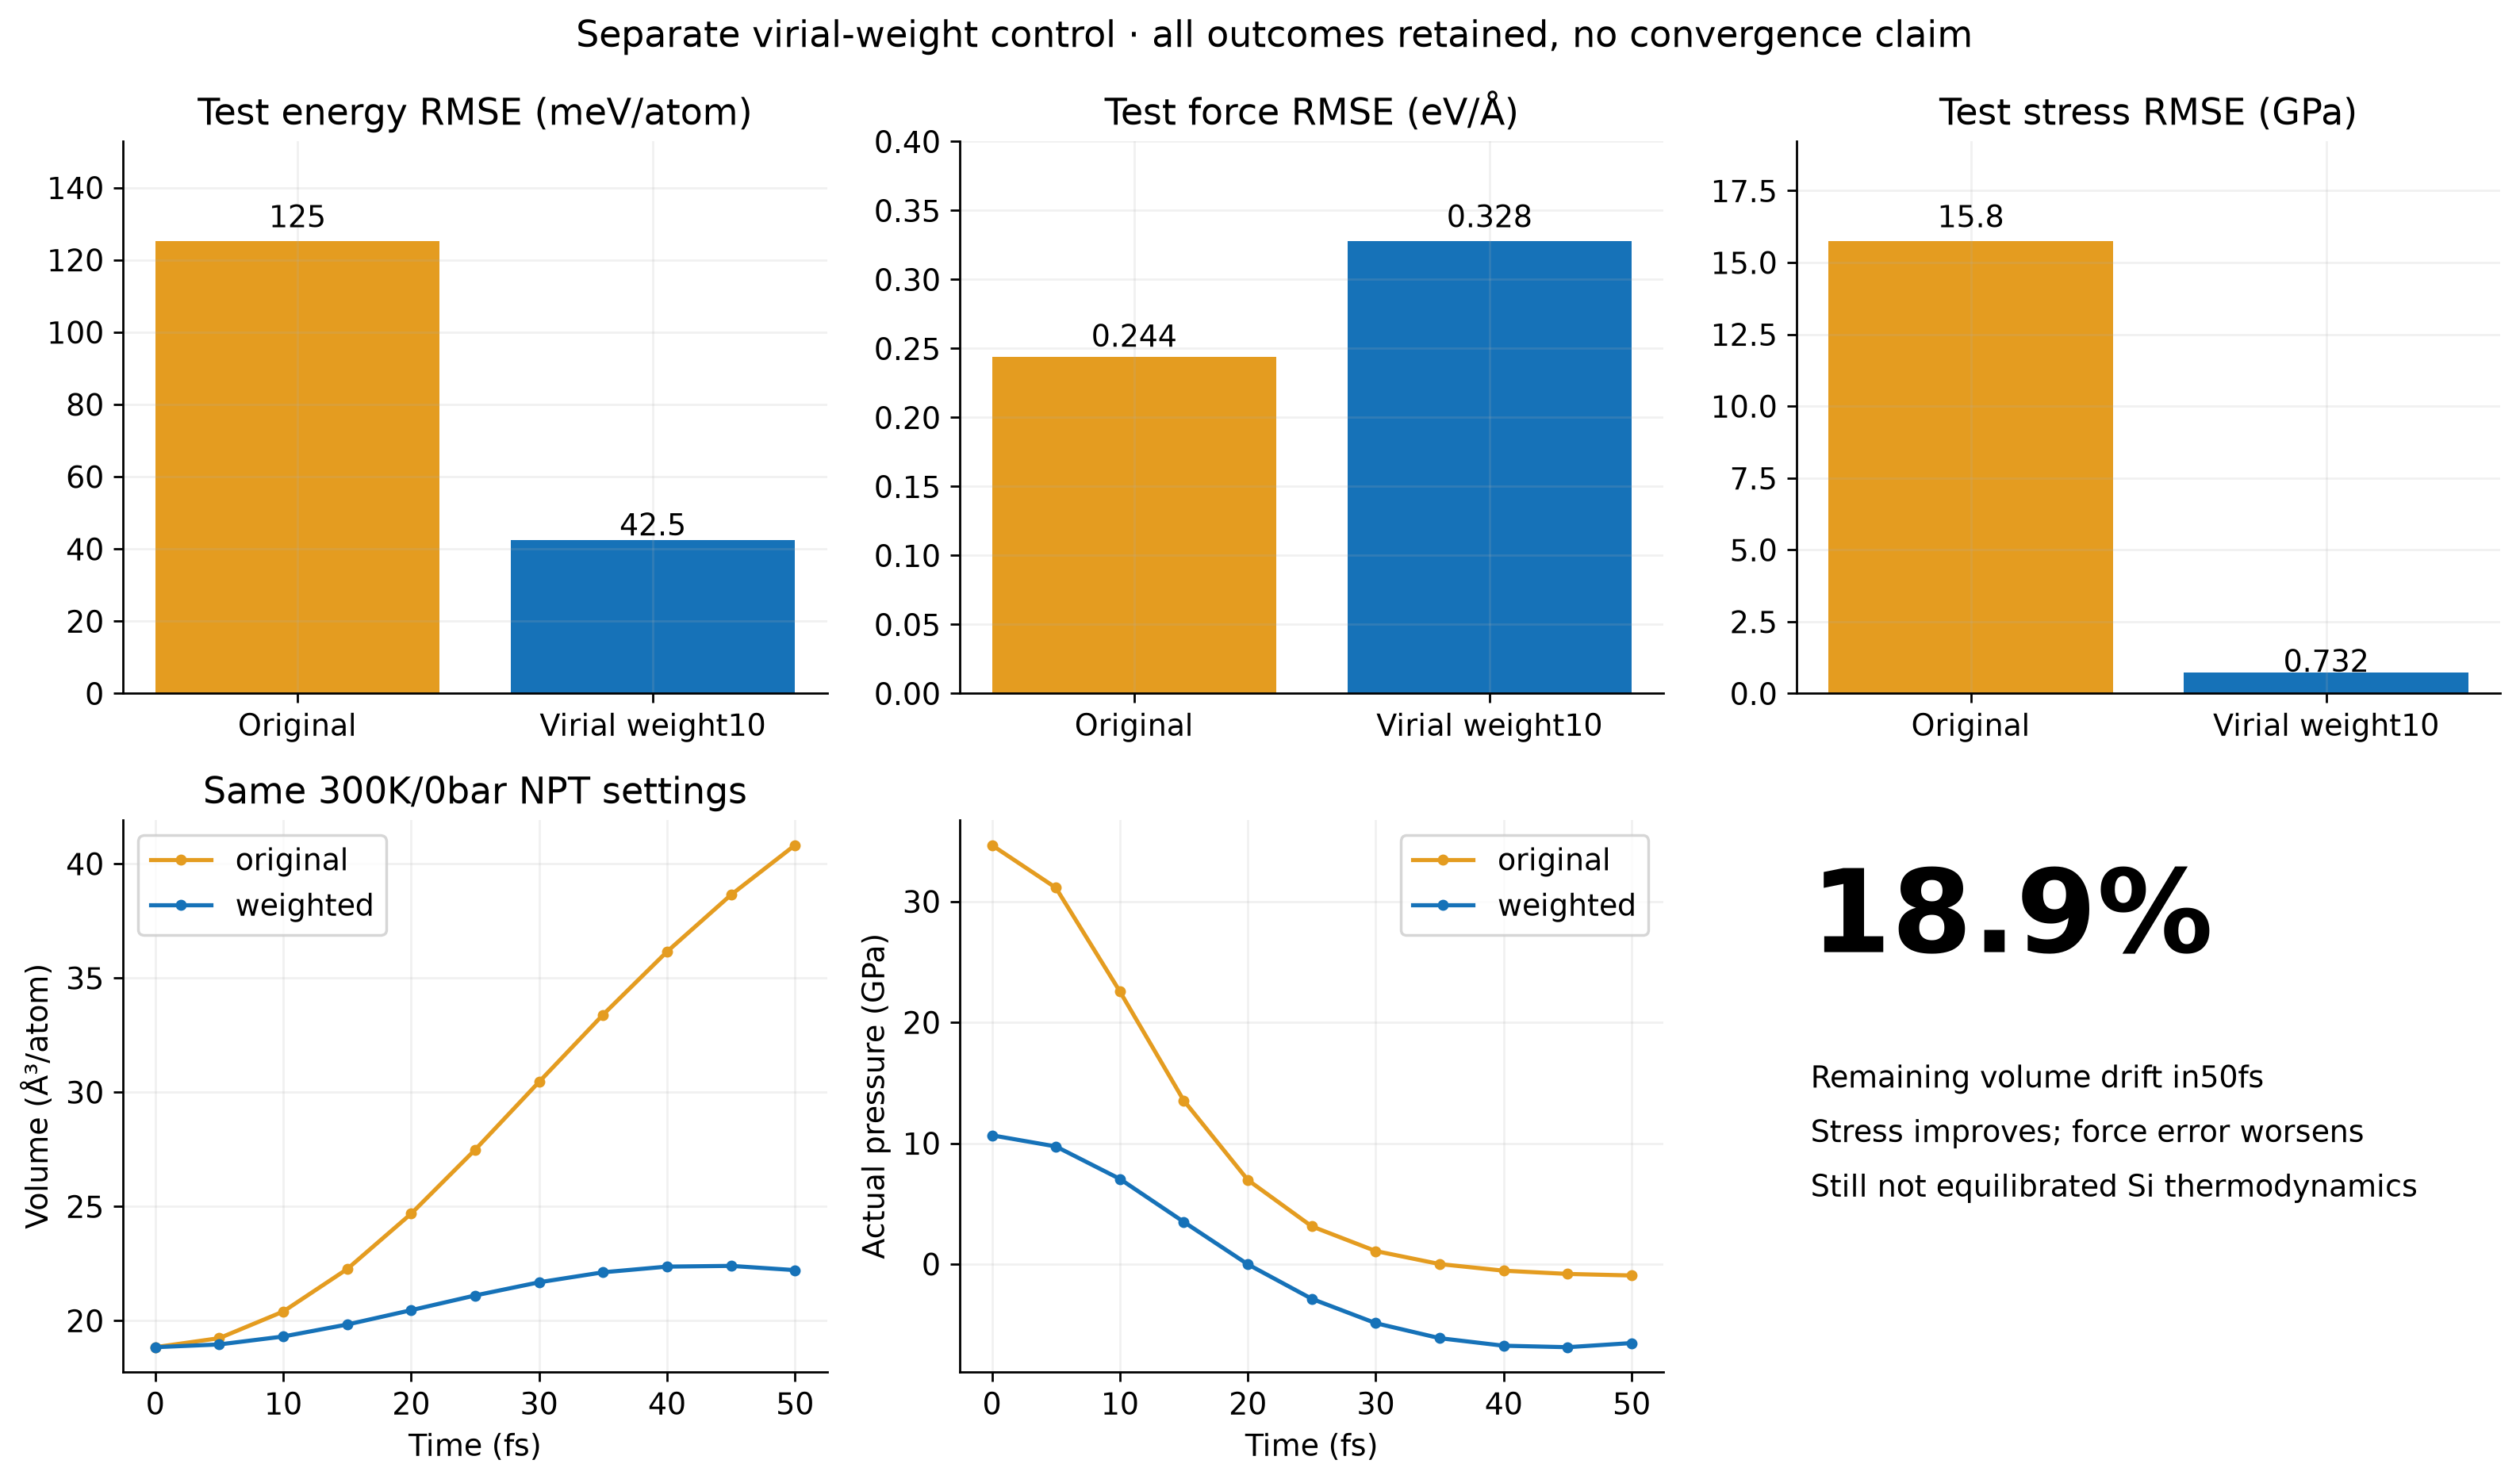
为了说明应力训练的影响,另做一项原生训练和50步NPT对照:只把virial损失的起止权重改为10,其余模型、初始训练数据和1000步训练设置保持相同。
| 独立测试指标 | 原模型0 | virial权重10 |
|---|---|---|
| 能量RMSE(meV/atom) | 125.27 | 42.47 |
| 力RMSE(eV/Å) | 0.2440 | 0.3280 |
| 应力RMSE(GPa) | 15.7538 | 0.7323 |
应力和能量变好,力变差;体积漂移从116.6%减到18.9%,依然不能用于平衡体积计算。应按目标物性平衡数据与损失权重,不能只挑改善的一列报告。参考表保留全部指标和曲线。
cat analysis/virial-weight-metrics.csv
head analysis/virial-weight-NPT.csv
ls models
附件中的九个 .pb 都来自实际训练:第一轮四个、再训练四个、一个权重对照。它们用于复现流程和理解误差,不作为生产级Si势发布。