
DP-GEN训练、探索与再训练
四模型委员会、四个温压条件、候选标注和第二轮训练的完整终端流程。
阅读本篇目录
下载完整输入、教学模型、实算数据和操作脚本(ZIP)。先完成数据准备,再从下载包根目录开始。请为完整流程预留自己的共享存储目录和计算额度。
1 准备授权赝势和工作目录#
bash prepare.sh
cat work/loop/param.json
cat work/loop/machine.json
prepare.sh 使用已部署VASPKIT 1.5.1的103入口生成授权Si POTCAR,并确认其与附件标签使用的赝势一致。POTCAR保存在自己的 private-pp/,不随下载包分发。如果赝势不匹配,应准备与自身标签一致的数据,不能为了跳过提示改校验值。
param.json 定义科学参数;machine.json 定义Slurm和各软件启动方式。模板里的 __ROOT__ 会被替换为当前解压目录。工作目录已存在时不要重复准备或覆盖,续算用原来的 workflow.sh。
2 启动完整循环#
bash workflow.sh
保持控制器会话运行,可在另一SSH窗口查看:
bash status.sh
cat work/loop/record.dpgen
原生目录按阶段产生:
work/loop/
  iter.000000/
    00.train/       四个独立模型
    01.model_devi/  四个温压条件的MD与偏差
    02.fp/          候选结构、DFT输入和新标签
  iter.000001/
    00.train/       加入新标签后的四个模型
  record.dpgen     已完成阶段记录
本例每个模型各占一张GPU,四个模型是独立训练任务;没有把四张卡合成一个模型的分布式训练。MD、DFT也各自提交单卡任务。实际是否立即并发由队列空闲资源决定。
3 四个模型怎么训练#
{
  "numb_models": 4,
  "train_backend": "tensorflow",
  "model_format": "pb",
  "model": {
    "type_map": ["Si"],
    "descriptor": {
      "type": "se_e2_a", "sel": [64],
      "rcut_smth": 0.5, "rcut": 4.5,
      "neuron": [8, 16, 32], "axis_neuron": 4,
      "precision": "float64"
    },
    "fitting_net": {"neuron": [32, 32, 32], "precision": "float64"}
  },
  "training": {"numb_steps": 1000, "disp_freq": 100, "save_freq": 1000}
}
上面是阅读用参数摘要,完整层级在 configs/param.json 的 default_training_param,不要把摘要直接覆盖完整文件。四个模型使用相同32帧训练数据和不同随机初始化,8帧验证数据用于监测,8帧测试独立保存。
cat work/loop/iter.000000/00.train/000/input.json
tail work/loop/iter.000000/00.train/000/lcurve.out
ls work/loop/iter.000000/00.train/graph.*.pb
训练损失同时含能量、力和virial。本例能量权重0.02→1,力1000→1,virial 0.02→0.1;1000步仅为短流程演示,不能作为任何材料的通用训练长度。
4 在哪些条件下探索#
{
  "model_devi_dt": 0.001,
  "model_devi_jobs": [{
    "sys_idx": [0], "temps": [300, 600], "press": [0, 10000],
    "trj_freq": 5, "nsteps": 50, "ensemble": "npt",
    "taut": 0.1, "taup": 0.5
  }]
}
metal 单位下时间为ps,0.001 ps=1 fs;50步只有50 fs。压力为bar,10000 bar=1 GPa。两个温度乘两个压力共四个任务,含第0步各存11帧,共44帧。
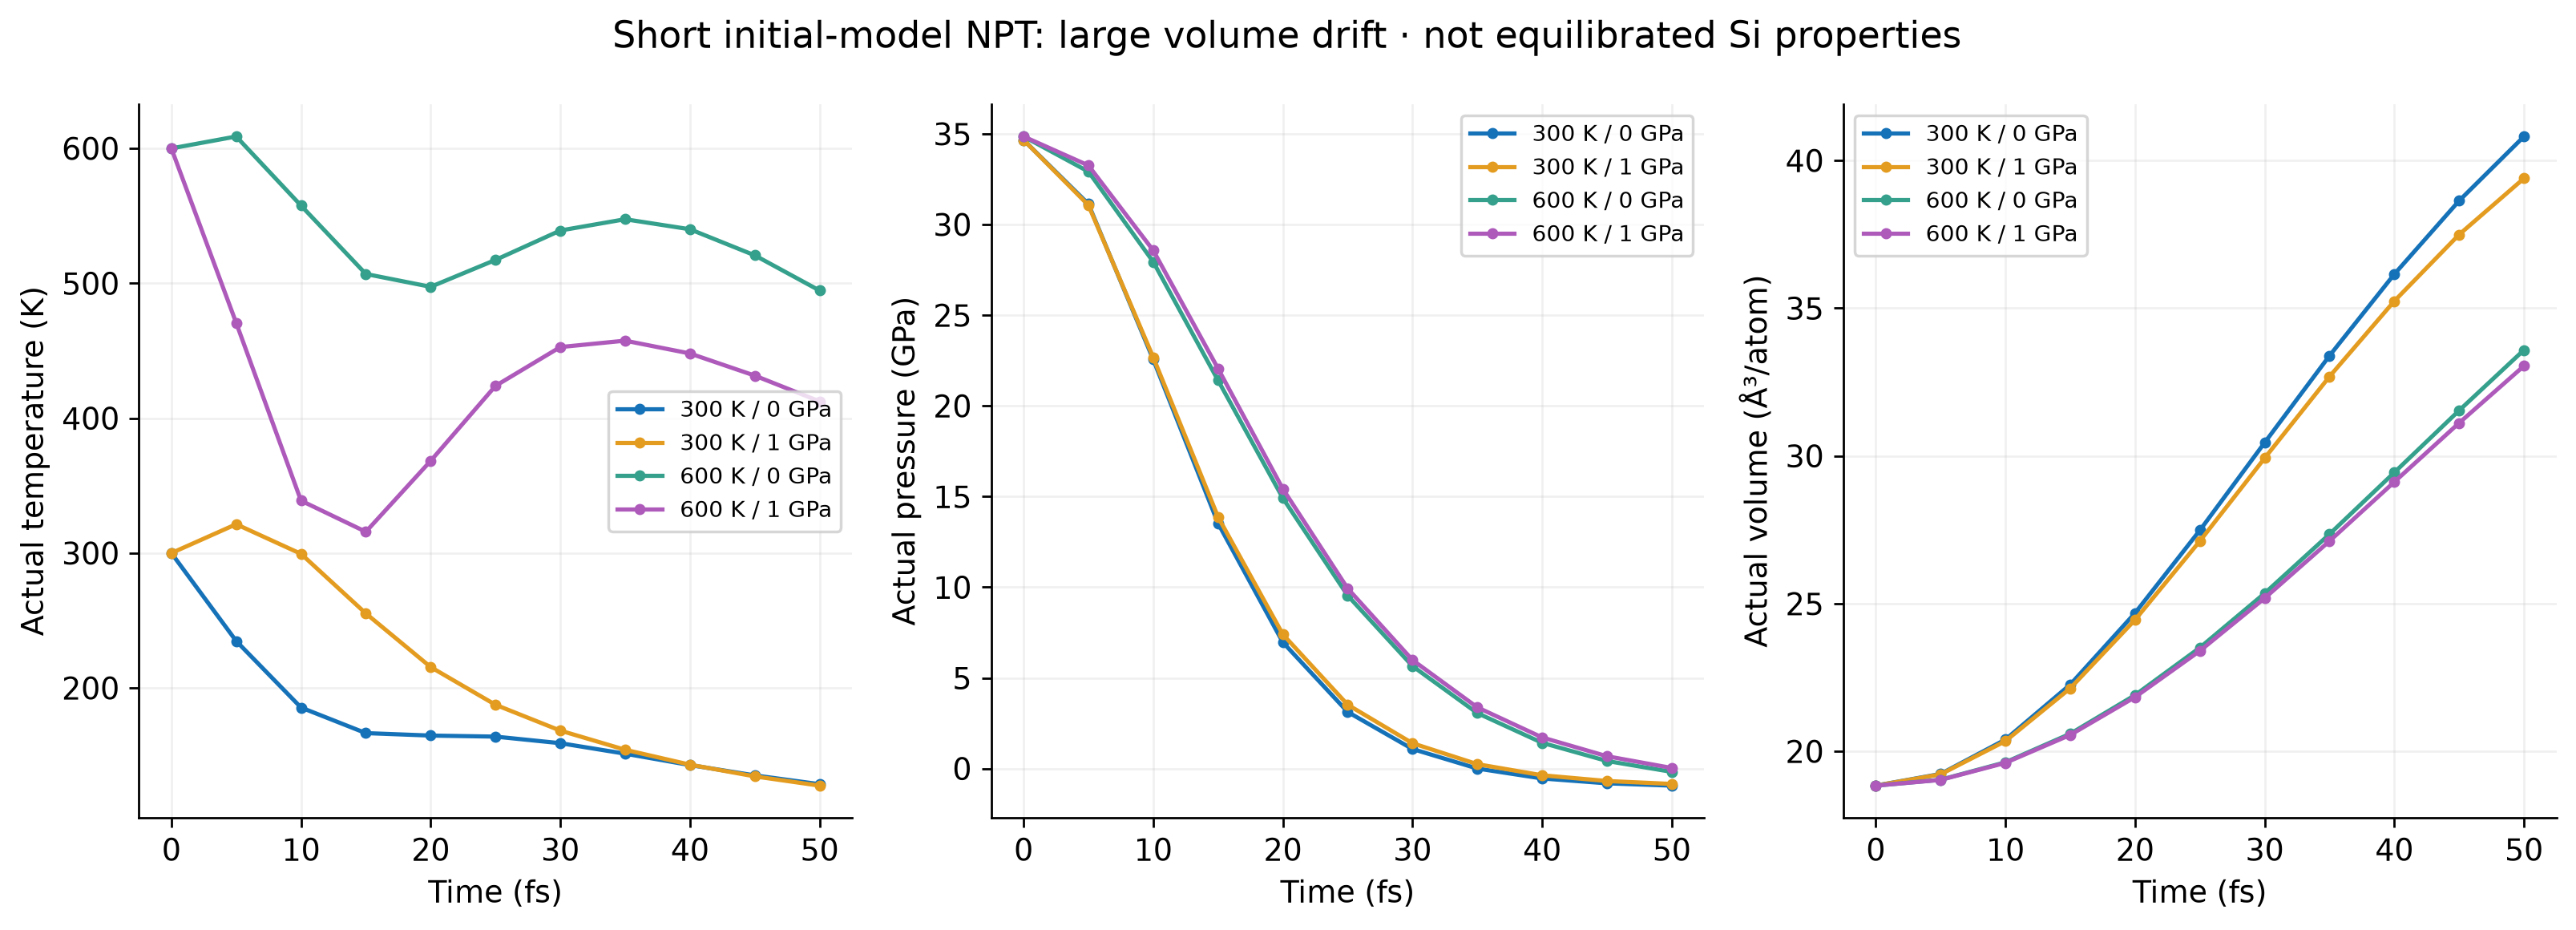
目标温度、压力只是控制参数,不能当成已经达到的物理状态。本例原始模型在一条轨迹中体积从150.71增至326.50 ų,初始压力约34.66 GPa;这说明它还不适合NPT物性研究。更多训练和应力数据应在开展生产模拟前补齐,并用独立结构检查。
5 候选标注后发生什么#
本次44帧按给定偏差阈值分出43个候选、1个超过上限、0个低偏差。程序从候选中选四帧做VASP单点,然后把四个新标签加入下一轮训练:32→36个训练构型;验证和测试不扩充、不混入训练。
ls work/loop/iter.000000/02.fp
find work/loop/iter.000000/02.fp -name energy.npy
tail work/loop/iter.000001/00.train/000/lcurve.out
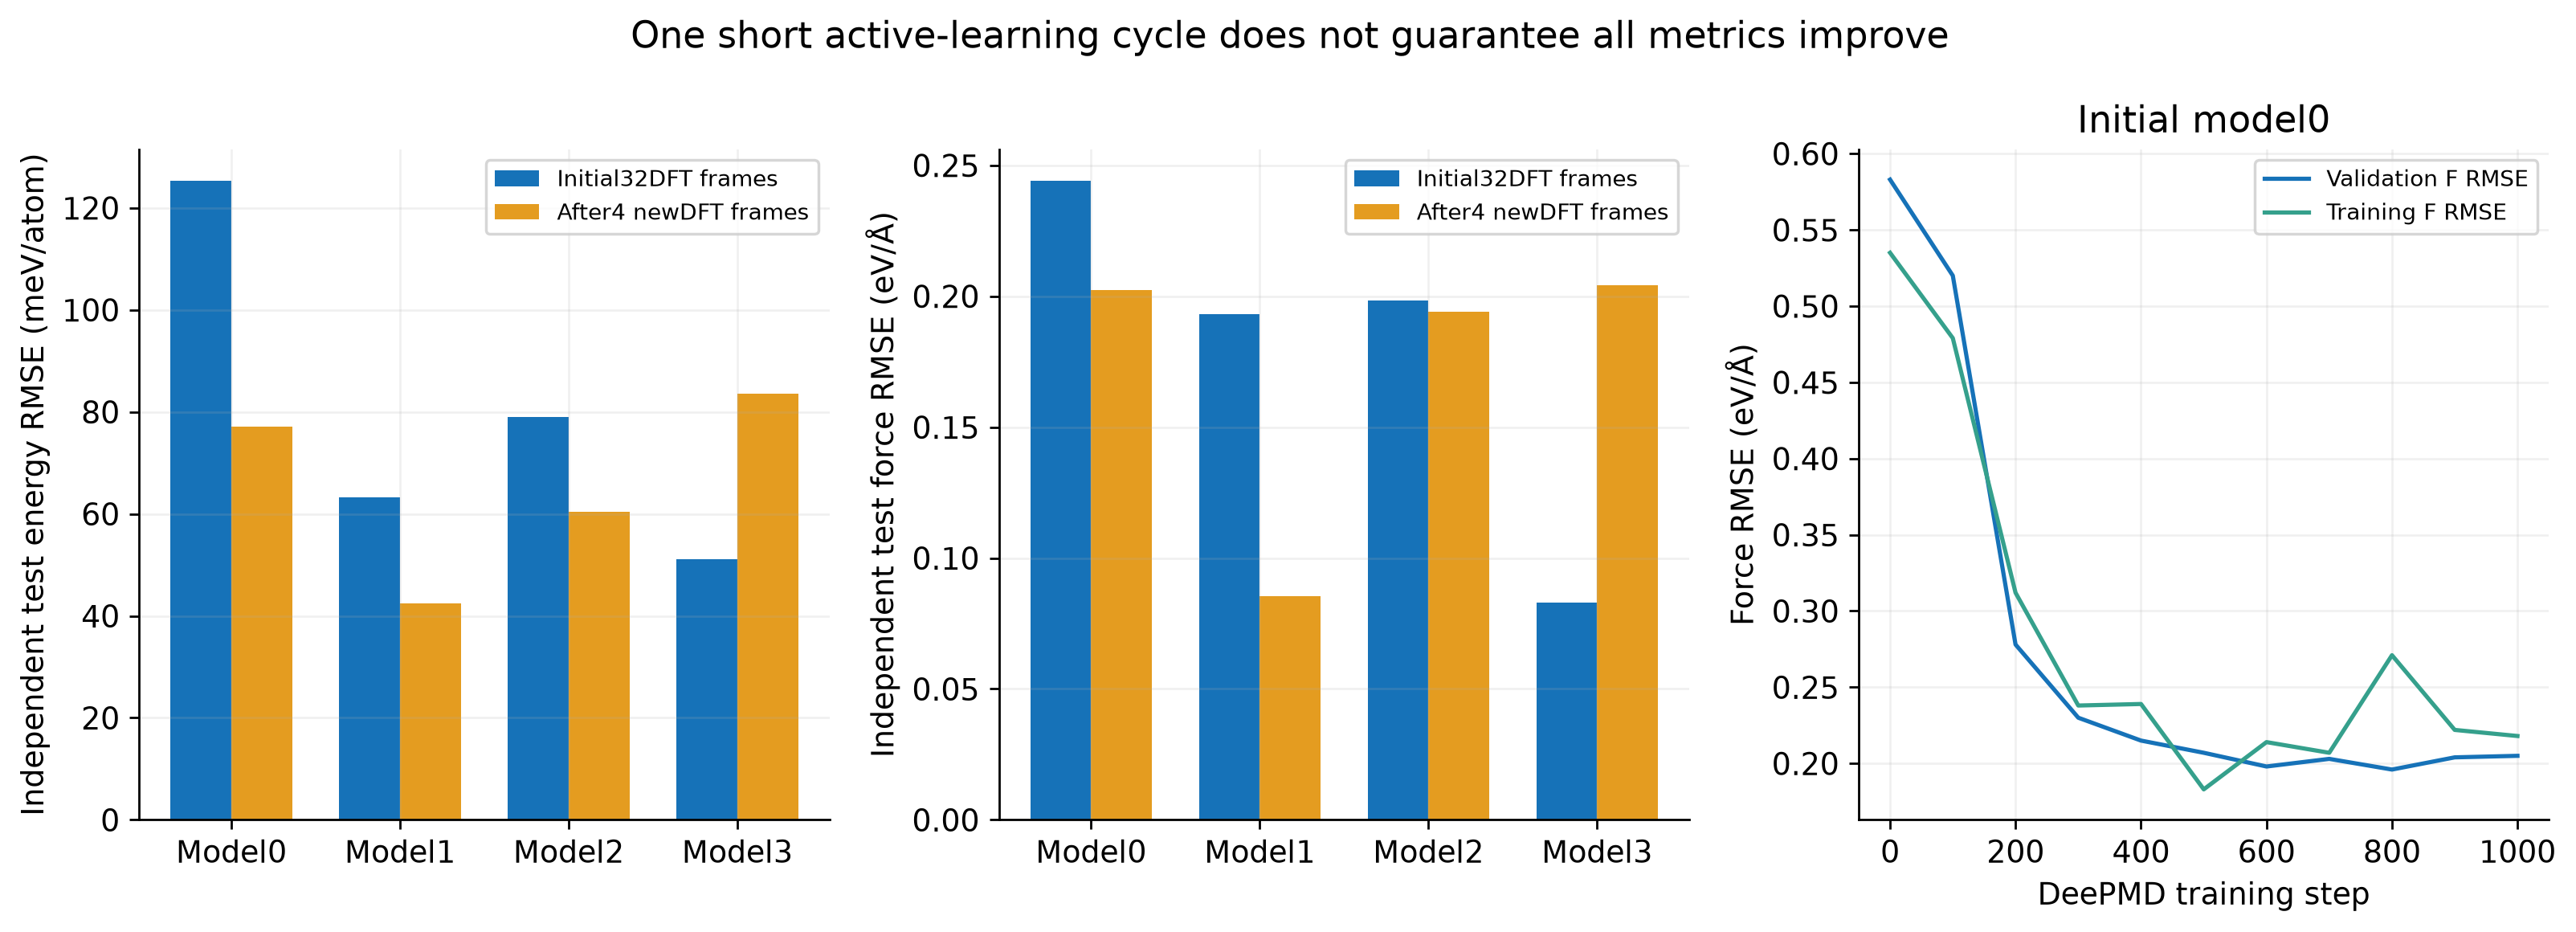
原模型0的测试能量RMSE约125.27 meV/atom、力0.2440 eV/Å;加入四个标签后约77.12 meV/atom和0.2025 eV/Å。模型3的两项误差却变差。主动学习的一次迭代不保证所有模型、所有指标单调改善,应同时检查所有模型与测试指标。
本例只配置了一轮MD探索,随后再训练即停止。这是配置的流程结束,不能表述为模型收敛。扩大体系、温压范围或组分时,应重新制定探索与独立测试计划。参数手册解释了各阶段参数。