
DP-GEN查看任务与断点续算
用短命令查看队列、定位阶段、修复输入并从原生记录继续,避免重复提交。
阅读本篇目录
下载完整输入、教学模型、实算数据和操作脚本(ZIP)。本篇配合完整循环使用。控制器、调度器和科学程序是三个不同层次;先确认任务处在哪一层,再决定等待、修复还是续算。
1 查看当前阶段和自己的任务#
bash status.sh
cat work/loop/record.dpgen
squeue -u "$USER"
status.sh 汇总本工作目录已提交的作业及Slurm状态,不扫描其他用户目录。PENDING 表示排队,RUNNING 表示计算中,COMPLETED 表示程序正常退出;科学结果仍要检查SCF收敛、数据数量和独立误差。
ls work/loop/iter.000000
ls work/loop/iter.000001
tail work/loop/iter.000000/00.train/000/lcurve.out
record.dpgen 中两列是迭代与阶段编号。正常短例从第一轮训练开始,经过探索与DFT标注,到第二轮训练结束。本次只有一组探索条件配置,最终停止不等于势函数已经达到可用精度。
2 中断后怎么继续#
确认同一目录没有另一个控制器仍在运行,再从原目录执行:
bash workflow.sh
脚本让原生DP-GEN按记录和DPDispatcher状态继续;不删除已完成计算、不清空工作目录、不重新运行 prepare.sh。本集群实际完成后再次执行这个入口,新增Slurm作业为0,已有模型与数据保留。
cat work/loop/COLD-RESUME.json
bash status.sh
COLD-RESUME.json 是附件入口给出的简短摘要;实际阶段依据仍是原生 record.dpgen 和任务结果。不要手动把记录改成“已完成”来跳过失败步骤。
3 训练阶段:先确认后端和模块#
cat launchers/run-dp.sh
cat work/loop/machine.json
head work/loop/iter.000000/00.train/000/input.json
本例为TensorFlow .pb 模型,启动命令包含 --tf。DeePMD 3默认后端与当前模块的可用后端可能不同,省略该标志可能在训练开始前就报错。应修正自己目录中的启动设置,再从原阶段续算;不要为解决启动参数问题重复计算DFT数据。
脚本各阶段分别装载DeePMD、LAMMPS、VASP。MD使用 lammps/22Jul2025_update6-deepmd-3.2.0-source-p100-gpu,不能随意改成没有对应DeePMD接口的普通LAMMPS版本。
4 DFT阶段:区分输入、计算与读取问题#
ls work/loop/iter.000000/02.fp
cat inputs/INCAR.fp
cat inputs/abacus/INPUT
输入关键字报错要先改对应程序的输入;SCF未收敛要检查电子步、混合和结构;如果SCF已经完成,只是旧读取器不识别新输出格式,应处理读取接口,保留已有计算。CP2K 2026的读取适配就是最后一种情况。
ABACUS与CP2K的独立示例入口也会先生成自己的输入并提交Slurm:
bash backend.sh abacus
bash backend.sh cp2k
这两个入口用于首次运行独立后端示例,不作为删除重跑主循环的办法。已有输出先检查 work/backend-*/RESULTS.json,避免无必要地重复SCF。
5 最后应该拿到什么#
ls work/loop/iter.000001/00.train/graph.*.pb
find work/loop/iter.000000/02.fp -name energy.npy
bash run.sh
ls figures
ls analysis
完整流程产生四个再训练模型和四帧新的VASP标签;参考绘图入口产生六张图、七张表。重画附件参考图不会自动替你评估自己新训练的模型;新运行结果保留在 work/,应针对自己的独立测试集另行计算误差。
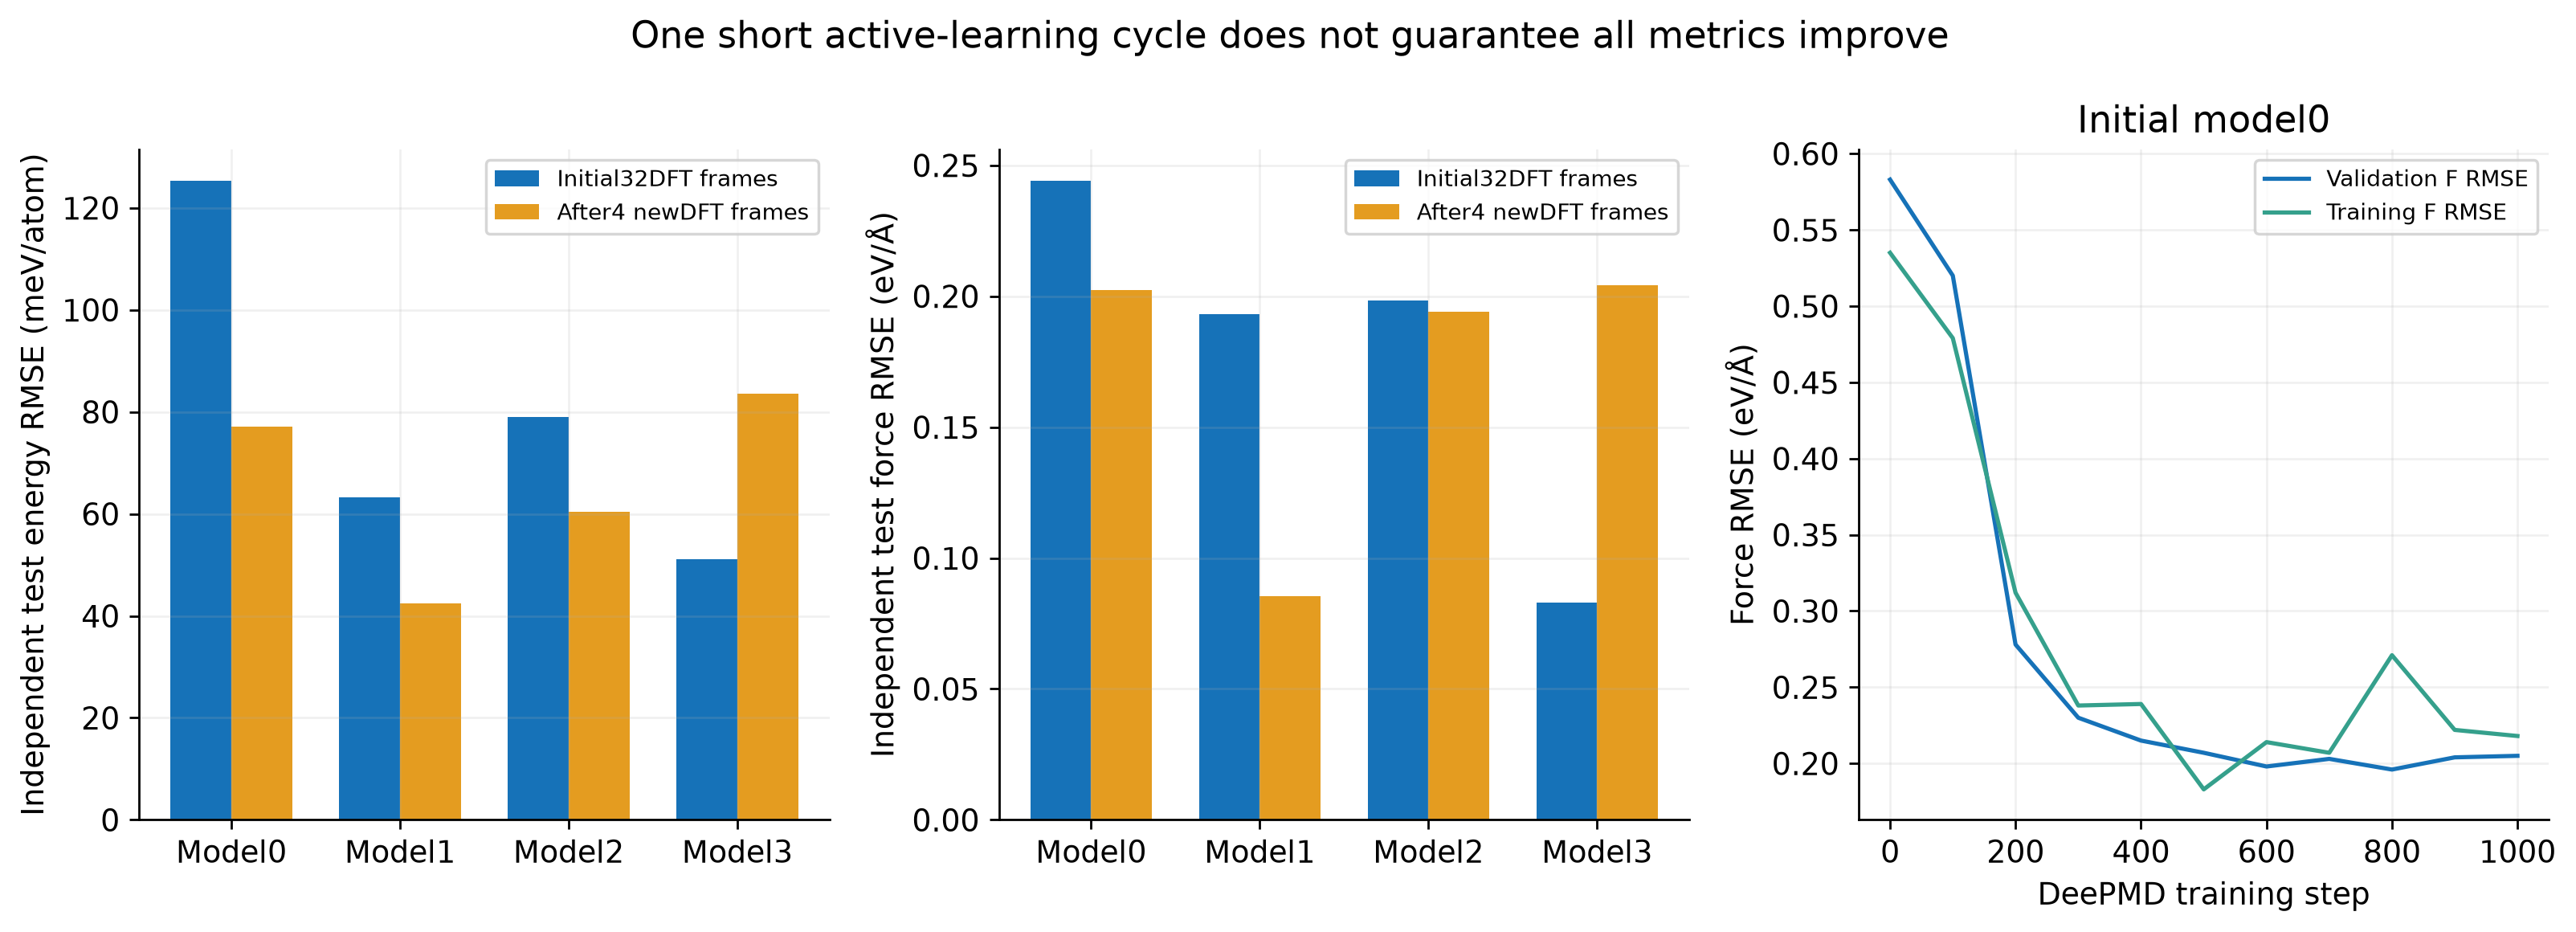
本教程没有展示多组分探索、所有DP-GEN命令或所有后端组合。换体系时请明确元素映射、质量、标签口径、训练/测试拆分和探索范围,再用小任务检查输入与数据转换。机器配置说明可用于设置自己的Slurm资源。