
PFD-kit蒸馏:从教师标签到小学生势
真实44帧教师标签、SE学生输入,以及4000与16000步预算的对照。
阅读本篇目录
下载输入、五个参考模型、真实数据与短命令脚本(ZIP)。蒸馏让较小网络学习教师模型的预测。它节省的是新增标签来源与模型推理成本的机会,质量和速度仍需实际测量。
1 教师标签来自哪里#
本例先把原32个训练几何去掉旧DFT标签,用微调教师重新计算能量、力与应力。随后以该教师再做300/600 K各0.1 ps探索,从42帧中选12帧并预测标签。
cat work/distill.json
cat work/DISTILL-INITIAL-TEACHER-LABELS.json
find work/distill-init-labels -name '*.extxyz'
总共44帧教师标签,学生训练使用32+9=41帧,三个新MD点作内部检查。这一步新增DFT次数为零。外部八帧DFT仍保留用于评价。
2 学生网络与完整训练输入#
SE学生的描述符层为4/8/16、拟合网络16/16,截断4.5 Å、邻居上限64,使用float64。查看完整模板:
cat configs/student-train.json
cat work/student-train.json
主要模型设置:
{
  "type_map": [
    "Si"
  ],
  "descriptor": {
    "type": "se_e2_a",
    "sel": [
      64
    ],
    "rcut_smth": 0.5,
    "rcut": 4.5,
    "neuron": [
      4,
      8,
      16
    ],
    "resnet_dt": false,
    "axis_neuron": 4,
    "precision": "float64",
    "seed": 449543222
  },
  "fitting_net": {
    "neuron": [
      16,
      16
    ],
    "resnet_dt": true,
    "precision": "float64",
    "seed": 507277234
  }
}
损失包含能量、力和总virial,文件中分别用pref_e、pref_f、pref_v设置随学习率变化的权重。它们控制拟合侧重,不能把训练损失直接当成压力GPa或生产精度。
3 为什么附件默认16000步#
我们保留了原4000步短预算学生,并用相同网络、相同标签、相同随机种子做16000步预算对照。学习率衰减随总预算变化,因此它是预算和相应衰减过程的比较,不声称逐步等同于未中断的同一训练轨迹。
| 模型 | 外部E / eV·atom⁻¹ | 外部F / eV·Å⁻¹ | 外部压力张量 / GPa |
|---|---|---|---|
| 微调教师 | 0.050971 | 0.142766 | 2.172793 |
| 学生4000步 | 0.107738 | 0.398967 | 10.956555 |
| 学生16000步 | 0.050935 | 0.140930 | 2.196859 |
短预算模型能运行,但精度明显较差。增加训练预算后,本例学生接近教师的能量、力和压力误差。附件完整新算采用16000步,4000步模型作为参考对照保留。
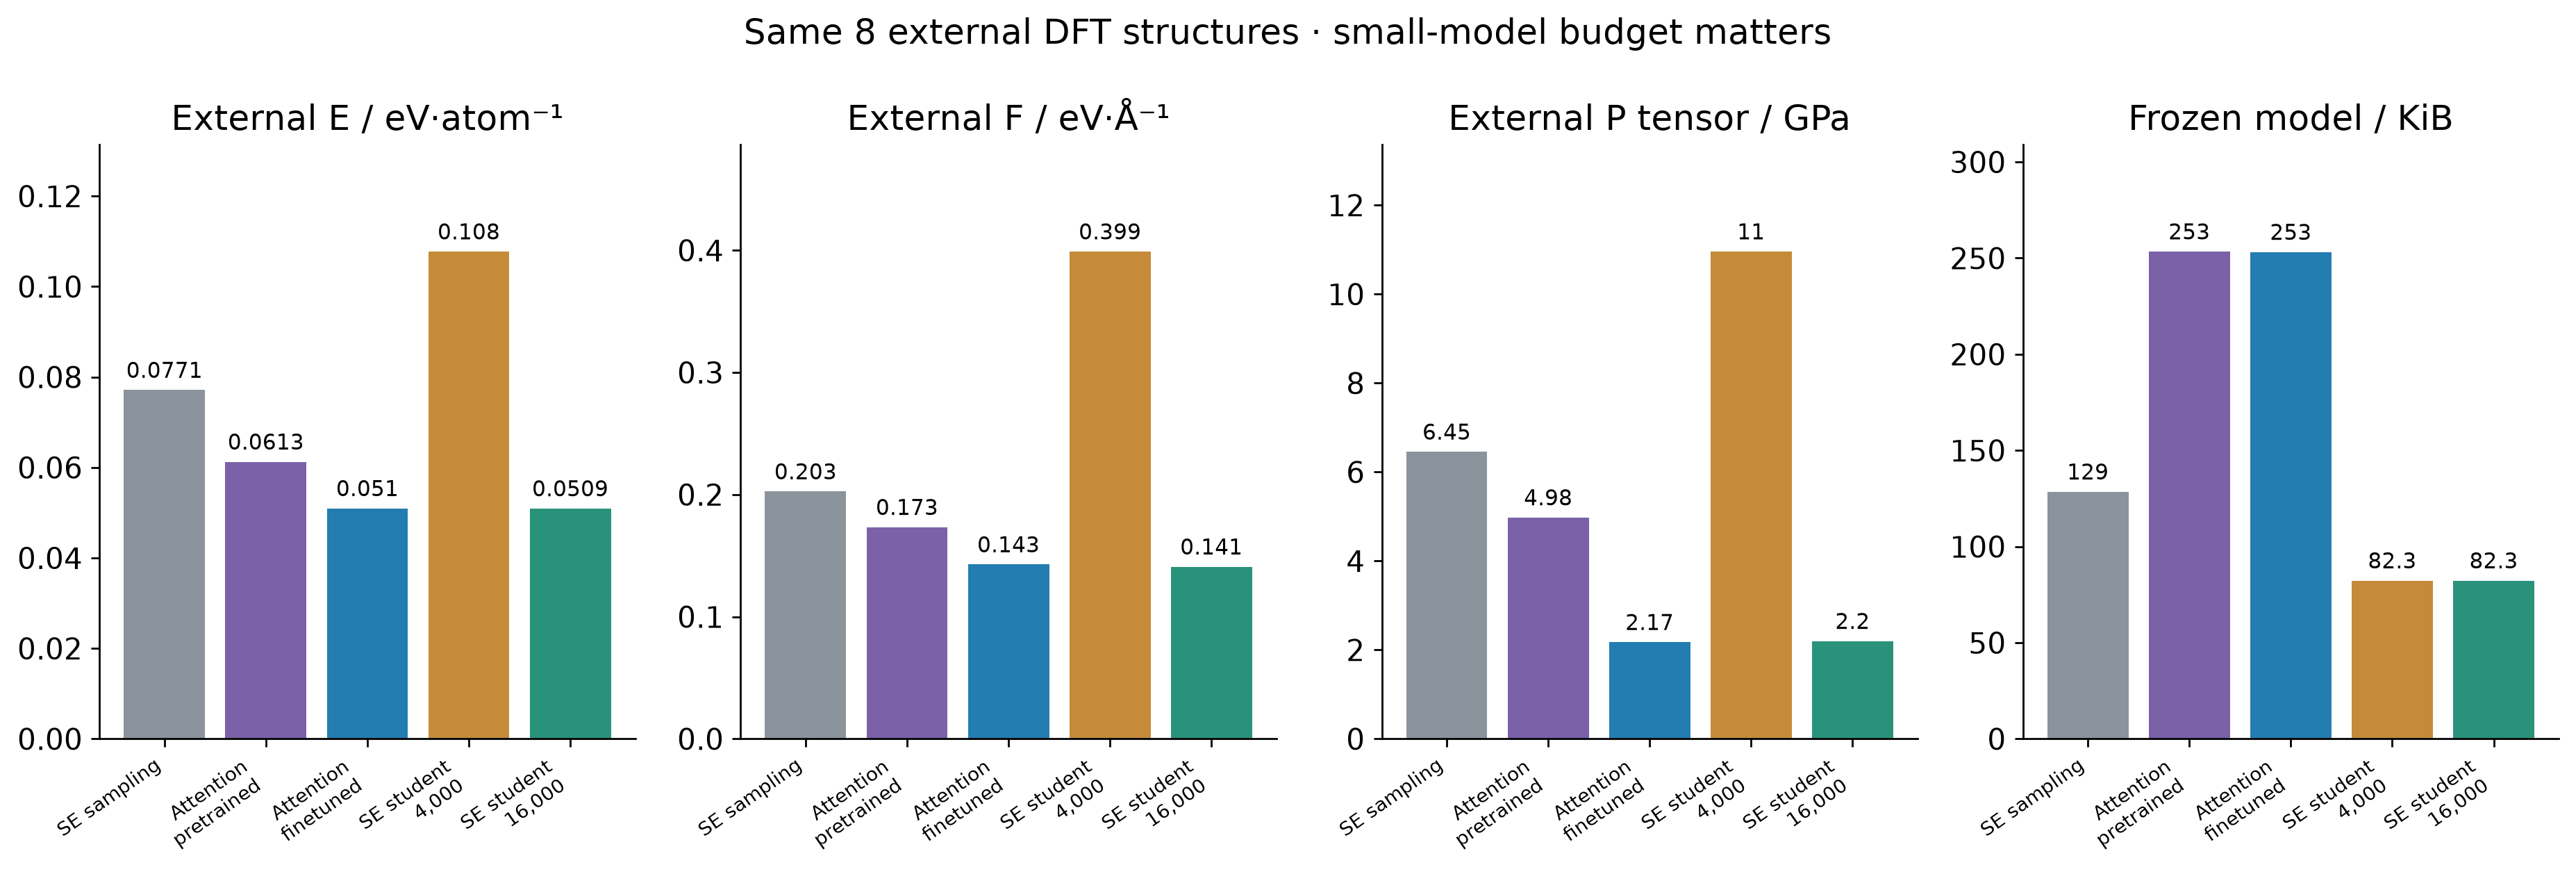
模型文件更小不自动等于目标体系更快;本图文件大小是实际字节数,没有把它当成性能加速比。
4 自动完成后拿到学生势#
首次准备和提交:
bash prepare.sh
bash calculate.sh
bash status.sh
如果已经提交,后续只查询状态。结束后:
find work/final-distill/model -name '*.pb'
bash evaluate.sh
cat work/OWN-MODEL-ERRORS.json
这份pb是DeePMD TensorFlow模型,不是GPUMD的nep.txt,不能只改后缀就交给另一种势接口。实际接入LAMMPS或ASE时应使用匹配的DeePMD接口和元素type_map。