
NepTrain训练NEP与检查独立测试误差
完整nep.in、数据标签与四个实训模型的能量、力和压力误差。
阅读本篇目录
下载输入、模型、真实数据和短命令脚本(ZIP)。先按上手教程完成解压,所有命令都在附件根目录执行。
1 数据先拆分,再训练#
head -n 5 data/train.xyz
cat data/SPLIT.json
cat inputs/nep.in
32帧训练、8帧验证、8帧独立测试的构型编号固定保存在SPLIT.json,三个集合没有相同几何构型。构型总能量单位eV、力eV/Å、总virial为eV,晶胞和位置为Å。本例标签统一采用VASP自由能F,不能把另一套能量定义直接混入。
扩展XYZ每帧先写原子数,再写晶胞、能量、virial和属性名,后面每行一原子的元素、位置与力。查看文件头比只检查文件名更可靠。验证文件交给训练过程,独立测试文件只在训练结束后评价;用测试误差反复挑模型也会削弱它的独立性。
2 完整NEP输入#
type 1 Si
version 4
cutoff 4.5 4.0
n_max 4 4
basis_size 4 4
l_max 4 2 0
neuron 20
lambda_e 1.0
lambda_f 1.0
lambda_v 0.1
generation 10000
population 20
batch 32
type 是元素类型及顺序,version=4 为NEP4,cutoff 是径向和角向截断半径。neuron 控制网络宽度,population 为演化种群大小,generation 为演化代数。这里的一代不等于MD一步,也不等于其他机器学习框架的一次epoch。
lambda_e/f/v 是能量、力和virial损失权重。本例刻意保持小网络和短训练,用于理解流程。安装版读取输入的方式有版本差异,不建议只在文本中添加新关键字后就认定已生效,应检查实际训练输出。
3 运行并看模型#
首次运行整条流程:
bash prepare.sh
bash workflow.sh
bash status.sh
已经提交过就查看状态,不要再次准备。
head loop/cache/Generation-1/nep/nep.txt
head loop/cache/Generation-2/nep/loss.out
bash evaluate.sh
GPUMD 5.9.1的loss.out包含格式和列名注释,自己读表时跳过以 # 开头的行,按实际表头识别列。不要依赖旧版本固定列数。
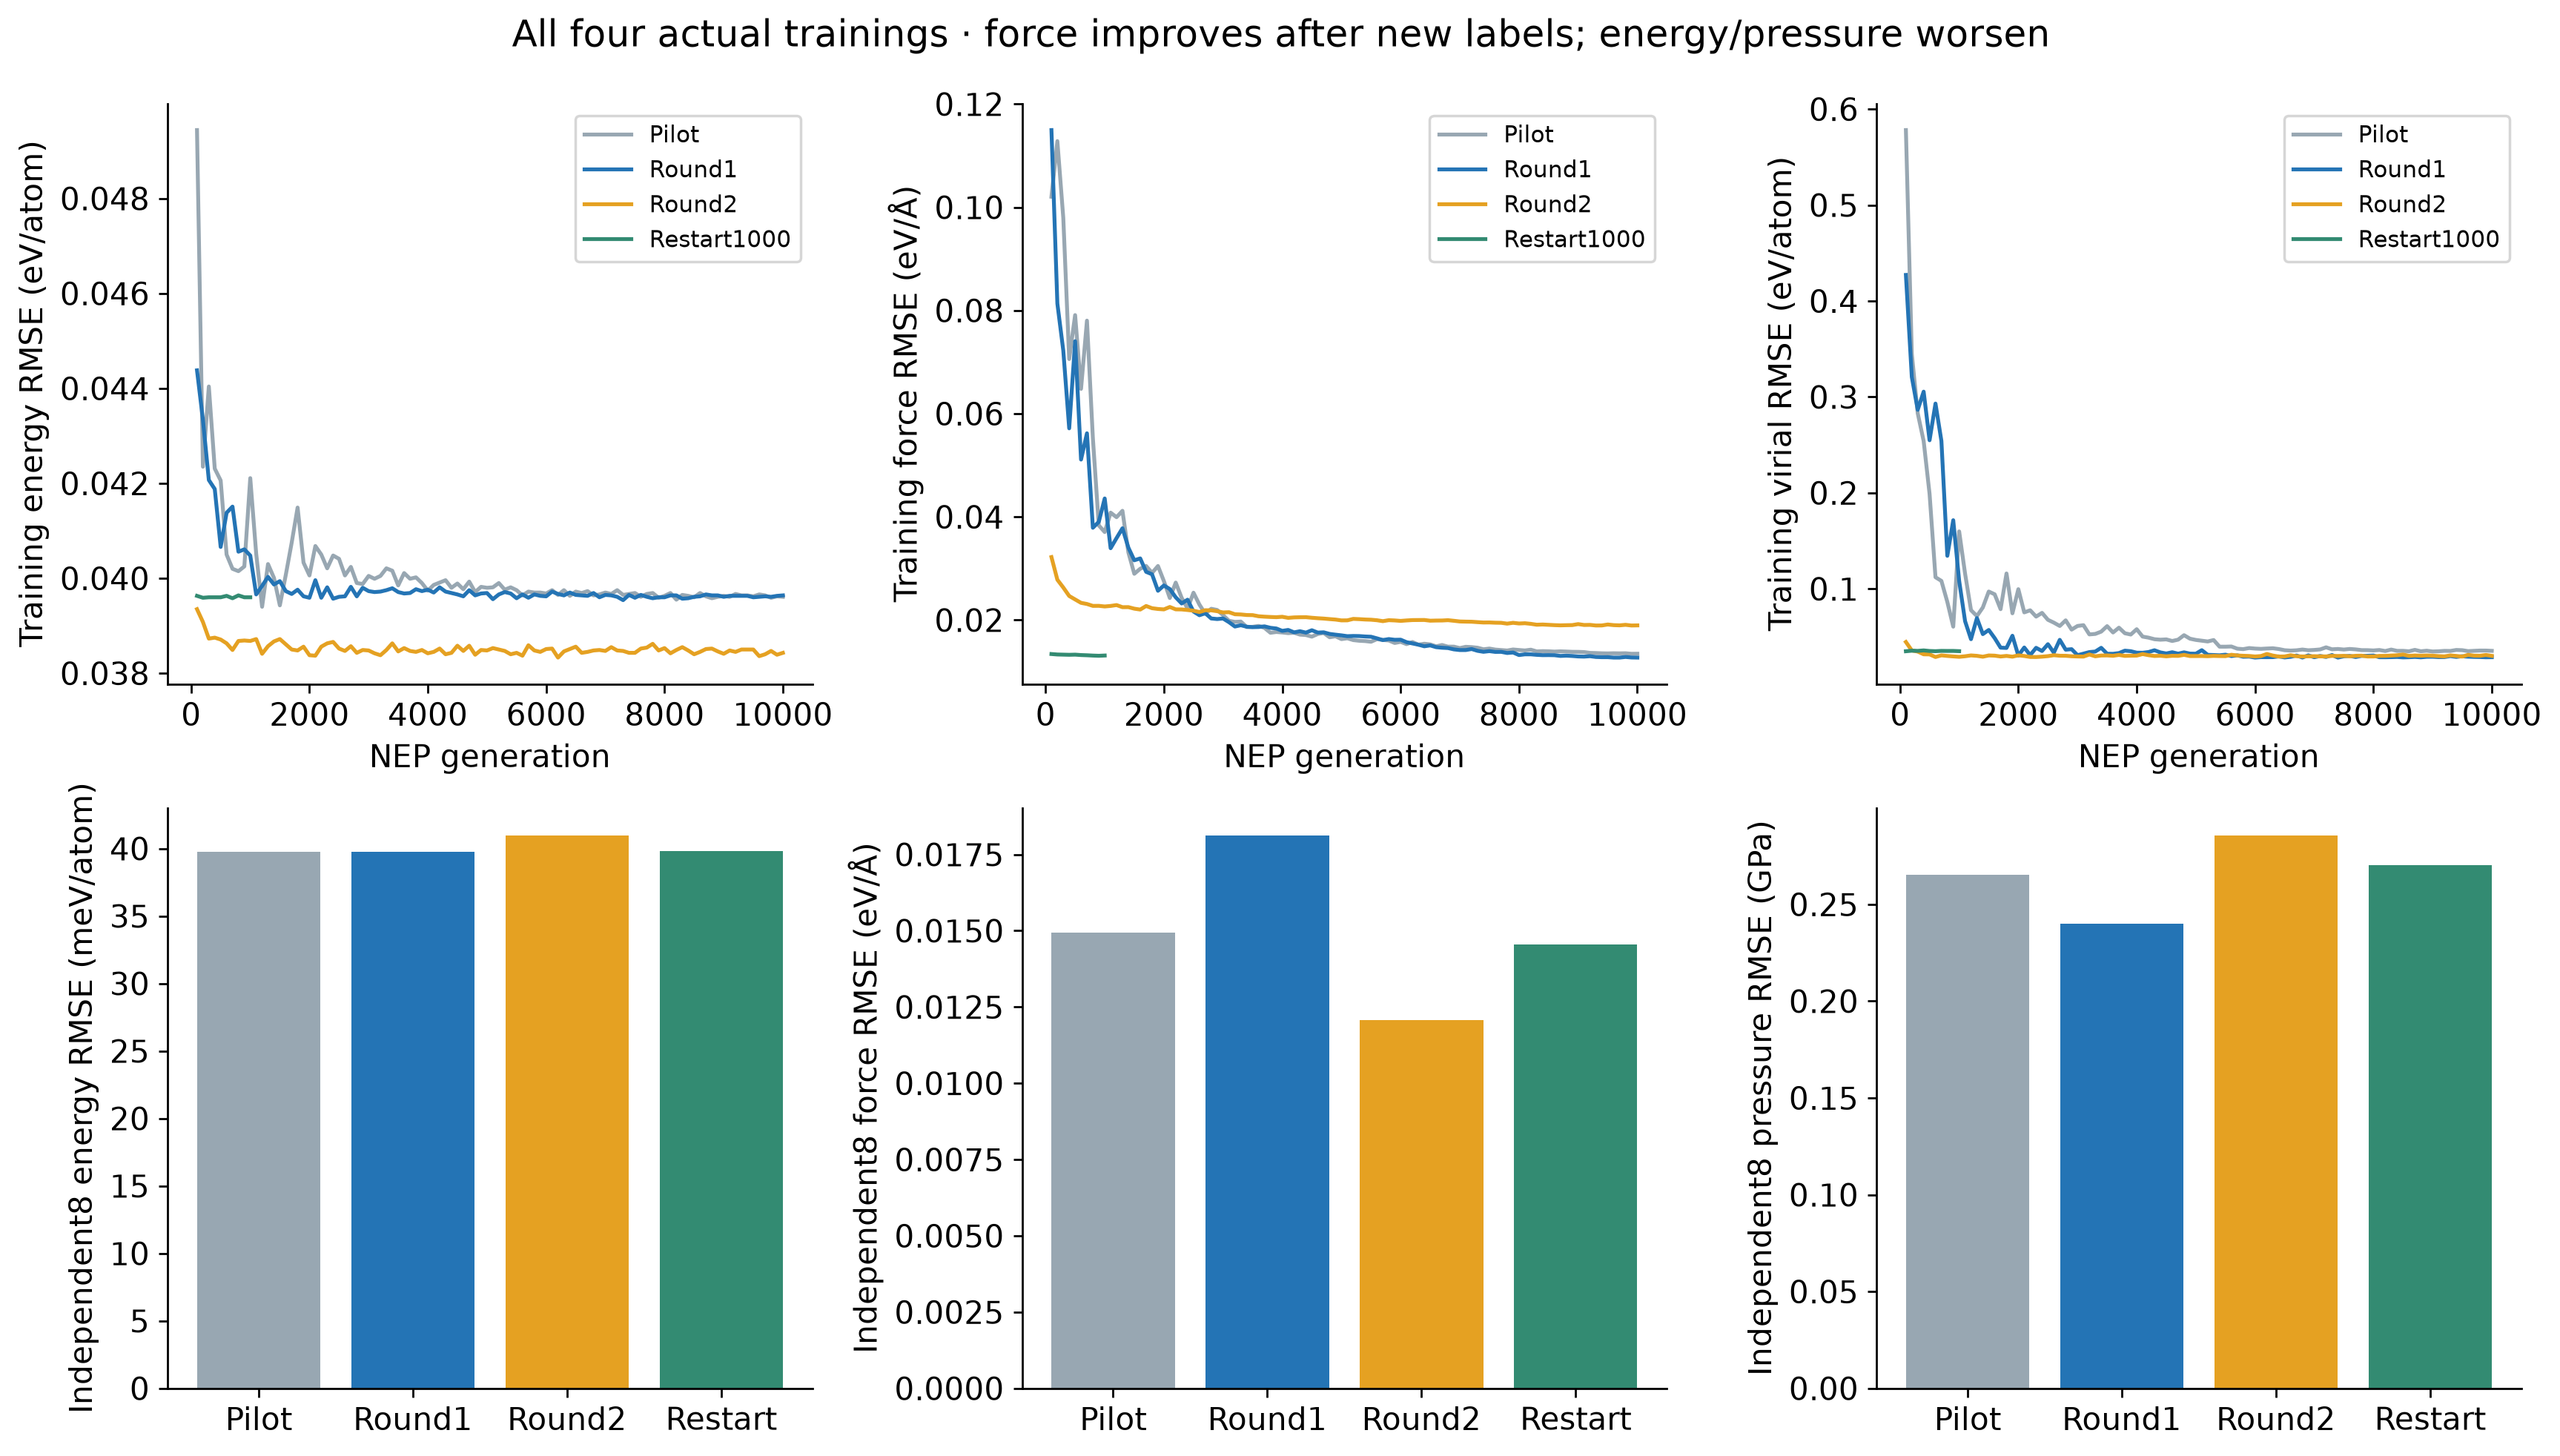
4 实际误差完整对照#
下表均来自同一组八帧独立测试,力为全部笛卡尔分量的RMSE;压力为virial换算后的张量分量RMSE。
| 模型 | 能量 / eV·atom⁻¹ | 力 / eV·Å⁻¹ | 压力 / GPa |
|---|---|---|---|
| 独立预训练pilot | 0.039736 | 0.014925 | 0.265218 |
| 闭环第一代 | 0.039770 | 0.018114 | 0.239938 |
| 加四点后的第二代 | 0.040951 | 0.012081 | 0.285457 |
| 检查点续训分支 | 0.039795 | 0.014549 | 0.270054 |
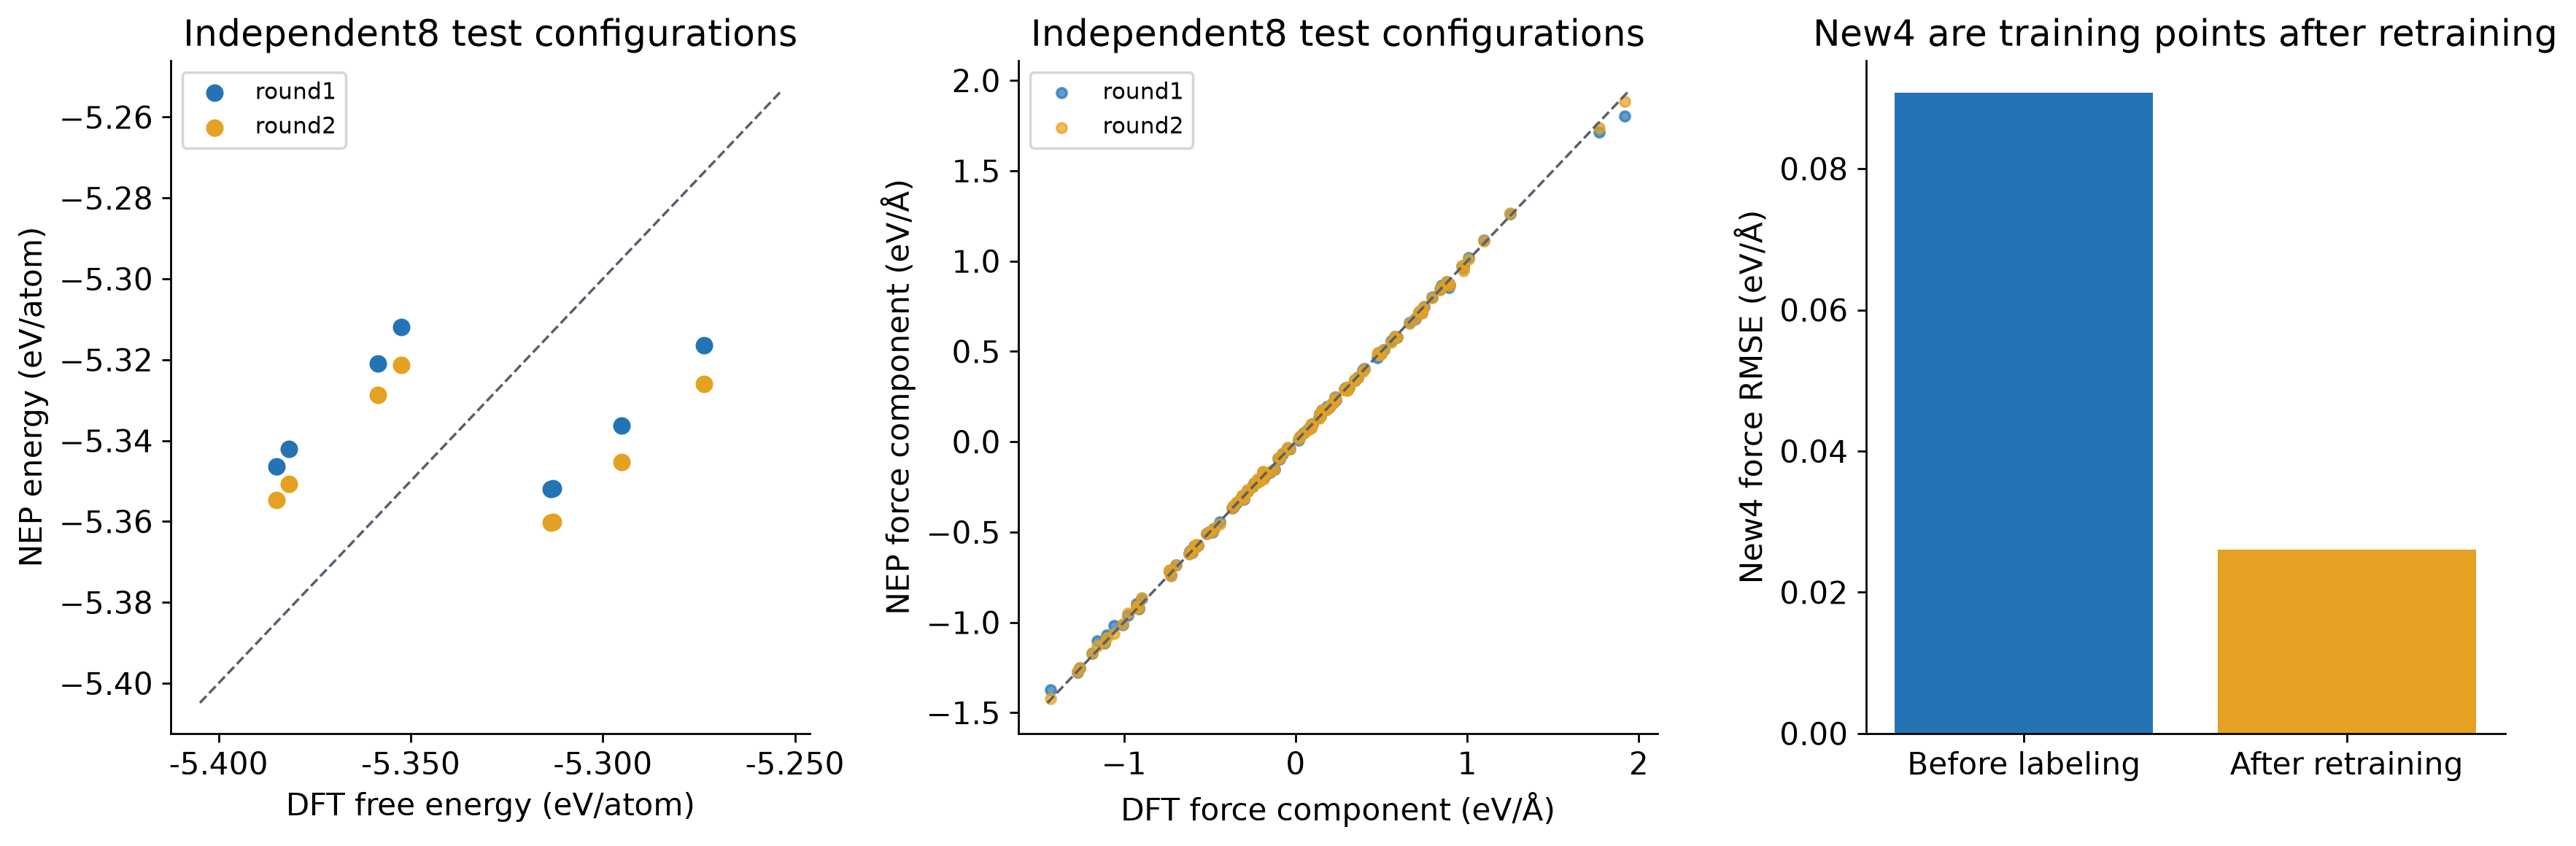
再训练后力误差改善,能量和压力误差略有增大。不能只选改善的一项就说整个模型全面提高。pilot、两代闭环和续训分支是四个实际训练模型,不是误差委员会;单模型描述符选样也不等于委员会不确定度。
cat analysis/neptrain-heldout.csv
bash evaluate.sh
cat analysis/my-model-errors.json
重新训练受到演化随机性影响,不承诺与参考模型逐字节相同。本例另一次完整复跑的第二代测试误差为能量0.040445 eV/atom、力0.018049 eV/Å、压力0.378024 GPa。对生产势还应加入自己实际温压、缺陷和组分的独立测试。