
PFD-kit模型评价、选样与短轨迹检查
同一组独立DFT误差、熵选样覆盖、CPU/GPU一致性及学生MD对照。
阅读本篇目录
下载输入、五个参考模型、真实数据与短命令脚本(ZIP)。本篇先看独立误差,再看轨迹能否运行,最后决定保留哪一支模型。
1 提取自己的独立误差#
bash evaluate.sh
cat work/OWN-MODEL-ERRORS.json
cat analysis/PFD-independent.csv
前两条使用自己新训练的权重,最后一条是附件参考结果,不能混作同一个模型。能量误差按构型总能量差除原子数计算;力对全部原子的笛卡尔分量求RMSE;压力对张量分量求RMSE。
八个外部构型没有参与训练和候选筛选。这是小范围的操作例,生产模型还需要留出未参与模型选择的更广泛测试体系。
2 熵选样图说明什么#
bash run.sh
cat analysis/PFD-selected.csv
head analysis/PFD-coverage.csv
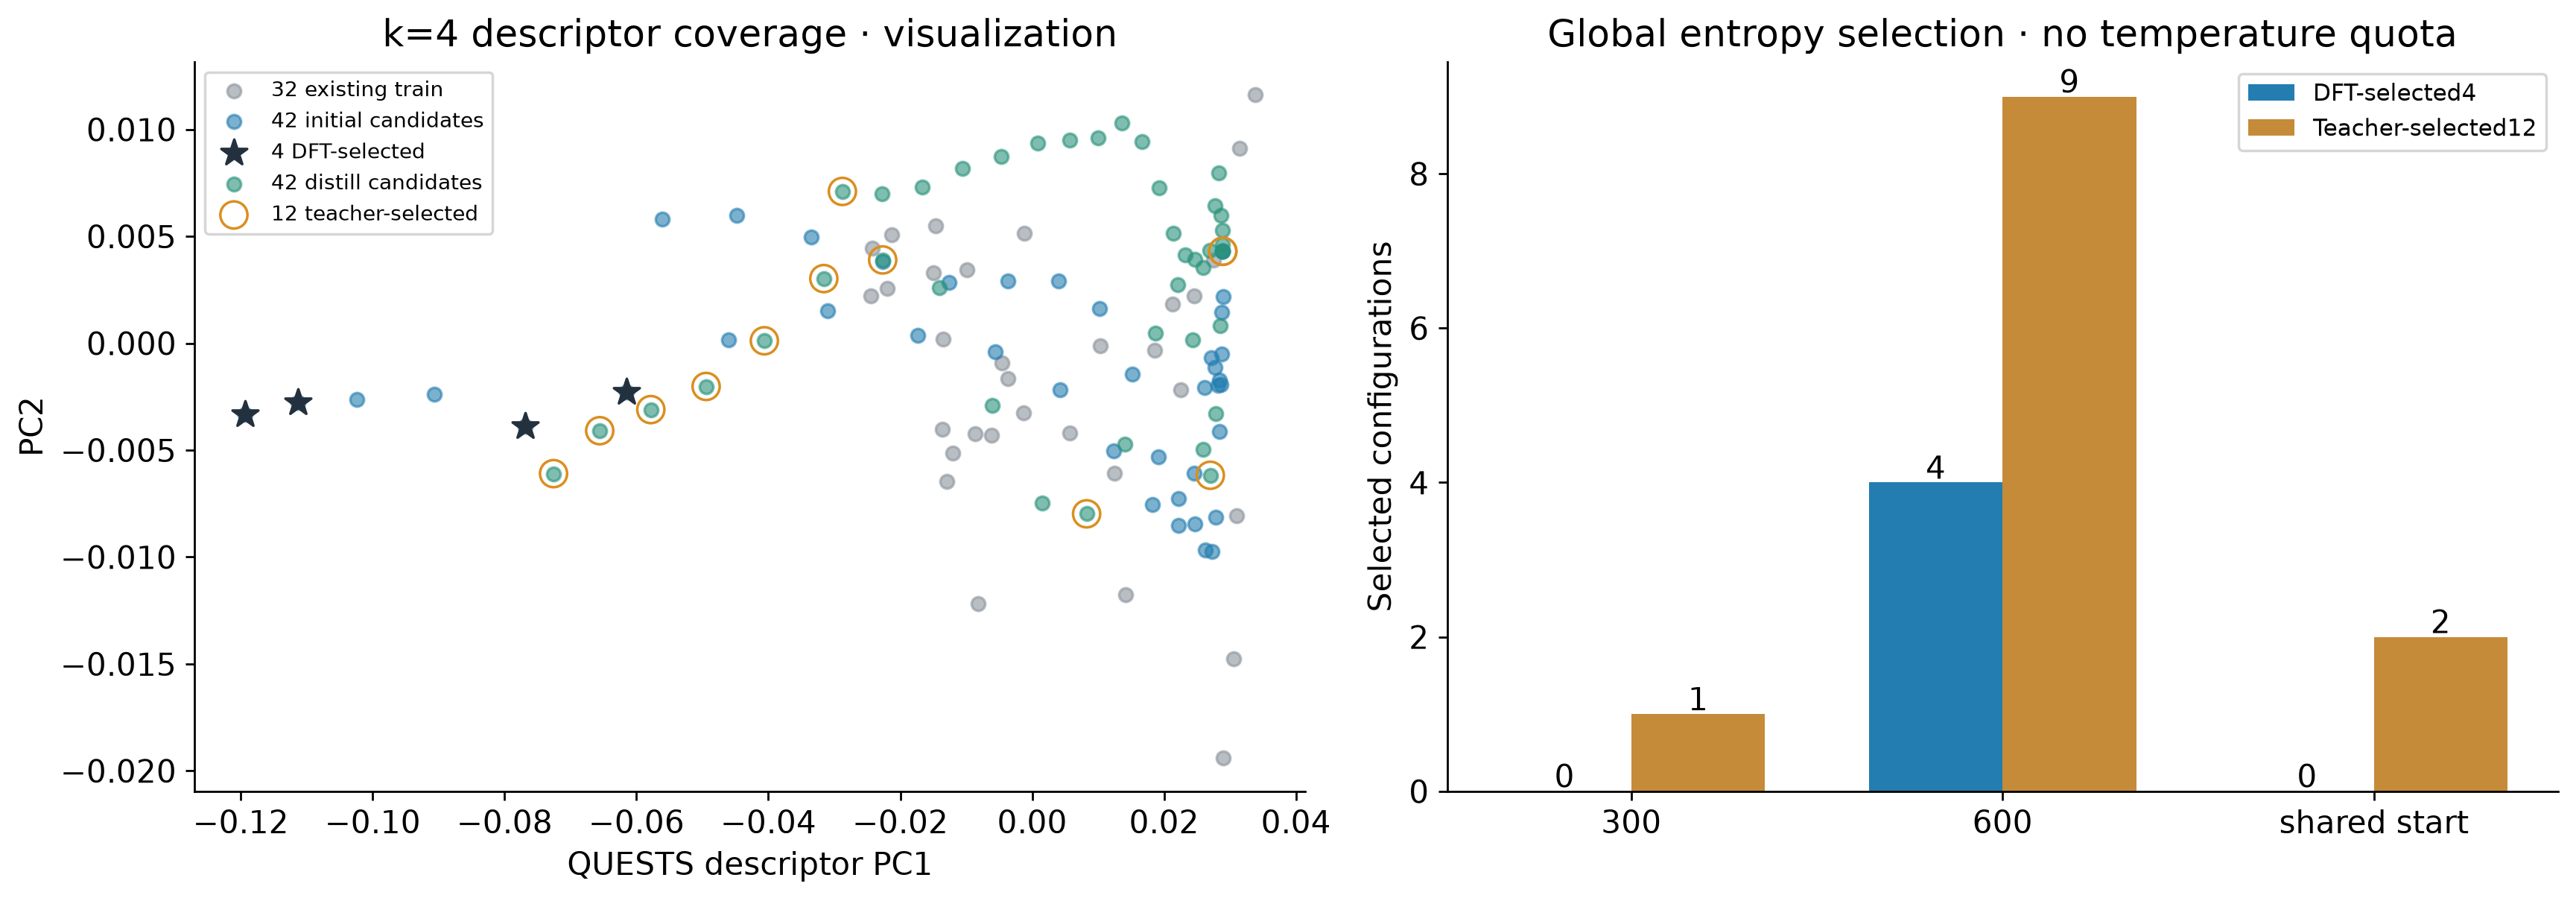
PCA只用于把真实QUESTS描述符投影到二维,拟合范围为训练结构和候选,外部八帧不参与。熵选样在合并候选上做覆盖选择,没有按300/600 K均分配额;两温度共同的初始几何在表中注明多个匹配来源。
描述符覆盖不是DFT误差预测。最终是否改善,仍需计算标签并做独立对照。
3 稳定运行与准确拟合分别看#
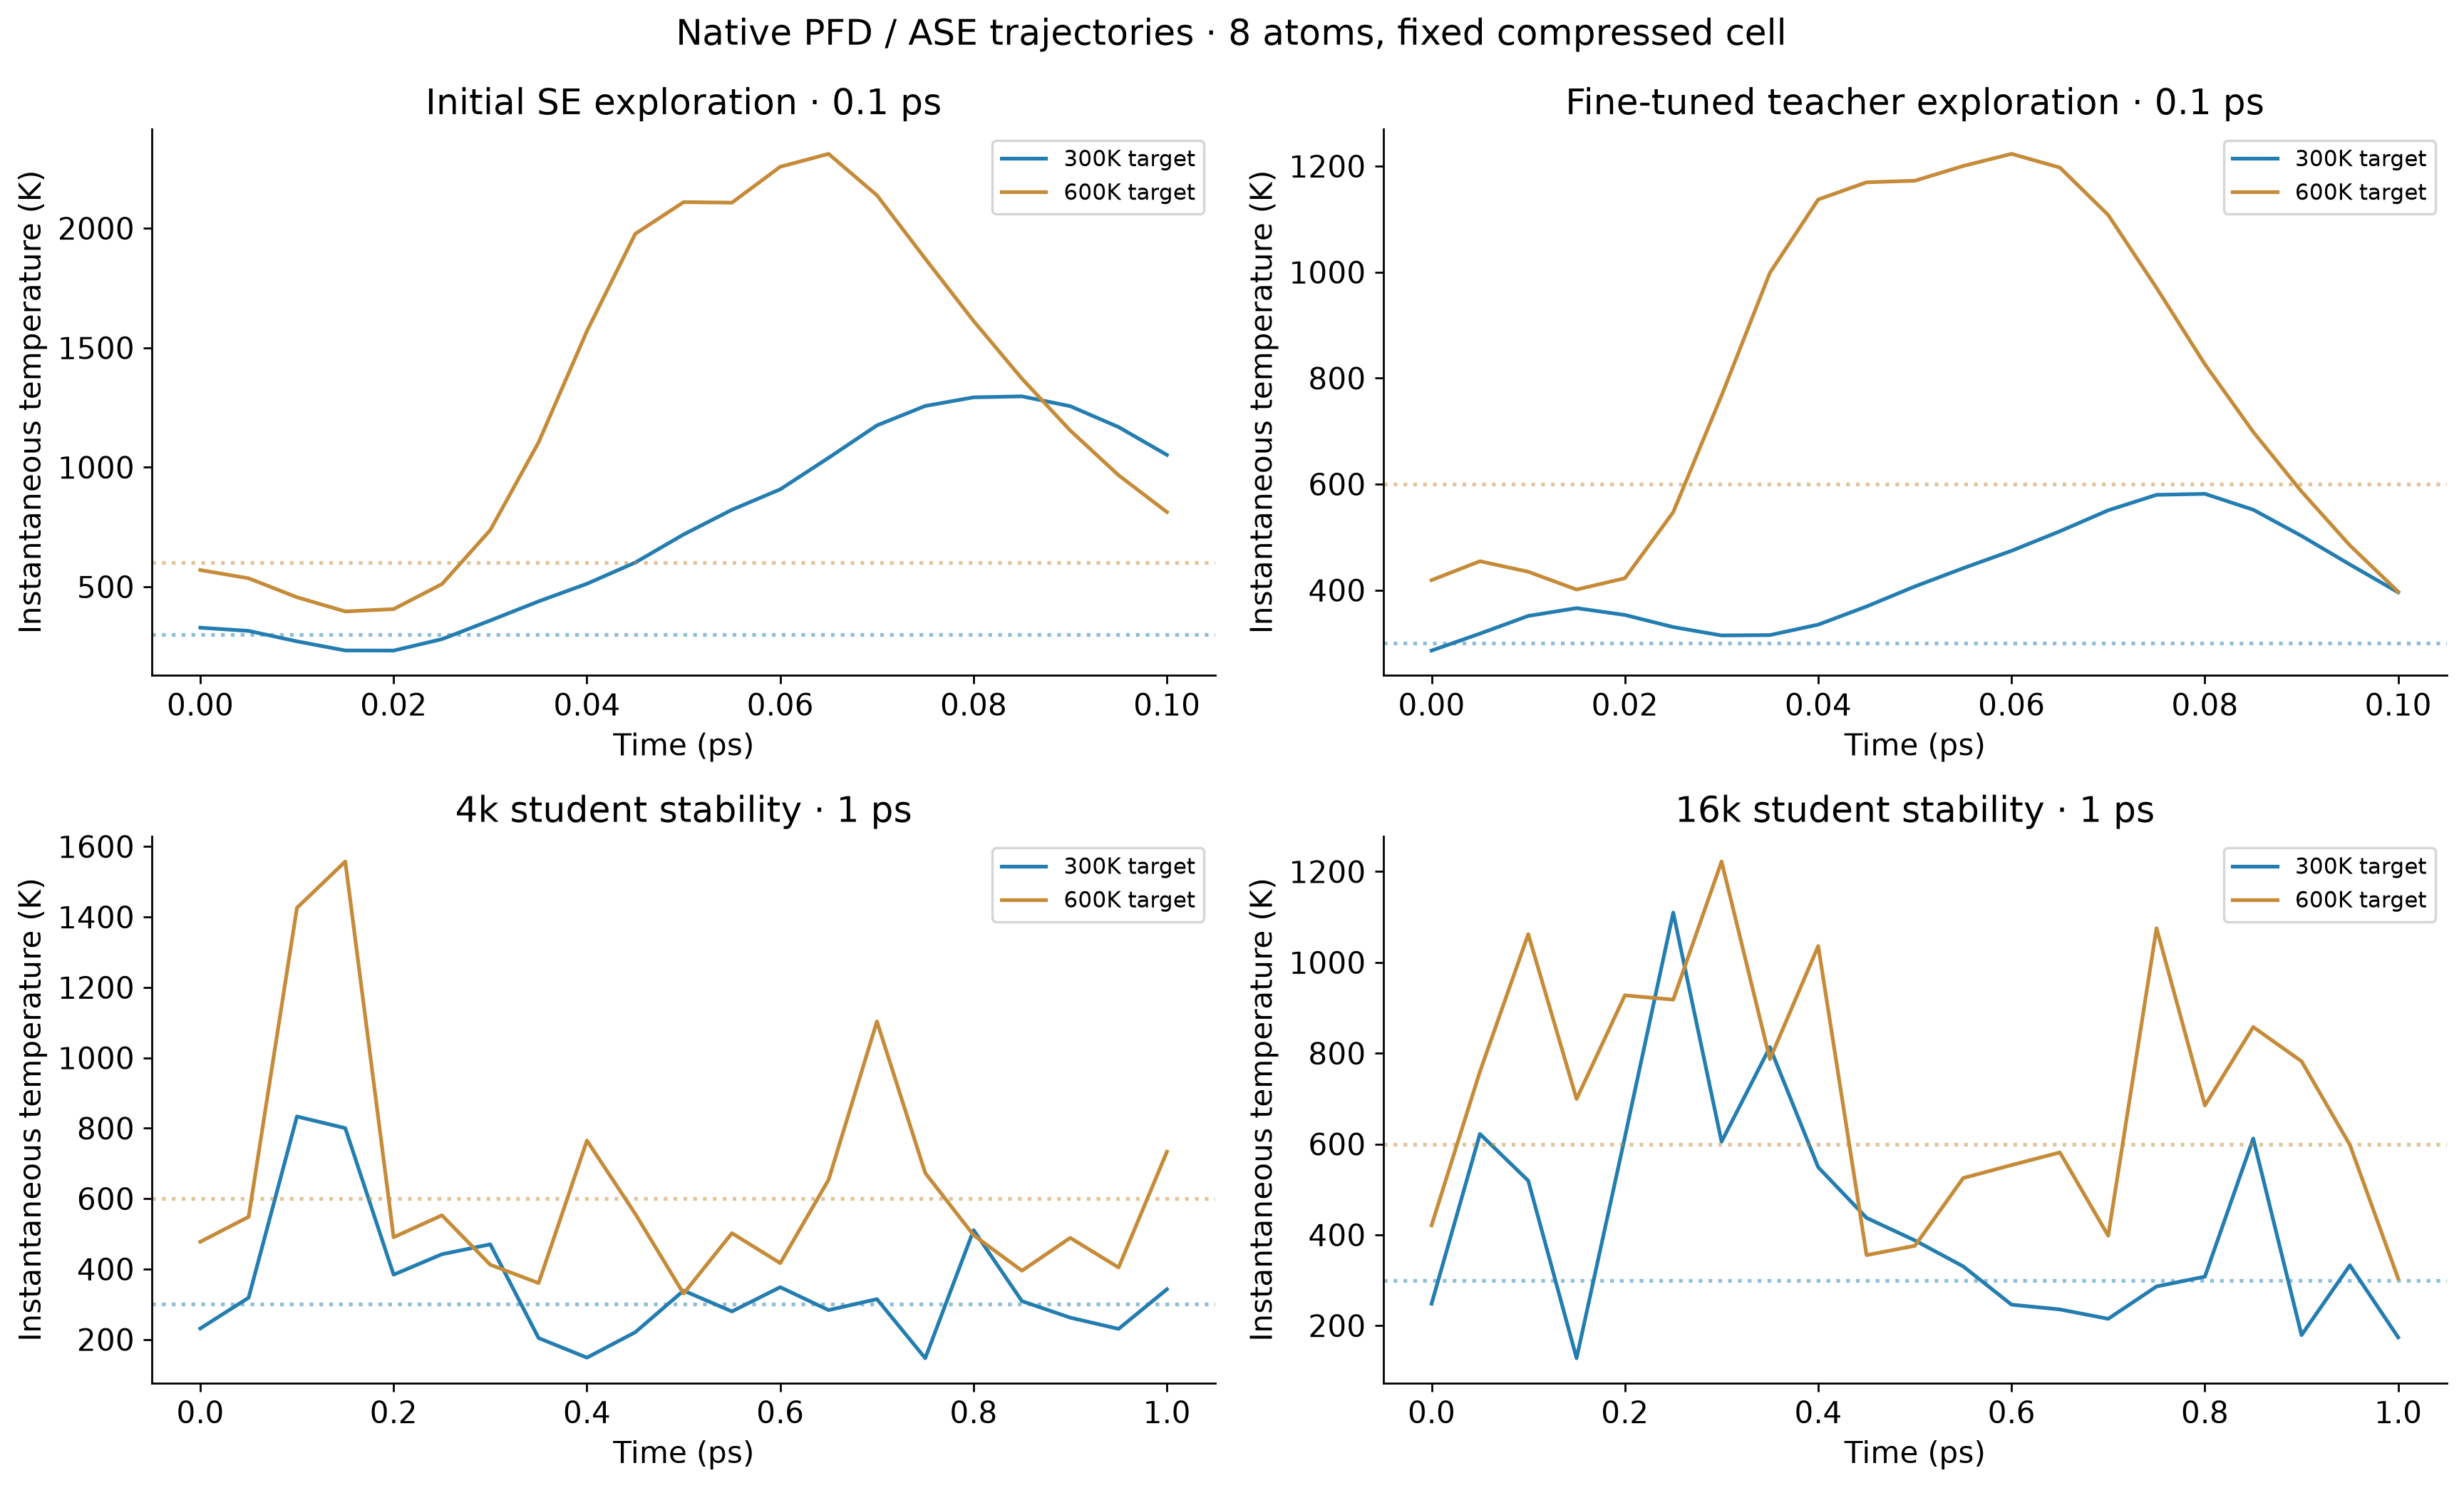
参考中既有SE与微调教师各探索0.1 ps,4000步与16000步学生另外各做300/600 K、1 ps轨迹。体系只有八个原子,瞬时温度波动较大;固定压缩晶胞的NVT压力由结构和模型决定,不由目标温度直接设定。
head analysis/PFD-MD.csv
cat analysis/PFD-independent.csv
4000步学生的短轨迹能保持几何合理,但独立力和压力误差较大。仅凭轨迹没有崩溃,不能证明势适合该状态;同样,1 ps也不足以给出收敛扩散或热输运性质。
4 数值接口如何检查#
cat analysis/PFD-finite-differences.csv
cat analysis/PFD-DFT-labels.csv
同一组权重分别用CPU、P100和V100 16G预测,比较能量、力和总virial;另用能量对原子位移及均匀/xy应变的有限差分核对力和virial。
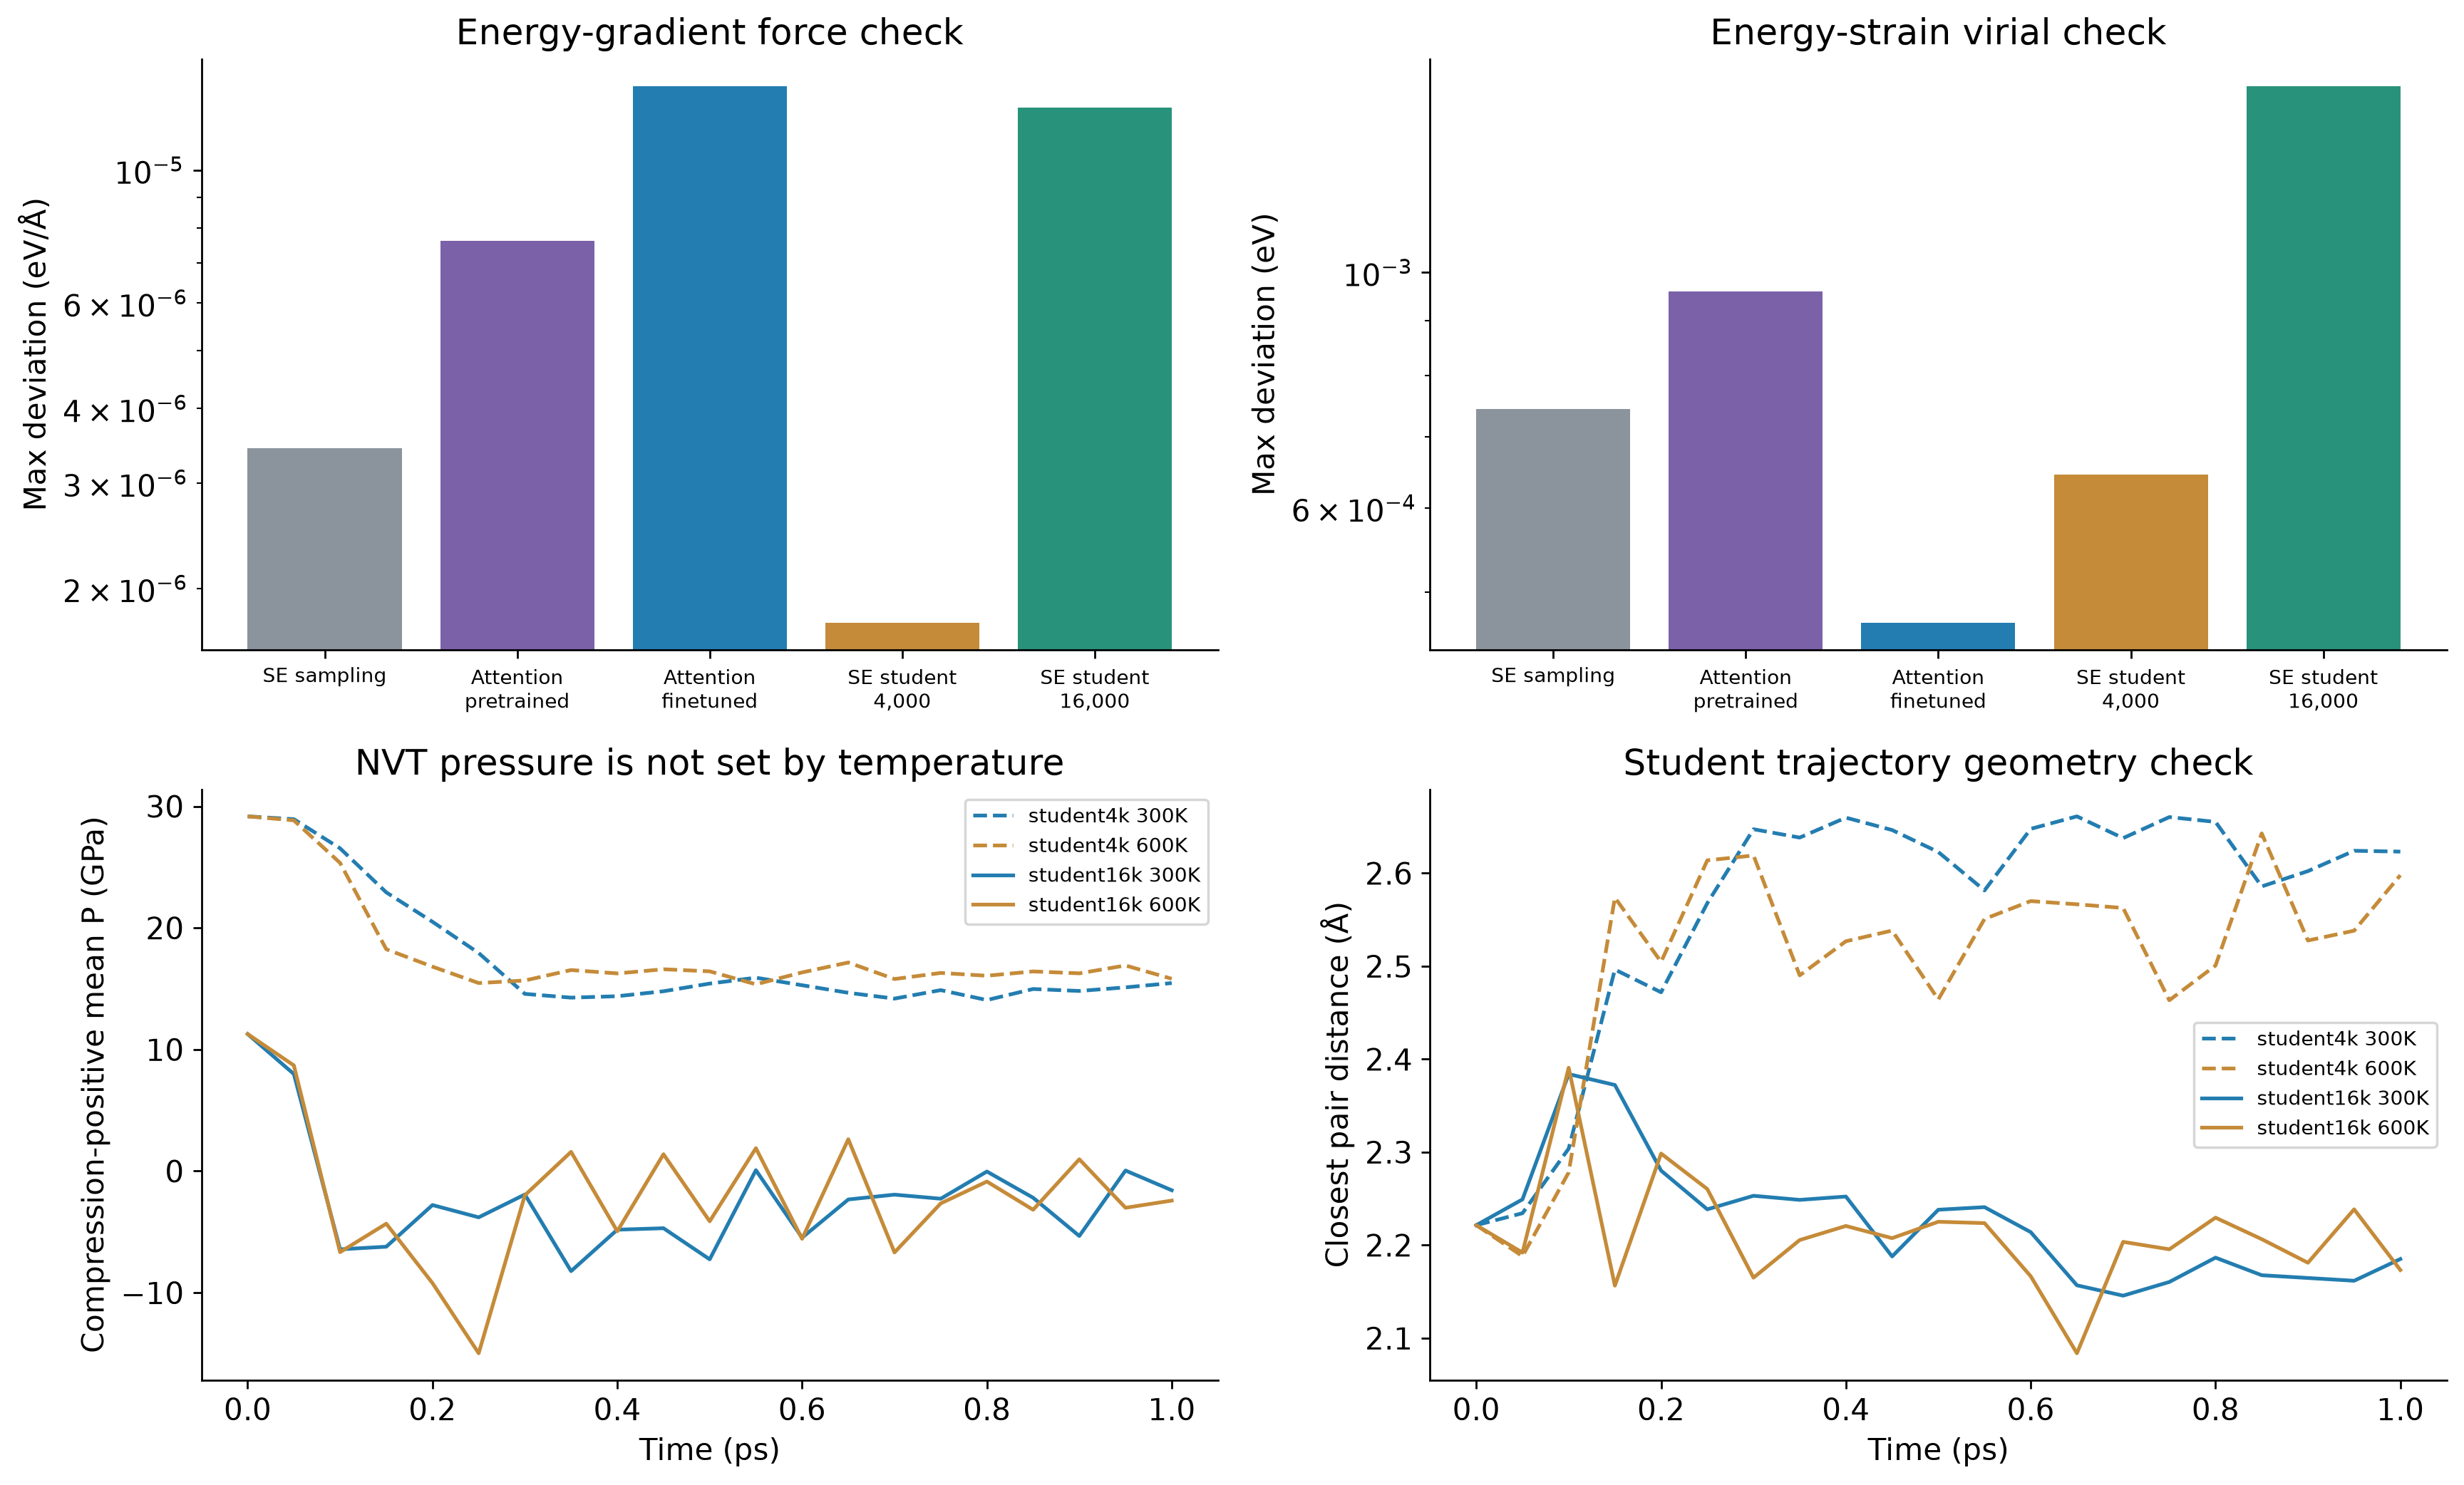
本例同权重跨设备差异小于1E-4 eV/atom(能量)、1E-4 eV/Å(力)和1E-4 eV/atom(virial)。这里的比较对象必须是同一个SHA的模型,不能要求两次随机训练所得不同权重逐项相等。
5 本例怎样选择#
4000步学生不宜仅因文件较小就直接替代教师。16000步学生在本例能量、力与压力误差上接近教师,可作为进一步测试的候选。接入自己的材料后,还应检查元素、温度、压力、缺陷和构型覆盖,并在目标规模上测实际速度。