
PFD-kit微调:探索、VASP补标与再训练
展开实际INCAR和流程参数,说明兼容的初始模型、四个新标签及微调结果。
阅读本篇目录
下载输入、五个参考模型、真实数据与短命令脚本(ZIP)。微调要从一个已有权重出发,同时保证新旧标签的物理定义一致。
1 选匹配的预训练模型#
本安装版TensorFlow微调入口支持注意力描述符se_atten/se_atten_v2及能量拟合网络,不能把普通se_e2_a模型直接交给同一--finetune入口。本例采用自己预训练的se_atten_v2模型;具体后端规则可查DeePMD微调说明。
head -n 35 configs/finetune-train.json
ls models/pretrained-attention.pb
cat inputs/INCAR
参考实算保留了已有SE势的两条探索轨迹作对照;切换为注意力初模后,复用了已完成的四个真实DFT标签。附件完整新算入口从兼容的注意力初模开始,因此自己重新采样的轨迹和选点不必与参考对照逐帧相同。
2 探索与选样参数#
本例使用300/600 K、NVT、0.5 fs时间步,各200步,即各0.1 ps;每10步输出,并包含第0步,各21帧、共42帧。熵选样最大选四帧,QUESTS描述符k=4、截断4.5 Å、每批两帧。
bash prepare.sh
cat work/finetune.json
cat work/finetune-train.json
配置中的关键部分:
{
  "task": {"type": "finetune", "max_iter": 1, "init_train": false, "init_fp": false},
  "select_confs": {"max_sel": 4, "h_filter": {"chunk_size": 2, "k": 4, "cutoff": 4.5, "h": 0.015}},
  "evaluate": {"test_size": 0.25, "model": "dp", "converge": {"type": "force_rmse", "RMSE": 0.05}},
  "train": {"type": "dp", "config": {"impl": "tensorflow"}}
}
这是对prepare实际生成配置的重点说明,完整文件包含当前目录中的模型、结构、赝势和训练模板绝对路径。入口会按自己的工作目录生成,无需手动替换长路径。
3 VASP实际输入#
SYSTEM=Si actual labels PBE
ENCUT=450
EDIFF=1E-6
PREC=Accurate
ISYM=0
ISIF=2
NSW=0
IBRION=-1
ISMEAR=0
SIGMA=0.05
LWAVE=.FALSE.
LCHARG=.FALSE.
LREAL=.FALSE.
ADDGRID=.TRUE.
ALGO=Normal
NELM=120
NCORE=1
GGA=PE

KSPACING=0.5
KGAMMA=.TRUE.
NSW=0、IBRION=-1是当前构型的单点标签;不是把每个候选先优化到同一最低点。KSPACING和KGAMMA自动生成Γ中心网格,因此本例没有另用一个固定KPOINTS文件。元素顺序为Si,授权POTCAR由prepare中的VASPKIT103生成。
4 提交与提取#
首次提交整条流程:
bash calculate.sh
bash status.sh
任务结束后:
find work/finetune -name OUTCAR
find work/finetune -name vasprun.xml
find work/final-finetune/model -name '*.pb'
查看自己原始OUTCAR,确认电子迭代达到EDIFF且输出正常结束。仅看任务结束或有一个模型文件,不足以判断标签正确。
5 微调后得到什么#
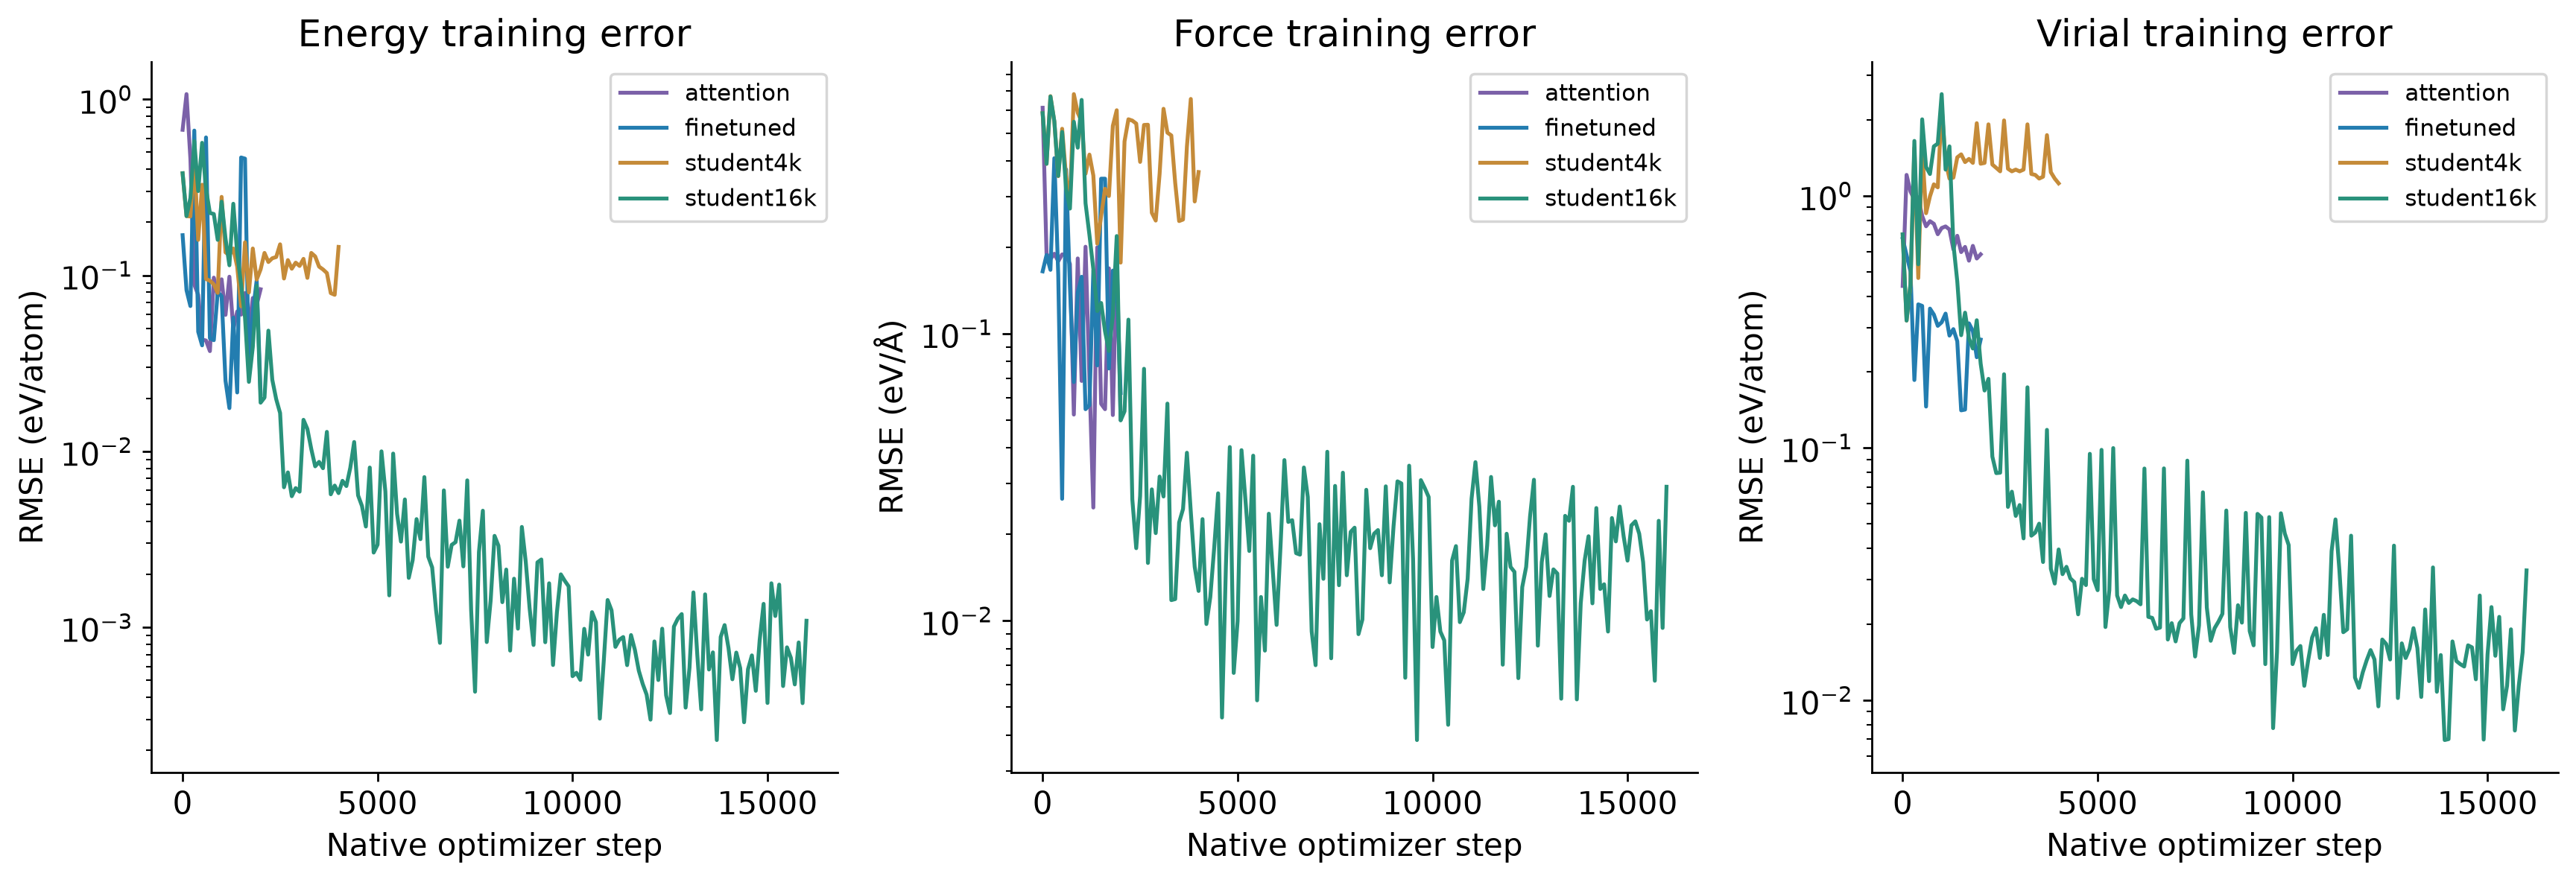
相同八帧外部DFT对照下,注意力初模 → 微调模型:能量RMSE0.061265 → 0.050971 eV/atom,力0.173325 → 0.142766 eV/Å,压力张量4.977087 → 2.172793 GPa。
bash evaluate.sh
cat work/OWN-MODEL-ERRORS.json
cat analysis/PFD-independent.csv
这组结果说明本例误差的变化,不保证任何新数据都能全面改善模型。内部一帧检查的力误差仍高于0.05 eV/Å,任务只因教学预算限制一轮而结束,不能宣称已达到生产收敛。