
DPDispatcher全部后端与环境选择
按已安装1.1.0列出12种后端、别名、模板与依赖,区分本集群实际运行和外部调度、云平台条件。
阅读本篇目录
选择DPDispatcher后端,先看目标机器的调度系统,再看文件怎样传递。batch_type决定作业提交方式,context_type决定连接与传输方式;二者需要匹配。本集群的计算作业使用Slurm,普通用户可直接参考Slurm提交教程或作业数组实例。
1. 先查看当前版本的全部后端#
示例采用DPGEN 0.14.0环境中的Python 3.12、DPDispatcher 1.1.0。下载后保存为dispatcher.zip:
unzip dispatcher.zip
cd dpdispatcher-backends-arrays-wave268
cat reference/analysis/backend-support.csv
无需提交计算即可查看已有头部和示例配置:
ls reference/backend-headers
cat reference/backend-headers/PBS.sh
cat reference/cloud-schemas/OpenAPI-schema.json
要用实际安装库重新生成模板:
source /etc/profile
module load dpgen/0.14.0
python render_backends.py
结果在backends/。程序调用安装版本的后端类生成十种非云后端的原生头部片段,并用bash -n检查Shell语法;两个云后端提供配置结构示例。模板中的example_queue是占位队列,云示例program_id=0是占位项目,实际使用前必须改成目标平台提供的值。
2. 十二种后端怎样选择#
下面对应本安装版本的十二个后端类。大多数类接受同名小写形式,特殊历史别名在最后一列说明;名称相近的PBS、Torque仍要按目标系统选择。
batch_type |
需要的目标环境 | 本集群使用方式或参考 | 主要别名/注意点 |
|---|---|---|---|
Shell |
可执行Shell的机器 | 已有本地执行实例,用于分配范围内的轻量处理 | 无调度系统;并发要自行限制 |
Slurm |
Slurm及有效队列、账户 | 已有真实GPU计算 | 本集群常规选择 |
SlurmJobArray |
Slurm作业数组 | 本批P100、V100 16G真实数组实例 | 每个数组子任务单独申请资源 |
PBS |
对应PBS客户端与队列 | 包内有实际生成的头部,需目标PBS环境执行 | 示例使用select=...:ncpus=... |
Torque |
Torque客户端与队列 | 包内有实际生成的头部,需目标Torque环境执行 | 示例使用nodes=...:ppn=... |
LSF |
LSF客户端、队列和资源语法 | 包内有实际生成的头部,需目标LSF环境执行 | #BSUB;GPU语法依平台设置 |
SGE |
SGE及并行环境、队列 | 包内有实际生成的头部,需目标SGE环境执行 | 示例并行环境名mpi需核对 |
JH_UniScheduler |
对应UniScheduler客户端与队列 | 包内有实际生成的头部,需目标系统执行 | 精确名称含下划线;#JSUB |
Fugaku |
富士通/PJM类调度环境 | 包内有实际生成的头部,需目标系统执行 | #PJM、资源组;不同站点设置可能不同 |
DistributedShell |
Hadoop/YARN、HDFS及DistributedShell环境 | 包内有原生头部,完整运行需要相应大数据平台 | 不是普通SSH多机执行的替代名称 |
Bohrium |
对应Bohrium云接口、项目与账户 | 本包提供配置结构;按平台要求配置后使用 | 历史别名Lebesgue、DpCloudServer |
OpenAPI |
对应Bohrium SDK、AccessKey与项目 | 本包提供配置结构;按平台要求配置后使用 | OpenAPIContext,不同于旧账户密码接口 |
各外部系统还需要目标机器上可用的科学程序、MPI/CUDA环境、文件系统和资源权限。头部能够生成、Shell语法正确,并不表示远端队列名称、资源参数、账户或科学软件已经可用。后端概念与支持范围可参照DPDispatcher官方说明。
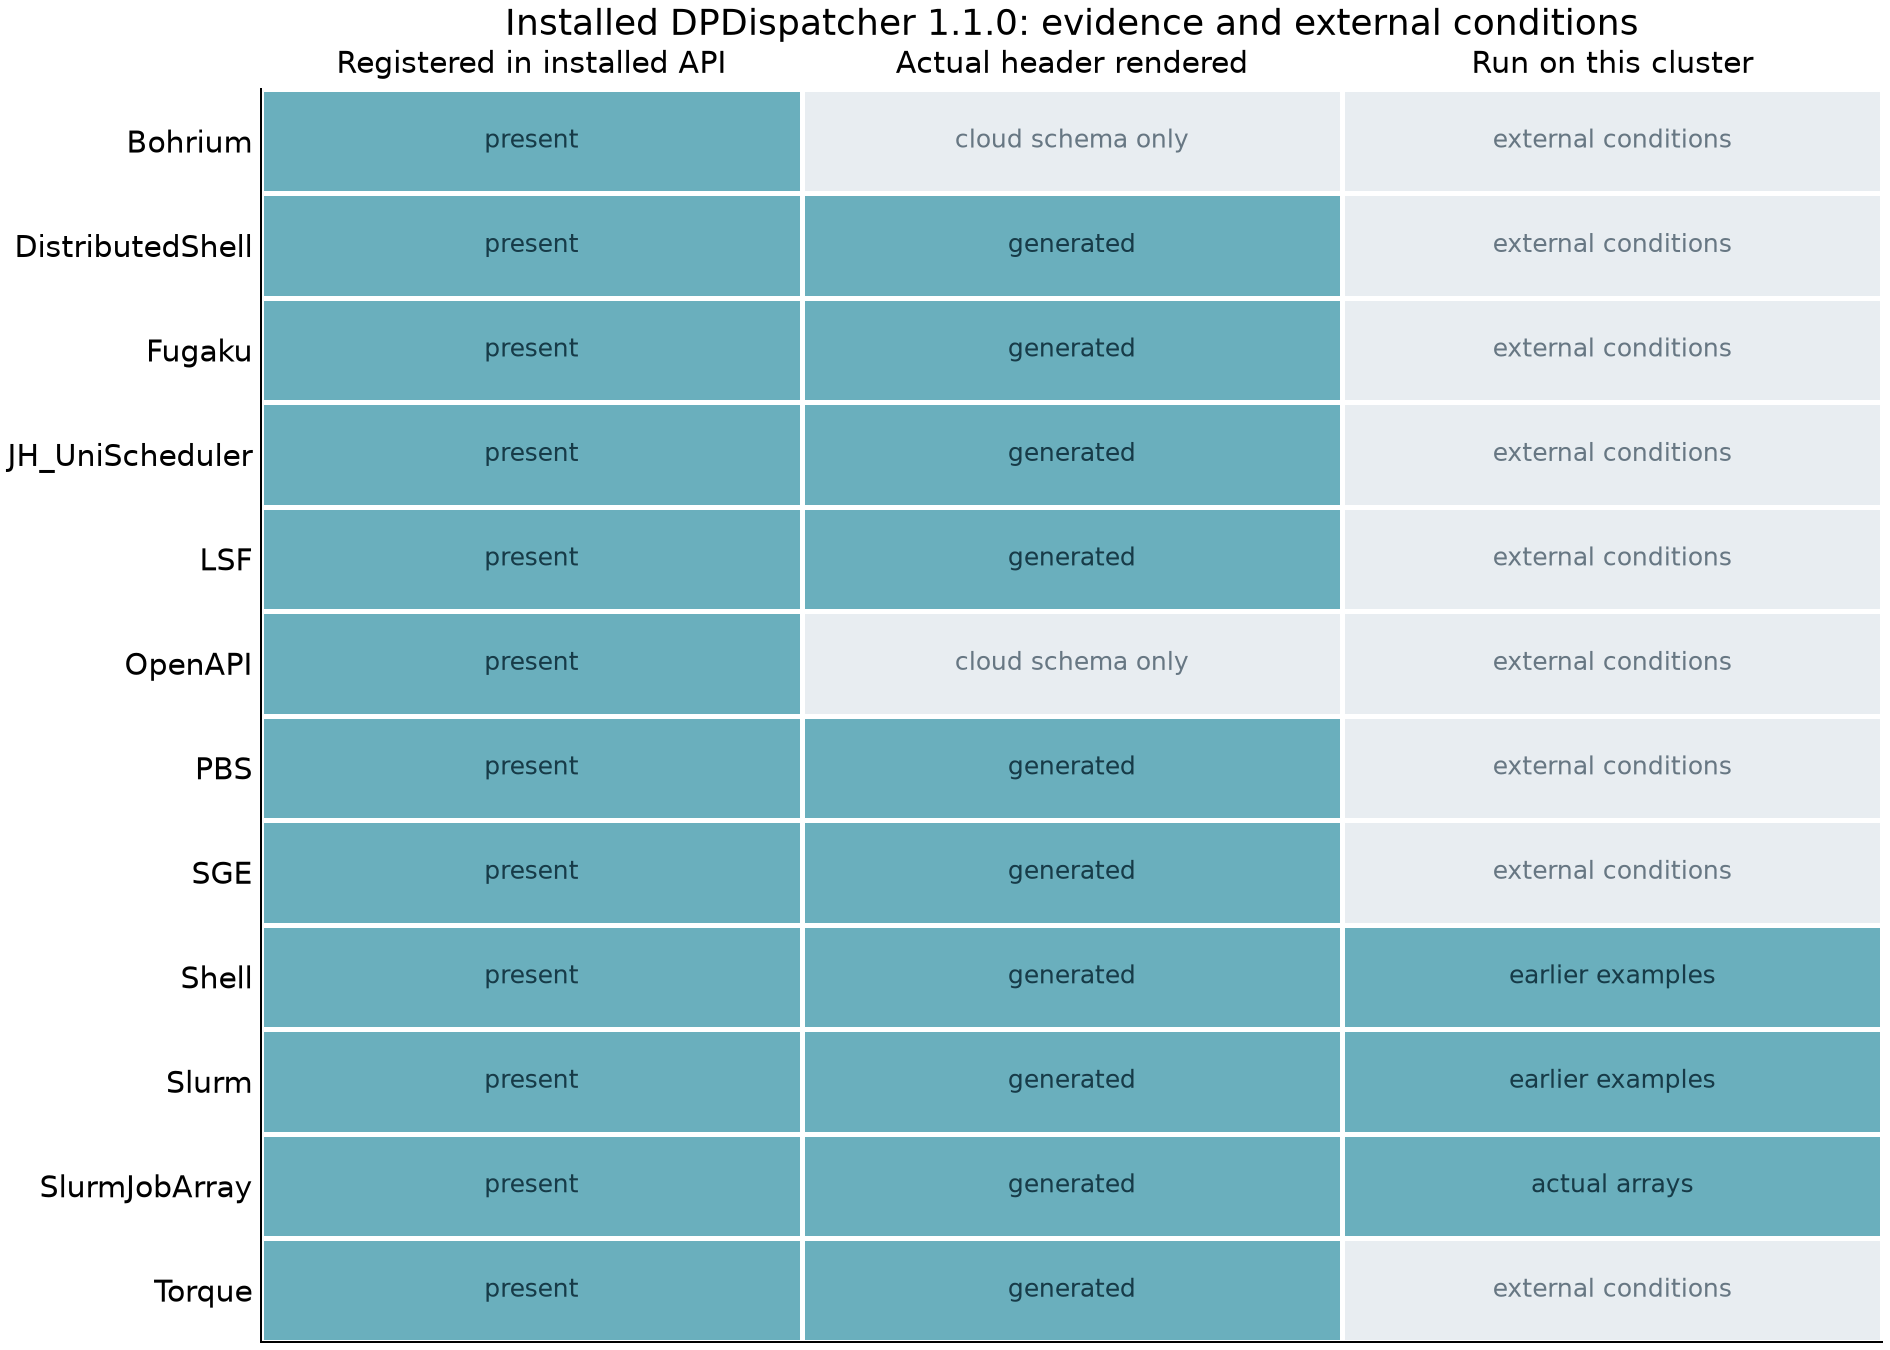
图中Shell和Slurm对应既有实算教程;SlurmJobArray对应本批真实计算;其余行表示外部系统条件。两个云后端只检查配置结构,不把占位项目当作真实云任务。
3. 看懂不同头部#
同样申请一个节点、两个CPU,两个PBS家族头部并不一样:
# PBS示例
#PBS -l select=1:ncpus=2
#PBS -q example_queue

# Torque示例
#PBS -l nodes=1:ppn=2
#PBS -q example_queue
LSF、UniScheduler、PJM采用各自的资源描述,例如:
#BSUB -n 2
#BSUB -R 'span[ptile=2]'
#BSUB -q example_queue

#JSUB -n 2
#JSUB -R 'span[ptile=2]'
#JSUB -q example_queue

#PJM -L "rscgrp=example_queue"
#PJM -L "node=1"
#PJM --mpi "max-proc-per-node=2"
这些是实际后端生成的头部片段。完整运行还需程序命令、模块加载、输入文件、输出取回和目标站点要求;Fugaku的片段本身不包含Shell首行,应按目标系统的完整作业脚本规则使用。
4. context_type怎样搭配#
在登录节点控制、远端工作目录也在同一文件系统时,本例使用:
{
  "batch_type": "SlurmJobArray",
  "context_type": "LocalContext",
  "local_root": "./work/local",
  "remote_root": "./work/remote",
  "remote_profile": {"symlink": false},
  "retry_count": 1
}
这里LocalContext只描述文件和命令访问方式,实际计算仍由Slurm提交,不是在登录节点启动生产模拟。若控制机和调度机器分离,需要按实际SSH登录及文件传输配置SSHContext。YARN对应HDFS相关环境;两个云后端需要对应云上下文和项目配置,不能把LocalContext、云上下文和后端名称随意拼接。
Shell没有调度器为你限制全局并发;适用于少量控制和已分配资源内的计算。普通科学计算应继续通过Slurm。group_size=0把任务归入一个DPDispatcher作业,但数组中还要看slurm_job_size,详见作业数组。
5. 从模板走到实际使用#
先确认目标后端和上下文,再填写真实队列、核数、GPU类型、模块及输入输出清单;先用一个小任务走通提交、等待与取回,再批量扩展。云平台还应核对SDK、项目、镜像和机器类型,凭据由自己的私有配置或平台推荐的环境变量提供,公共脚本中只保留变量名。具体资源字段见官方资源参数文档。
本集群用户通常无需修改后端。直接使用Slurm或SlurmJobArray,并选择自己有权限的资源即可;续算、失败重试与文件取回继续参考中断恢复教程。