
DPDispatcher作业数组:一次提交多个计算
在P100和V10016G运行三个真实LAMMPS条件,说明任务分组、数组子任务、GPU数量、取回结果及终端绘图。
阅读本篇目录
同一组输入需要计算多个结构、参数或距离时,可以把它们交给Slurm作业数组。本篇用三个两原子Lennard–Jones条件展示真实流程:生成任务 → 提交一个数组 → 两个数组子任务完成三个计算 → 取回能量和力 → 汇总画图。P100和V100 16G均有实际结果。
1. 用短命令运行#
下载并保存为dispatcher.zip:
unzip dispatcher.zip
cd dpdispatcher-backends-arrays-wave268
bash run.sh
run.sh先生成本地后端模板,再通过当前普通账号分别提交P100和V100 16G数组,最后分析和画图。需要相应GPU资源使用权限。只运行P100时,在新解压目录执行:
source /etc/profile
module load dpgen/0.14.0
python worker_arrays.py p100
V100条件把最后一个参数换成v100,此例使用16G设备。计算在Slurm分配的资源内运行,控制程序负责提交和取回。每次实际提交前都会重新核对本例的节点排除条件,资源成员发生变化时需要重新核对配置。
已有p100/、v100/时程序不会覆盖。再次完整运行请另外解压;已有结果只需重新分析或绘图。无需重算也能查看reference/中的CSV和原图。
2. 三个参数分别控制什么#
本例核心资源设置:
resources = Resources(
    number_node=1,
    cpu_per_node=1,
    gpu_per_node=1,
    queue_name='gpu-8p100-hs',
    group_size=0,
    para_deg=1,
    slurm_job_size=2,
    custom_gpu_line='#SBATCH --gres=gpu:p100-16g:1',
)
实际完整程序还设置节点选择、模块、时限、环境变量和输出文件,均在worker_arrays.py中。
| 设置 | 本例含义 |
|---|---|
group_size=0 |
三个Task归入同一个DPDispatcher作业 |
slurm_job_size=2 |
每个Slurm数组子任务最多处理两个Task,因此生成两个数组子任务 |
para_deg=1 |
同一个数组子任务内,任务逐个执行 |
gpu_per_node=1 |
每个数组子任务申请一张GPU |
当两个数组子任务同时运行时,一共可能占用两张GPU。这里每个LAMMPS计算只用一张卡,不是一个计算联合两张卡。三个Task的分组如下,表格来自真实执行记录:
| 输入目录 | 距离 / σ | 数组子任务 | 同子任务中的计算数量 |
|---|---|---|---|
task-0 |
1.05 | 0 | 2 |
task-1 |
1.1224620483 | 0 | 2 |
task-2 |
1.40 | 1 | 1 |
库会以固定随机种子安排任务分组,不能只按最初列表位置猜数组编号。更改任务数或分组后,应查看生成脚本与实际结果。
3. 实际计算输入#
实际运行LAMMPS 30Sep2026的GPU包,GCC/G++ 13.3、OpenMPI 5.0.10、CUDA 12.8,mixed精度;控制环境为DPGEN 0.14.0、Python 3.12、DPDispatcher 1.1.0。
三个距离为1.05、2^(1/6)、1.4,周期盒长20,epsilon=sigma=1,截断2.5,不做势能平移。下面是距离1.05时的完整真实输入;payload.py会据param.json自动生成对应输入:
package gpu 1
newton off
units lj
atom_style atomic
boundary p p p
region box block 0 20 0 20 0 20
create_box 1 box
create_atoms 1 single 9.475 10 10 units box
create_atoms 1 single 10.525 10 10 units box
mass 1 1
pair_style lj/cut/gpu 2.5
pair_coeff * * 1.0 1.0
neighbor .3 bin
thermo_style custom step atoms pe
thermo_modify norm no format float %.16g
run 0
write_dump all custom final.dump id type x y z fx fy fz modify sort id format float %.16g
print "$(pe:%.16g)" file energy.dat screen no
run 0计算当前坐标的能量和力,适合检查任务分发和输出,不是动力学。LJ单位是约化单位,表中能量用ε、距离用σ、力用ε/σ,不能直接标成eV或Å。
每个任务对象都声明自己的输入与待取回文件:
Task(
    command='srun --cpu-bind=cores python3 payload.py',
    task_work_path='task-0',
    forward_files=['payload.py', 'param.json'],
    backward_files=[
        'result.json', 'native.out', 'final.dump',
        'energy.dat', 'attempts.jsonl'
    ],
    outlog='task.stdout',
    errlog='task.stderr',
)
task_work_path应各不相同,避免不同参数覆盖彼此的文件。把payload.py换成自己的VASP、GPUMD、LAMMPS或其他程序时,也要同步修改输入清单、输出清单、模块与资源设置。
4. 怎样知道数组与计算都完成#
控制程序会等各Task完成并取回输出。另一个终端可以查看:
squeue -u "$USER"
cat p100/header.sh
cat p100/RESULTS.json
本例生成的数组范围是#SBATCH --array=0-1。RESULTS.json包括数组父作业编号、各Task对应的数组子任务,以及真实程序输出。squeue中看不到任务后,还需检查result.json、程序正常结束及计算本身的数值;排队结束并不代替科学结果检查。
cat p100/local/task-0/result.json
tail -n 15 p100/local/task-0/native.out
cat p100/local/task-0/energy.dat
5. 实际能量和力#
两个GPU平台在本例的输出一致。下面给出每个距离的实际值,完整数据在analysis/native-array-results.csv:
| 距离 / σ | 能量 / ε | 原子1的x方向力 / (ε/σ) |
|---|---|---|
| 1.05 | -0.7575054169 | -8.3992280960 |
| 1.1224620483 | -1.0000000000 | -0.0000433312 |
| 1.40 | -0.4606875777 | 1.6719992161 |
解析平衡距离处的力应为零;这里mixed精度真实输出保留了约4.33E-5的残差,没有改写成零。配套程序同时计算闭式LJ能量、力及独立能量差分,检查两个原子的力方向与大小。
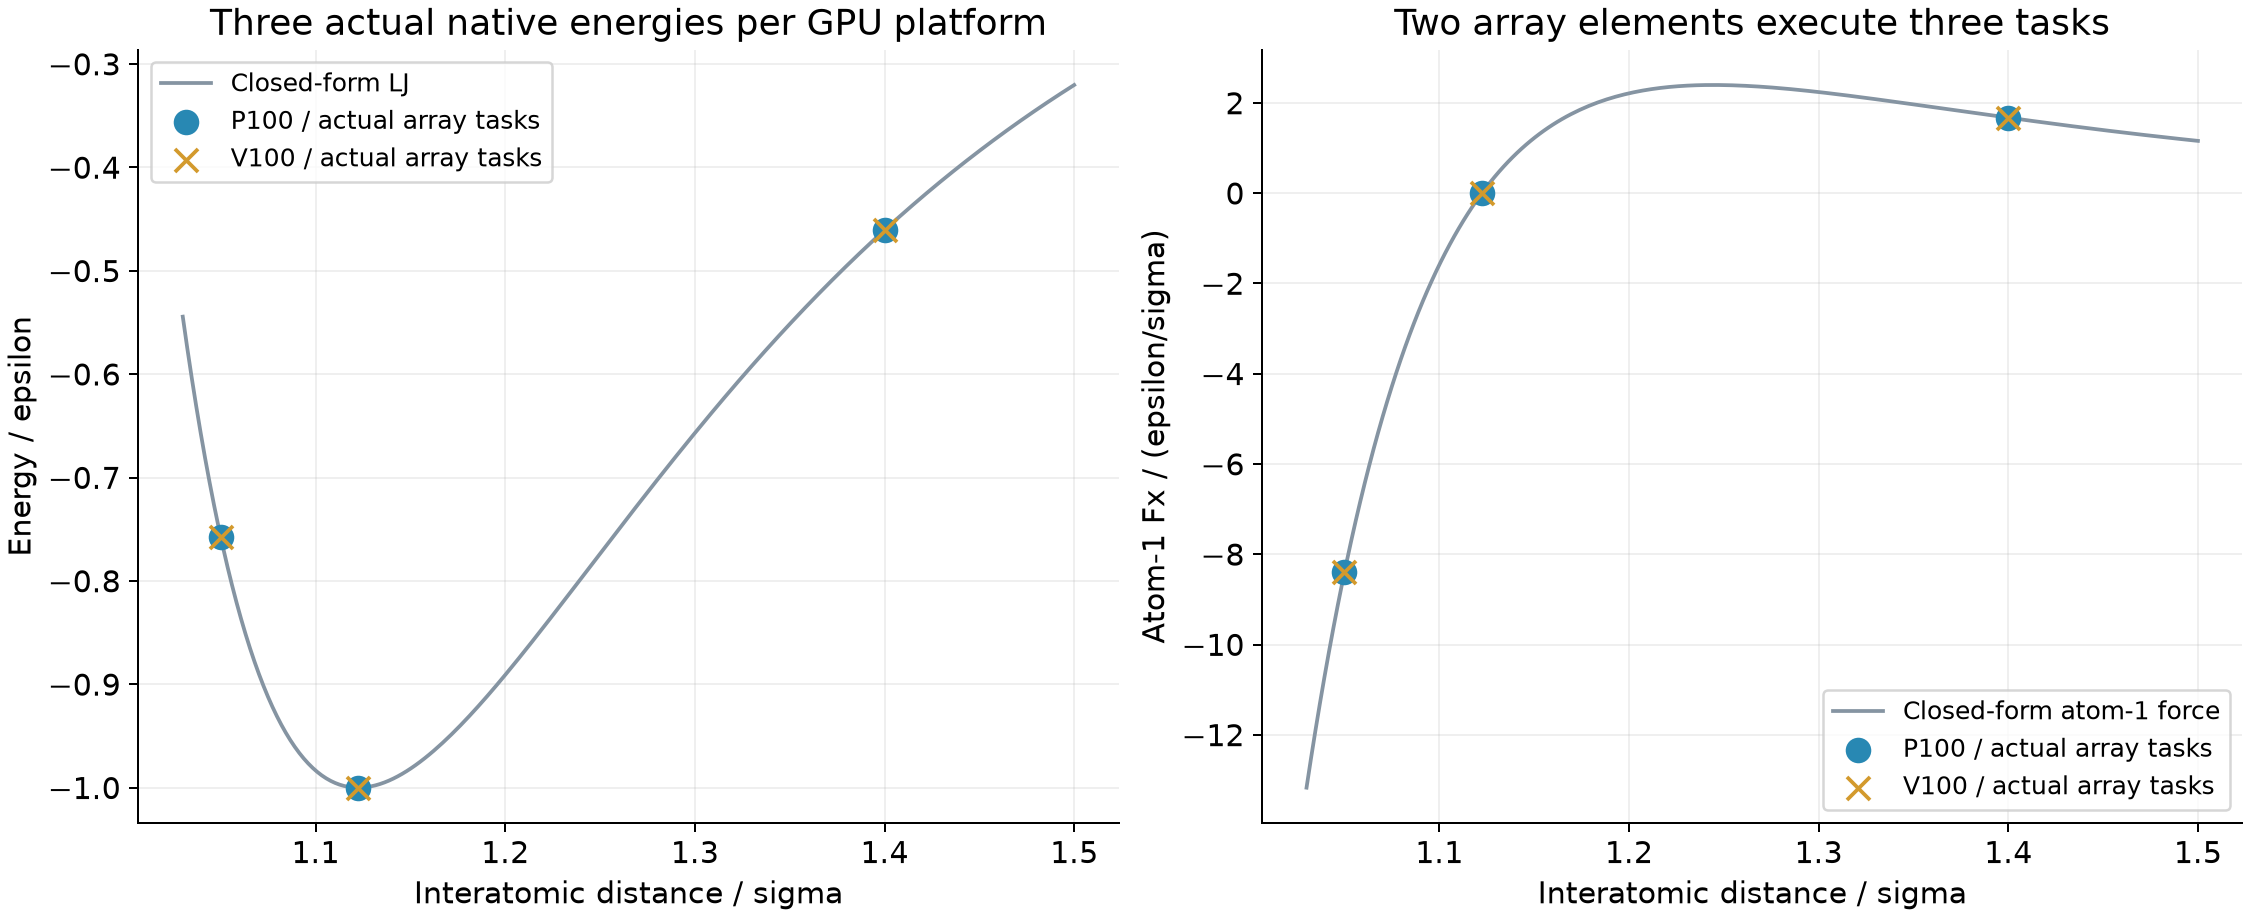
这个小体系用来展示批量操作与结果整理,不反映GPU加速比、并行性能或真实材料性质。
6. 提取、画图与改成自己的批量任务#
已完成两个硬件条件后:
module load dpgen/0.14.0
python analyze.py
python plot.py
输出三张CSV:backend-support.csv列后端条件,array-mapping.csv列任务与数组对应关系,native-array-results.csv列真实能量和力;两张PNG位于figures/。分析和绘图会复用已有计算结果。
换成自己的多个结构时,先给每个结构独立目录和输入,再按任务长短设置group_size与slurm_job_size。短任务可归到同一数组子任务,较长任务可一Task一子任务;每个子任务的CPU/GPU/内存与时限都要满足其中的计算。故障恢复与文件取回参考恢复教程,全部后端的外部条件见后端选择。数组资源字段的定义见DPDispatcher官方资源文档。