
Gaussian CPU与GPU单卡实操
完整输入、短命令提交、真实苯分子能量力对照与实际CUDA内核记录。
阅读本篇目录
本篇用固定几何的苯分子 C₆H₆,12原子、102基函数,演示Gaussian16 C.01 AVX在CPU、P100 16G和V100 16G上的操作。计算HF与B3LYP/6-31G(d)的能量和解析力,比较同一几何与方法的CPU/GPU数值,并检查实际CUDA内核记录。
1 先查看参考结果#
unzip gaussian-CPU-GPU-wave271*.zip
cd gaussian-CPU-GPU-wave271
bash run.sh
ls figures
这一步读取随包实算数据并重画两张图,不运行Gaussian、不提交作业。包内有4张CSV数据表及精选能量/力数值,不包含程序或完整波函数。
2 初始化自己的环境,再提交#
Gaussian按账号独立初始化,不使用公共Gaussian module:
yskit gaussian-init
bash submit.sh p100
squeue -u "$USER"
要在V100 16G运行相同例子:
bash submit.sh v100
只运行你要使用的平台即可。附件中的参考包含两种显卡;自己的结果不要求同时有P100和V100。每次提交使用 一张显卡、2个总CPU物理核心,该作业中的六个小条件顺序运行,不会为一个计算自动申请多张显卡。
两个提交入口会在实际提交前查询当前排除分区成员并生成排除参数。输入与程序目录由脚本自动衔接,不需要自己拼接长命令。重新运行请用新的解压目录,已经存在的 work/p100、work/v100-16g 会受到保护。
3 作业依次做什么#
每个平台的流程为:HF的CPU对照 → HF单卡 → HF带内核报告的单卡 → B3LYP的相同三种模式。最后两种单卡模式的区别是是否输出诊断记录,计算方法、基组、几何和总CPU核数保持相同。
作业结束后运行:
bash results.sh
cat analysis/gaussian-GPU-results.csv
cat analysis/gaussian-GPU-differences.csv
ls figures
results.sh 提取自己的原始输出与检查点数值,比较能量/力、生成CSV和两张图。它支持只完成一个平台的情况。之后再次运行 bash run.sh 会重画附件的固定参考;bash results.sh 画的是你自己的结果。
4 实际Gaussian输入#
下面是本例P100上实际使用的一份HF输入。%CPU和%GPUCPU中的CPU编号是当时作业内允许的编号;附件运行时会根据新的Slurm分配重新填写,不要把6、7固定照抄到自己的作业。
%Chk=result.chk
%Mem=2GB
%NProcShared=2
%CPU=6,7
%GPUCPU=0=6
#p HF/6-31G(d) Force NoSymm SCF=(Tight,MaxCycle=100)

Benzene fixedgeometry CPU-GPU matchedresource teaching example

0 1
C 0.0000000000 1.3952480000 0.0000000000
C 1.2083200000 0.6976240000 0.0000000000
C 1.2083200000 -0.6976240000 0.0000000000
C 0.0000000000 -1.3952480000 0.0000000000
C -1.2083200000 -0.6976240000 0.0000000000
C -1.2083200000 0.6976240000 0.0000000000
H 0.0000000000 2.4823600000 0.0000000000
H 2.1497870000 1.2411800000 0.0000000000
H 2.1497870000 -1.2411800000 0.0000000000
H 0.0000000000 -2.4823600000 0.0000000000
H -2.1497870000 -1.2411800000 0.0000000000
H -2.1497870000 1.2411800000 0.0000000000
CPU模式保留相同的2个总CPU核心,删除 %GPUCPU 并隐藏CUDA设备。B3LYP模式将计算路线换为:
#p B3LYP/6-31G(d) Force NoSymm SCF=(Tight,MaxCycle=100) Integral=UltraFine
这是固定结构的能量与解析力,不是结构优化,也不使用本例的残余力作为优化完成依据。两种方法的绝对能量不同,不应把它们相减当成同一种方法的反应能。
5 实际能量与力对照#
| 平台 | 方法 | CPU能量 Ha | 单卡能量 Ha | 单卡内核报告条件 |
|---|---|---|---|---|
| P100 16G | HF | -230.702048438276 | -230.702048438276 | 343次 |
| P100 16G | B3LYP | -232.248639217679 | -232.248639217680 | 62,765次 |
| V100 16G | HF | -230.702048438277 | -230.702048438276 | 314次 |
| V100 16G | B3LYP | -232.248639217679 | -232.248639217679 | 61,968次 |
能量是每个完整苯分子的总量。HF与B3LYP分别比较同方法CPU与GPU;全部36个力分量逐项比较。示例采用能量差小于 10⁻⁷ Ha、最大力分量差小于 10⁻⁶ Ha/Bohr 的判断条件,原始完整数值见CSV。
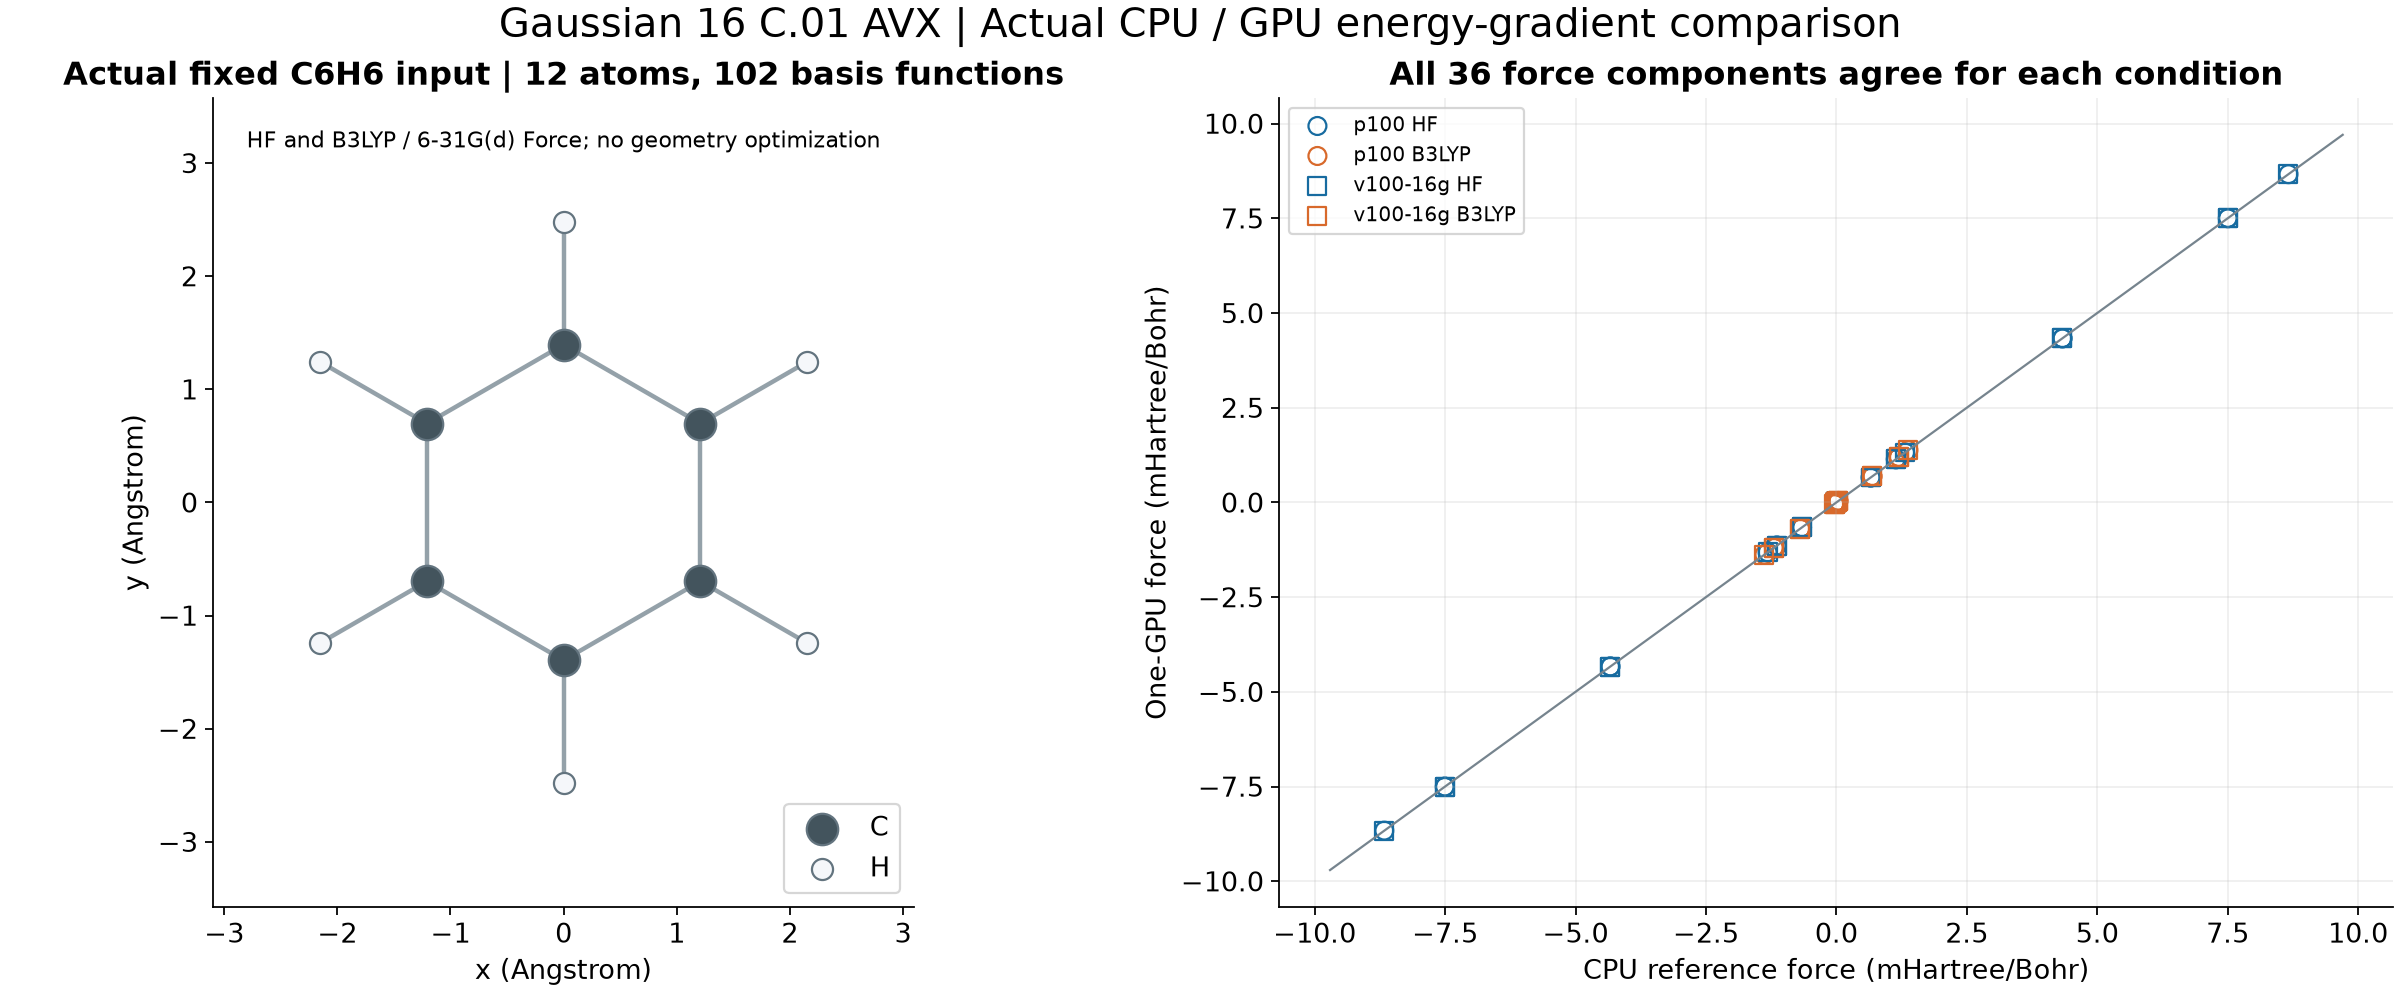
左图按本例实际输入坐标画出C、H与连接关系;右图单位为mHartree/Bohr,1mHartree=10⁻³Ha。不同方法产生不同力,图中CPU/GPU对照接近同一条对角线。
6 如何确认GPU实际参与了计算#
cat work/p100/hf-gpu/input.gjf
cat work/p100/hf-gpu-notify/input.gjf
grep 'Will use' work/p100/hf-gpu/output.log
grep -c '^launch CUDA kernel ' work/p100/hf-gpu-notify/stderr.log
cat analysis/gaussian-GPU-kernels.csv
设备识别、显存占用与CUDA库加载只能说明准备过设备,不能单独证明计算内核执行。本例另做带运行时报告的条件,实际记录到HF、B3LYP的CUDA内核启动,随后原生计算正常结束,所得能量和力仍与CPU对照一致。
本集群C.01旧运行时寻找的报告库名字是 libaccnotifymp.so,已安装NVIDIA工具链中的报告库使用较新名称。附件在自己的工作目录建立字节相同的报告库副本并仅对该进程加载;不会更换计算数学运行时、CUDA驱动或公共程序。这个报告库来自NVIDIA HPC SDK25.3,不表示Gaussian程序用25.3重新编译,当前Gaussian仍是厂商C.01 AVX二进制。
内核记录是OpenACC的入队/启动通知,不是每个内核的GPU执行时长。通知数还会随硬件分块、调度和运行条件变化,不要求重跑时与参考逐次完全相同;能量与力仍按上节数值条件比较。
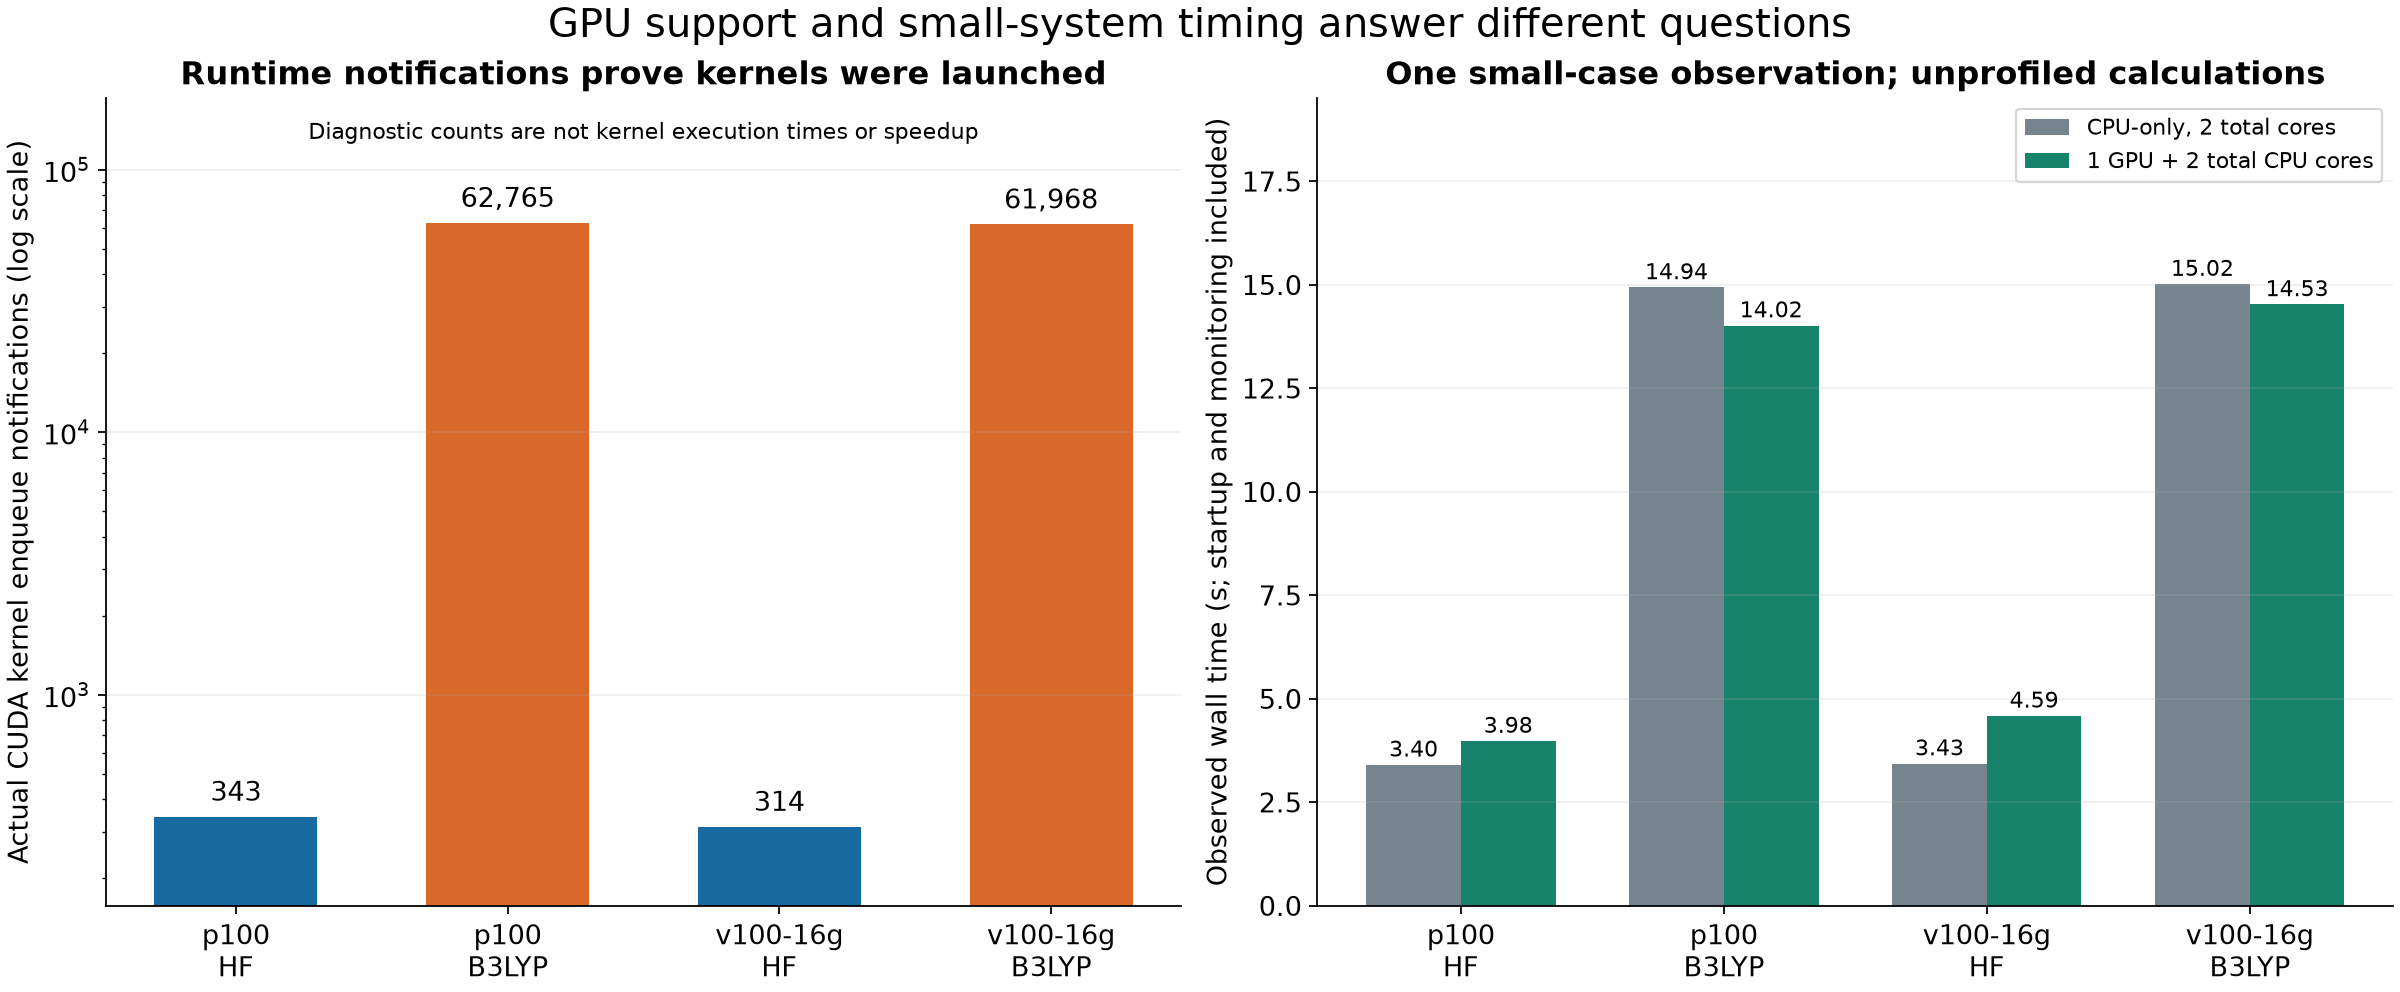
左图的内核记录来自报告条件,右图来自另外的未开启报告条件。右图是一次小例子的记录墙时,包含程序启动、I/O和监测开销,不能据此宣传所有体系的加速倍数。本例V100的HF单卡还比2核CPU对照稍慢;判断是否采用GPU,要结合自己的体系规模和主要耗时步骤。
7 换成自己的体系#
先替换 inputs/benzene.json 的元素、坐标、电荷与多重度,再在 run_cases.py 中按研究目标设置方法、基组和路线。不要把B3LYP的路线名随意改成任意相关方法就认定支持相同GPU路径。真实生产任务通常只运行自己需要的方法与模式,不必重复这套教学对照的六个条件。
显卡对应版本、CPU控制核心、内存和scratch的详细说明见 Gaussian GPU资源与版本边界。官方资料:GPU功能简介、C.01/C.02平台矩阵。