
Gaussian GPU资源与版本边界
厘清版本与方法支持、CPU控制核心、主机内存和显存、scratch及实际内核检查。
阅读本篇目录
选择Gaussian的GPU环境,先核对 程序修订版、二进制类型、显卡、具体方法、CPU控制核心与内存,再修改输入。集群提供按用户初始化的Gaussian16 C.01 AVX厂商二进制,没有可套用的本地编译器/MPI版本;示例中的辅助报告工具链不改变程序构建身份。
本篇与 CPU/GPU单卡实操 共用一个附件:
1 当前版本能对应哪些显卡#
| 条件 | 依据与使用方式 |
|---|---|
| C.01 AVX + P100 | 官方列出支持,本例实际完成HF/B3LYP解析力与内核通知 |
| C.01 AVX + V100 | 官方列出支持,本例使用V100 16G完成同样对照 |
| A100 | 官方矩阵要求C.02的AVX2二进制,不能把C.01的P100/V100结果直接套用 |
| 其他二进制类型或新显卡 | 重新核对厂商平台矩阵、驱动与具体运行条件,不凭CPU指令集名称推定GPU支持 |
官方C.01矩阵要求适合CUDA10.0的驱动,并列出至少12GB显存的相应GPU。不要把系统 nvcc --version 的版本当成Gaussian厂商二进制编译时使用的CUDA版本,也不要为一个旧程序直接替换共享驱动。
yskit gaussian-init
source ~/.config/yskit/gaussian/env.sh
command -v g16
实际运行后,程序修订版与平台信息在自己的 output.log 开头。附件不会分发Gaussian程序,使用已有的个人初始化环境。
2 方法支持与本例实际覆盖要区分#
| 层次 | 能说明什么 |
|---|---|
| 官方GPU范围 | 厂商资料覆盖HF、DFT及相关TD、优化、频率和主要性质,并提到溶剂与ONIOM等路径 |
| 本例实算 | HF、B3LYP/6-31G(d)固定苯分子的能量和解析力;P100/V10016G单卡 |
| 其他相关方法 | MP2、CCSD(T)、CAS等不能由HF/DFT资料推定整个方法已GPU加速,需按该版本方法说明单独确认 |
| 完整计算中的不同步骤 | Gaussian只有部分代码在GPU上并行,初始准备、部分积分、对角化或后处理仍可能主要用CPU |
本例证明实际CUDA内核启动、原生计算完成和CPU/GPU数值一致,不证明每个关键词组合都使用GPU,也不把只运行CPU的后续步骤计算为GPU加速。已发布的其他Gaussian方法教程仍可用来确定研究步骤与输入,是否有相应GPU路径需另行核对。
3 一个GPU需要几个CPU核心#
本例Slurm的资源段为:
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=2
#SBATCH --gres=gpu:p100-16g:1
#SBATCH --mem=8G
这表示总计2个CPU核心和1张P100,不是2个用于计算的核心再额外送1个控制核心。Gaussian输入中的一组示意关系为:
%NProcShared=2
%CPU=6,7
%GPUCPU=0=6
GPU可见编号0由CPU6控制,CPU6包含在总CPU集合6、7中。编号只作当时实际例子,脚本会从Slurm亲和性中选择两个不同物理核心后自动填写,不使用超出分配的CPU,也不把超线程误当额外物理核心。
V100入口改用相应分区与 gpu:v100-16g:1,仍是一张卡。Slurm全局GPU编号与作业内隔离后的本地编号可能不同;附件结合当前可见设备与UUID核对,不直接把全局编号写进 %GPUCPU。
bash submit.sh p100
# 或者选择V100 16G
bash submit.sh v100
CPU对照在同一GPU节点上隐藏CUDA设备、使用相同2个总CPU核心;它不代表专用Intel Xeon 8173M节点的性能,也不是56核心CPU与一张GPU的比较。
4 主机内存、显存与scratch不是一回事#
%Mem=2GB
%Chk=result.chk
%Mem 是Gaussian的主机内存设置,不是显卡显存;Slurm的 --mem 还需留出程序、GPU控制进程和其他运行开销。GPU同样需要相应控制端内存,不能只看显卡还有空余就把主机内存压得很低。
附件给这份小体系设置 %Mem=2GB,Slurm申请8GB主机内存;换大分子、高基组、频率或相关方法时应根据自己的实际内存和磁盘需求重新配置。这些数值不是对所有体系都适用的固定模板。
每个条件都有独立scratch目录和独立checkpoint:
ls work/p100/hf-gpu
ls work/p100/hf-gpu/scratch
df -h .
du -sh work
GAUSS_SCRDIR 由脚本指向当前条件自己的目录,不共享一个固定临时路径。正常结束后部分临时文件会被程序移除;需要后处理或续算时保存自己的checkpoint和必要中间文件,不要只留一张图。
5 完成后按什么顺序检查#
grep 'Normal termination' work/p100/*/output.log
grep 'SCF Done' work/p100/hf-gpu/output.log
bash results.sh
cat analysis/gaussian-GPU-differences.csv
先看原生程序是否正常结束、方法与输入是否符合目标,再看能量、力和结构。需要确认GPU参与时,再看带报告条件的内核记录:
grep -c '^launch CUDA kernel ' work/p100/hf-gpu-notify/stderr.log
cat analysis/gaussian-GPU-kernels.csv
报告目录内 notify-runtime/libaccnotifymp.so 是现有NVIDIA报告库的项目内同字节副本,用于兼容旧运行时的报告库名称。它不是新的Gaussian版本,也不替换GPU数学核心或驱动。普通计算条件不开启该报告,便于把报告开销与常规墙时分开。
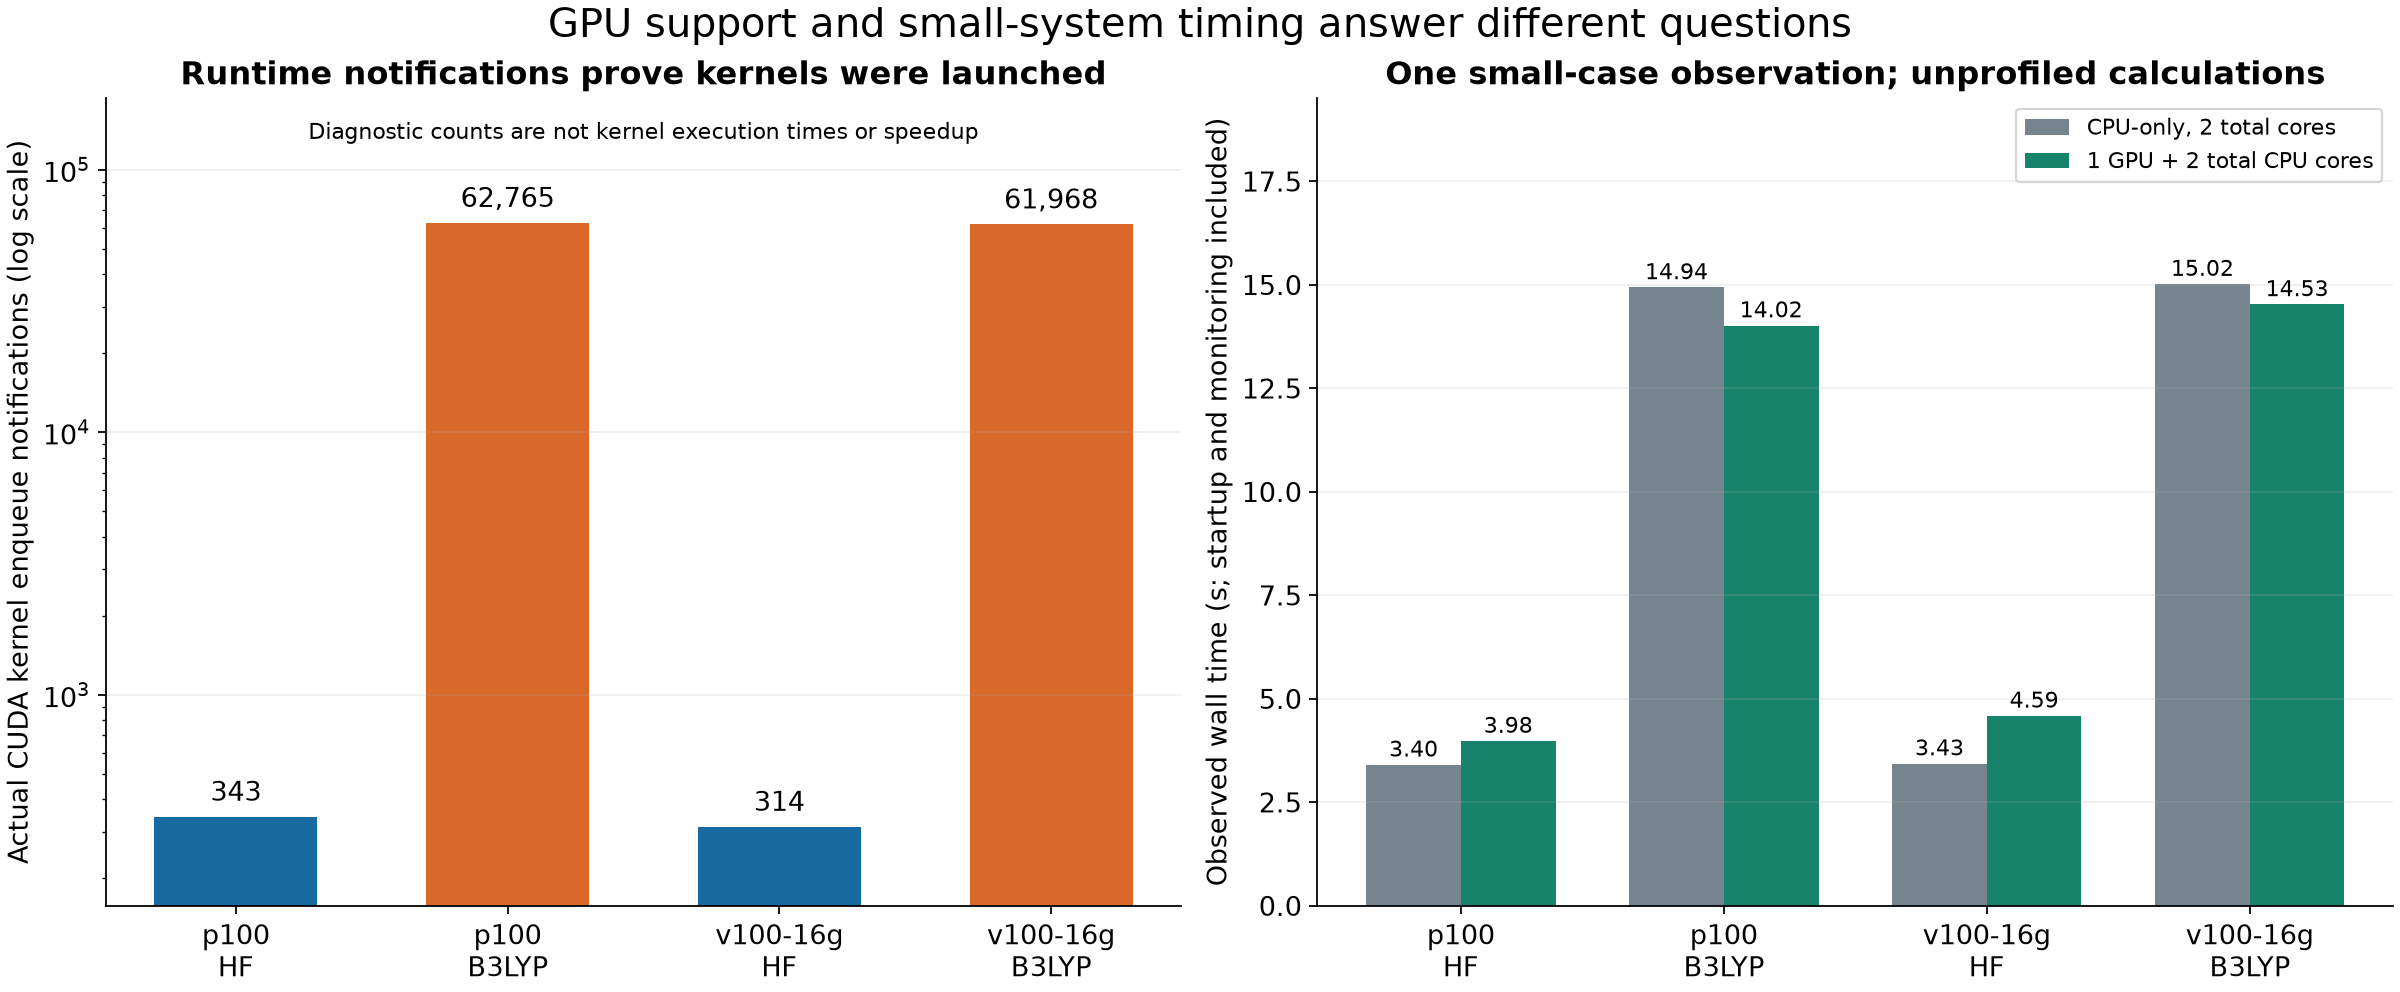
不要把OpenACC启动通知之间的CPU时间当作GPU内核执行时长。重复运行的通知数和墙时可能变化,应保留自己的数据;数值对照仍使用相同能量和力条件。这个小例展示了GPU真实使用和正确提交方式,选择生产资源时还应参考实际体系规模。