
PLUMED WHAM 去偏置与自由能
拼接真实窗口数据,运行七副本WHAM并用解析答案和时间分块检查结果。
阅读本篇目录
接续 伞形采样窗口,本篇把同一组真实轨迹交给原生 PLUMED WHAM,并比较独立计算与已知解析自由能。
1. 已有轨迹只重做分析#
完整输入与参考数据下载。完整计算用 bash sample.sh,已有 work/ 的用户不需要为画图重跑轨迹:
bash analyze.sh work new-analysis
bash plot.sh new-analysis own-figures
cat new-analysis/summary.json
分析目录必须是新目录;程序保留原结果,不覆盖现有分析。只想看参考图时执行 bash run.sh。
2. 拼接前先统一条件#
本例各窗口有相同温度、基础势和样本数量。分析只保留每条轨迹时间大于 200 的部分,共每窗口 8000 帧;按窗口顺序拼成一份数据,每个随机种子组总共 56000 帧。每个 WHAM 副本都读取这份相同的完整拼接数据,并按自己的目标位置重新计算偏置。
本例 all.COLVAR 有 time x y 字段。程序额外放一行独立的 step 0 记录,因为原生收集分析忽略初始步;它不是多出来的一帧采样,不计入 56000。
head -n 5 work/analysis/native-101/all.COLVAR
cat inputs/wham.dat
3. 完整 WHAM 输入#
UNITS NATURAL
x: READ FILE=all.COLVAR VALUES=x IGNORE_TIME IGNORE_FORCES
b: RESTRAINT ARG=x AT=@replicas:{-1.2,-0.8,-0.4,0,0.4,0.8,1.2} KAPPA=20
h: WHAM_HISTOGRAM ARG=x BIAS=b.bias TEMP=1 GRID_MIN=-1.8 GRID_MAX=1.8 GRID_BIN=180
f: CONVERT_TO_FES GRID=h TEMP=1
DUMPGRID GRID=f FILE=fes.dat
WHAM_WEIGHTS BIAS=b.bias TEMP=1 FILE=weights.dat FMT=%.16e
READ ... IGNORE_TIME 顺序读拼接后的 x;IGNORE_FORCES 仅用于离线分析,因为文件中读入的集体变量没有对原子坐标的导数。它允许重算偏置能,不表示在线动力学也可以忽略偏置力。
AT=@replicas:{...} 给七个副本各自的中心。BIAS=b.bias 只去掉伞形偏置;不能使用默认全部 *.bias,把本例用 BIASVALUE 定义的基础物理势也一并去掉。否则得到的统计对象已经改变。
WHAM_HISTOGRAM 输出去偏置的分布,CONVERT_TO_FES 再转为自由能。WHAM_WEIGHTS 输出每帧权重,便于独立检查。
在分析目录内的原生命令为:
mpirun -np 7 plumed driver --noatoms   --plumed wham.dat --multi 7 --timestep 1
head -n 8 fes.0.dat
head -n 5 weights.0.dat
这里的七副本是后处理,不是七个窗口在互换坐标,也没有生成新的动力学轨迹。结果文件名中 .0 表示负责输出的分析副本。
4. 实际结果如何判断#
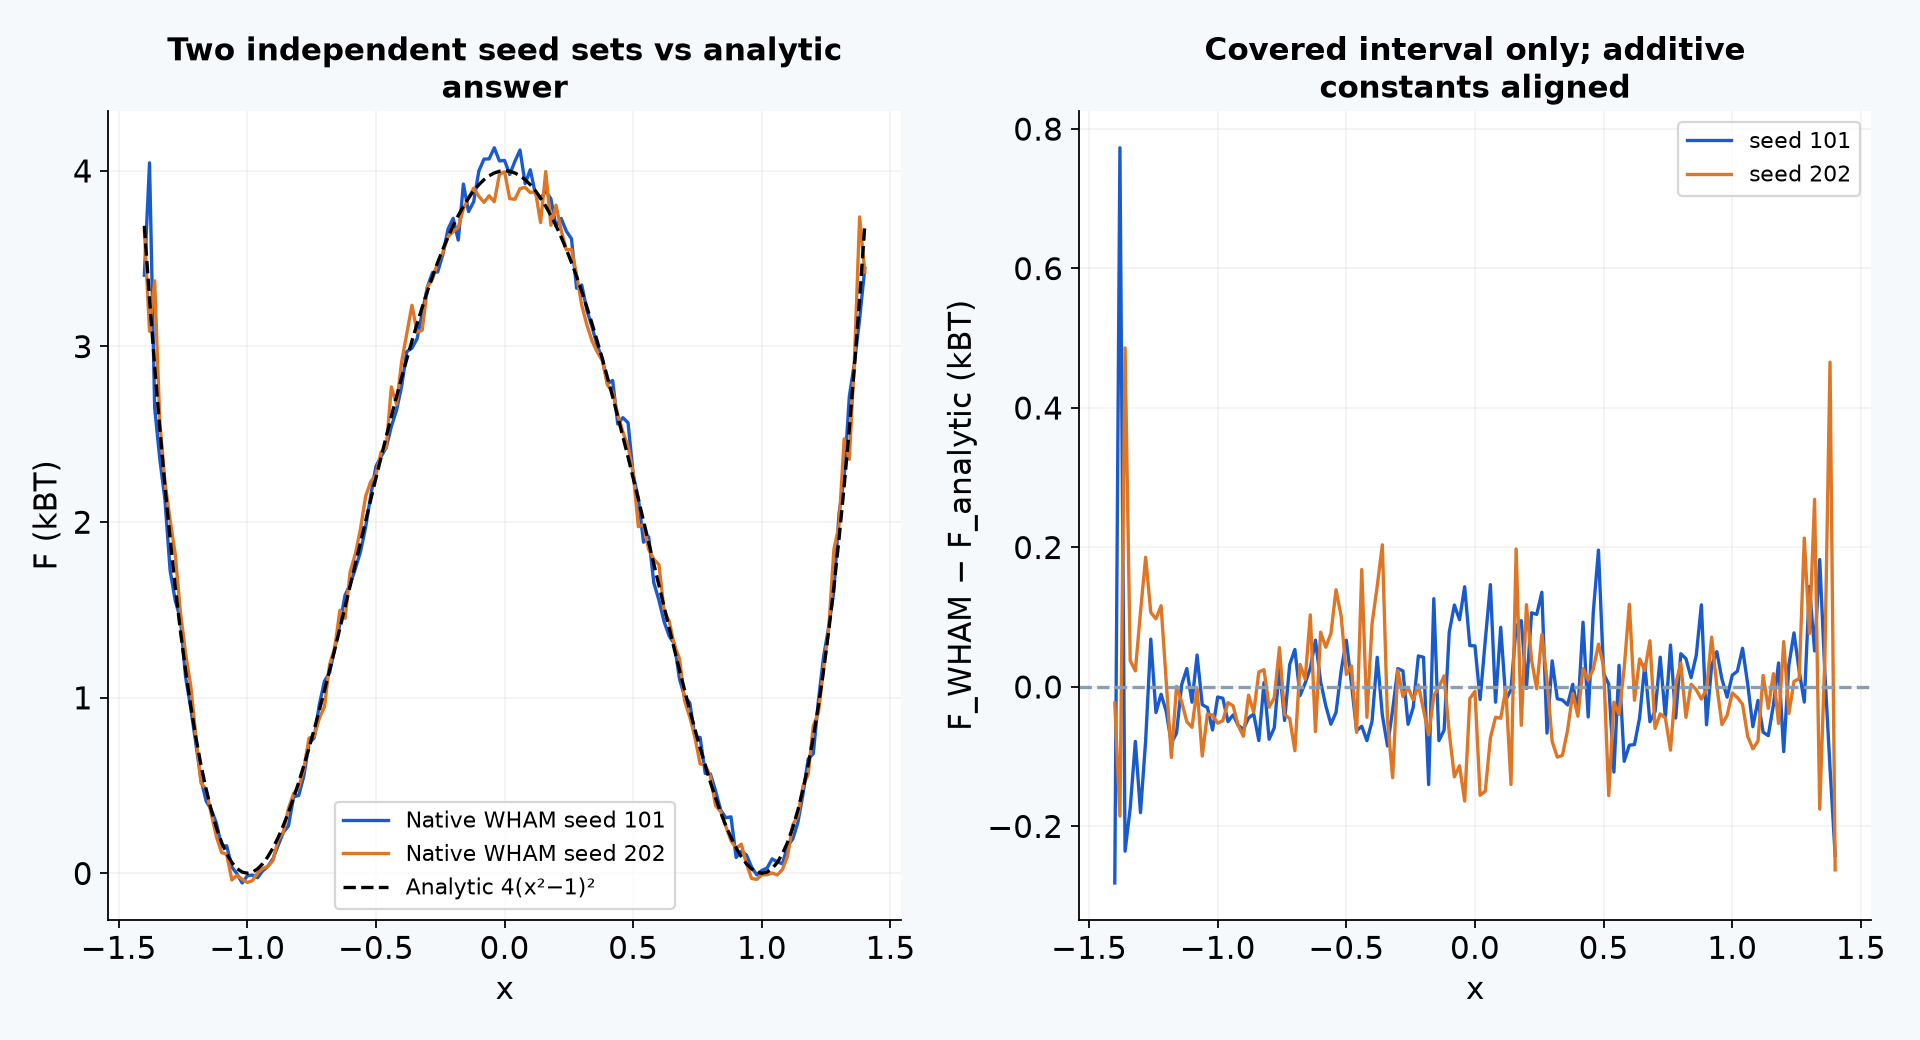
两组实际采样在已覆盖的 −1.4≤x≤1.4 区间,相对解析自由能的均方根误差分别约 0.1008、0.0995 kBT。这是整个区间的统计量,边缘个别点误差更大;不能把它解释成所有点均有 0.1 kBT 精度。
原生权重与独立 binless WHAM 的最大相对差约 2.3×10⁻¹³、3.1×10⁻¹³,直方图也独立核对。数值算法一致,只说明分析实现和输入匹配;它并不能证明轨迹已经充分采样。
没有采到的网格点保留无穷大/未知,不填补成任意有限能量。绘图只展示明确采样覆盖的区间。输出的原始权重 ESS 未扣除时间相关性,不能直接当作独立样本数。
head -n 8 work/analysis/fes-101.csv
head -n 8 work/analysis/fes-202.csv
cat work/analysis/summary.json
5. 短数据块会怎样变化#
把每窗口留下的 8000 帧按时间分成四块,每块各取 2000 帧再合并七个窗口,每次分析有 14000 帧。本次八个数据块的能垒估计约为 3.48–4.34 kBT,解析值为 4。它说明即使完整曲线看着接近,短数据块仍有明显波动。相邻块也可能相关,四块不能自动等价为严格置信区间。
可把下面代码保存为 block_sensitivity.py,用包内真实采样 CSV 重做此项检查。代码已在本集群普通账号下实际运行:
"""Run: python block_sensitivity.py reference block-check; reads sampled CSV only."""
from pathlib import Path
import csv,sys
import numpy as np
R=Path(sys.argv[1]);O=Path(sys.argv[2]);O.mkdir(parents=True,exist_ok=False)
centres=np.array([-1.2,-.8,-.4,0,.4,.8,1.2]);grid=np.arange(-1.4,1.4001,.02);edges=np.r_[grid-.01,grid[-1]+.01];rows=[]
for seed in [101,202]:
    a=np.loadtxt(R/('samples-'+str(seed)+'.csv'),delimiter=',',skiprows=1)
    for block in range(4):
        x=np.concatenate([a[a[:,0]==i,1][block*2000:(block+1)*2000]for i in range(7)])
        e=np.exp(-10*(x[:,None]-centres)**2);z=np.ones(7)
        for it in range(1000):
            w=1/np.sum(e/z,axis=1);w/=w.sum();new=w@e;new/=new.sum();change=np.sum(np.log(new/z)**2);z=new
            if change<1e-10:break
        else:raise RuntimeError('WHAM block convergence')
        h,_=np.histogram(x,edges,weights=w);n,_=np.histogram(x,edges);ok=(h>0)&(n>=5);F=np.full_like(h,np.nan);F[ok]=-np.log(h[ok]);truth=4*(grid*grid-1)**2
        F[ok]-=np.mean(F[ok]-truth[ok]);rmse=float(np.sqrt(np.mean((F[ok]-truth[ok])**2)))
        # Report finite-block sensitivity; blocks can remain correlated with one another.
        j0=np.argmin(np.abs(grid));j1=np.argmin(np.abs(grid-1));barrier=float(F[j0]-F[j1])
        rows.append([seed,block,14000,rmse,barrier,int(ok.sum())])
with(O/'blocks.csv').open('w')as f:
    w=csv.writer(f);w.writerow(['seed','block','samples','RMSE_kT','estimated_barrier_kT','covered_bins']);w.writerows(rows)
print((O/'blocks.csv').read_text())
/public/toolkit/miniconda3/envs/ase-3.29.0/bin/python   block_sensitivity.py reference block-check
cat block-check/blocks.csv
更换体系时,先检查相邻窗口重叠、平衡段选择和时间相关,再延长不足的窗口;不要只增加直方图的网格数来伪装成更高统计精度。本例的解析势检查帮助理解流程,不提供真实材料的收敛 PMF。