
VTST ML优化器实操
使用独立ML修订环境,准备PyAMFF输入,理解在线训练、局部替代势、DFT检查和LBFGS切换,并读取实际两原子Si结果。
阅读本篇目录
VTST的 IOPT=8 在优化过程中用实际DFT能量和力训练一个局部神经网络替代势,再用它辅助更新,并结合真实DFT检查和后续优化。它和普通LBFGS的输入、环境与输出都不同。
本篇继续使用优化器对照中的两原子Si模型,示范完整操作与真实结果。这个极小模型没有展示DFT调用加速;最终结构仍由DFT力判断,局部训练产物也不直接作为可转移的Si分子动力学势。
1 加载专门的ML环境#
module purge
module load vasp/6.6.1-8173m-vtst-mlfix
module list
command -v vasp_std
这是独立的CPU std构建:VASP 6.6.1、VTST revision214的6.6.0接口,使用oneAPI 2024.2、Intel MPI 2021.13、串行MKL及HDF5 1.14.6。该分支包含ML训练清理状态与真实DFT能量回传的配套修订。
本例使用这个模块,不把普通GPU VTST模块直接当作同一个ML环境。常用 IOPT=1/2/3/4/7 的GPU运行方法仍见上一篇。
2 准备并提交#
python3 -m zipfile -e vtst-optimizers.zip .
cd vtst-optimizers-wave279
bash prepare-ml.sh
cd work/iopt-8
sbatch run.sh
程序复制干净的Si输入、神经网络初始参数文件和POTCAR到新工作目录。CPU分区按现行规则申请整节点;本例只有两个原子,脚本使用2个MPI进程演示接口,不能当成大体系的性能配置。CPU资源暂不可调度时,可以先运行第7节的参考数据分析。
任务中实际执行:
module load vasp/6.6.1-8173m-vtst-mlfix
mpirun -np 2 vasp_std > vasp.log 2>&1
该小模型也实际运行了1MPI,1/2MPI结果一致。并行参数应结合体系、模块和资源申请调整。
3 完整INCAR#
POSCAR和3×3×3 KPOINTS与上一篇相同。ML的完整INCAR为:
SYSTEM=Si2-VTST-IOPT8
ENCUT=450
PREC=Accurate
EDIFF=1E-6
EDIFFG=-0.02
ISPIN=1
ISMEAR=0
SIGMA=0.05
NBANDS=16
LREAL=.FALSE.
LASPH=.TRUE.
ISYM=0
ISIF=2
IBRION=3
POTIM=0
IOPT=8
NSW=160
NELM=150
ALGO=Normal
MAXMOVE=0.10
TIMESTEP=0.20
SDALPHA=0.10
FDSTEP=0.005
LWAVE=.FALSE.
LCHARG=.FALSE.
PYAMFF_MAXEPOCH=500
PYAMFF_MAXITER=15
PYAMFF_SWFTOL=0.05
PYAMFF_MODEL=mlff.pyamff
关键设置:
| 设置 | 作用 |
|---|---|
IOPT=8 |
选择ML/PyAMFF优化路线 |
IBRION=3、POTIM=0 |
由VTST控制位置更新 |
PYAMFF_MODEL=mlff.pyamff |
神经网络初始结构与参数文件 |
PYAMFF_MAXEPOCH=500 |
本例每次训练的最大epoch数 |
PYAMFF_MAXITER=15 |
本例局部替代势上的最大优化次数 |
PYAMFF_SWFTOL=0.05 |
接近极小点时切换到LBFGS的力尺度 |
EDIFFG=-0.02 |
真实DFT自由原子力的最终目标 |
SWFTOL 与 EDIFFG 不是一回事。前者控制路线切换,后者控制最终结构收敛;不能只看到替代势上的力很小就结束整个DFT优化。
4 神经网络文件#
mlff.pyamff 保存指纹、元素、网络结构和初始参数。本例为Si定义4个径向、4个角向Behler–Parrinello指纹,两个隐藏层各5个神经元,使用tanh。完整文件如下:
#Fingerprint type
BP
#Rmins
Si
0.01
# type number
G1 4
# center neighbor eta Rs rcut fpmin fpmax
Si Si 0.005 0.0 3.5 -1.0 10.0
Si Si 0.050 0.0 3.5 -1.0 10.0
Si Si 0.500 0.0 3.5 -1.0 10.0
Si Si 1.000 0.0 3.5 -1.0 10.0
# type number
G2 4
# center neighbor1 neighbor2 eta zeta lambda thetas rcut fpmin fpmax
Si Si Si 0.005 1.0 -1.0 0.0 3.5 -1.0 10.0
Si Si Si 0.005 1.0 1.0 0.0 3.5 -1.0 10.0
Si Si Si 0.005 4.0 -1.0 0.0 3.5 -1.0 10.0
Si Si Si 0.005 4.0 1.0 0.0 3.5 -1.0 10.0
#MachineLearning model type
atomic-NN
#Activation function type
tanh
#Model Structure
2
5 5
#Model Parameters
Si
#Energy Scaling Parameters
NoScaler
1.0 0.0
这是本例在线训练的初始网络描述,不是下载后即可用于其他Si结构的训练好势。换体系时要重新设置元素、指纹、距离尺度、训练参数和适用范围。
程序会写出更新后的模型。准备新任务时从附件干净输入开始,避免把上一次生成的模型误当成同一初始条件。
5 按实际流程查看输出#
整个操作顺序是:
- 从给定结构计算真实DFT能量与力。
- 用已有DFT数据训练局部替代势,并输出训练信息。
- 在局部替代势上尝试优化,再回到DFT检查。
- 接近极小点时切换到LBFGS,并继续满足真实DFT力目标。
grep 'ML-PyAMFF' OUTCAR | head
grep 'ML-PyAMFF: Final:' OUTCAR
grep 'ML-Forces' OUTCAR
grep 'switched to LBFGS' OUTCAR
grep 'reached required accuracy' OUTCAR
tail OSZICAR
训练输出中的 EnergyRMSE、ForceRMSE 是替代势的训练指标;ML-Forces 是替代势上的力。它们都不能直接替代最终DFT受力检查。
这组500 epoch的小模型仍属于局部流程演示,训练误差不能用来声称获得了通用Si势。做自己的研究时,还要根据训练误差、后续DFT检查和独立构型测试判断替代势是否有用。
6 本例得到什么#
1MPI和2MPI两次实际运行都进行了9次DFT受力计算,共51次电子迭代,并经过训练、局部替代势计算及LBFGS切换。最终自由Si原子力约为 0.000374 eV/Å。
随后对最终结构使用独立的普通VASP GPU单点检查:
| 结果 | 总能量 / eV | 自由原子力 / eV·Å⁻¹ |
|---|---|---|
| ML修订构建的最终DFT结果 | -10.22660295 | 0.00037399 |
| 普通VASP独立单点 | -10.22660277 | 0.00039981 |
能量差约 1.8×10⁻⁷ eV,最大原子力分量差约 2.4×10⁻⁵ eV/Å。这里比较的是最终真实DFT结果,不是替代势的预测能量。
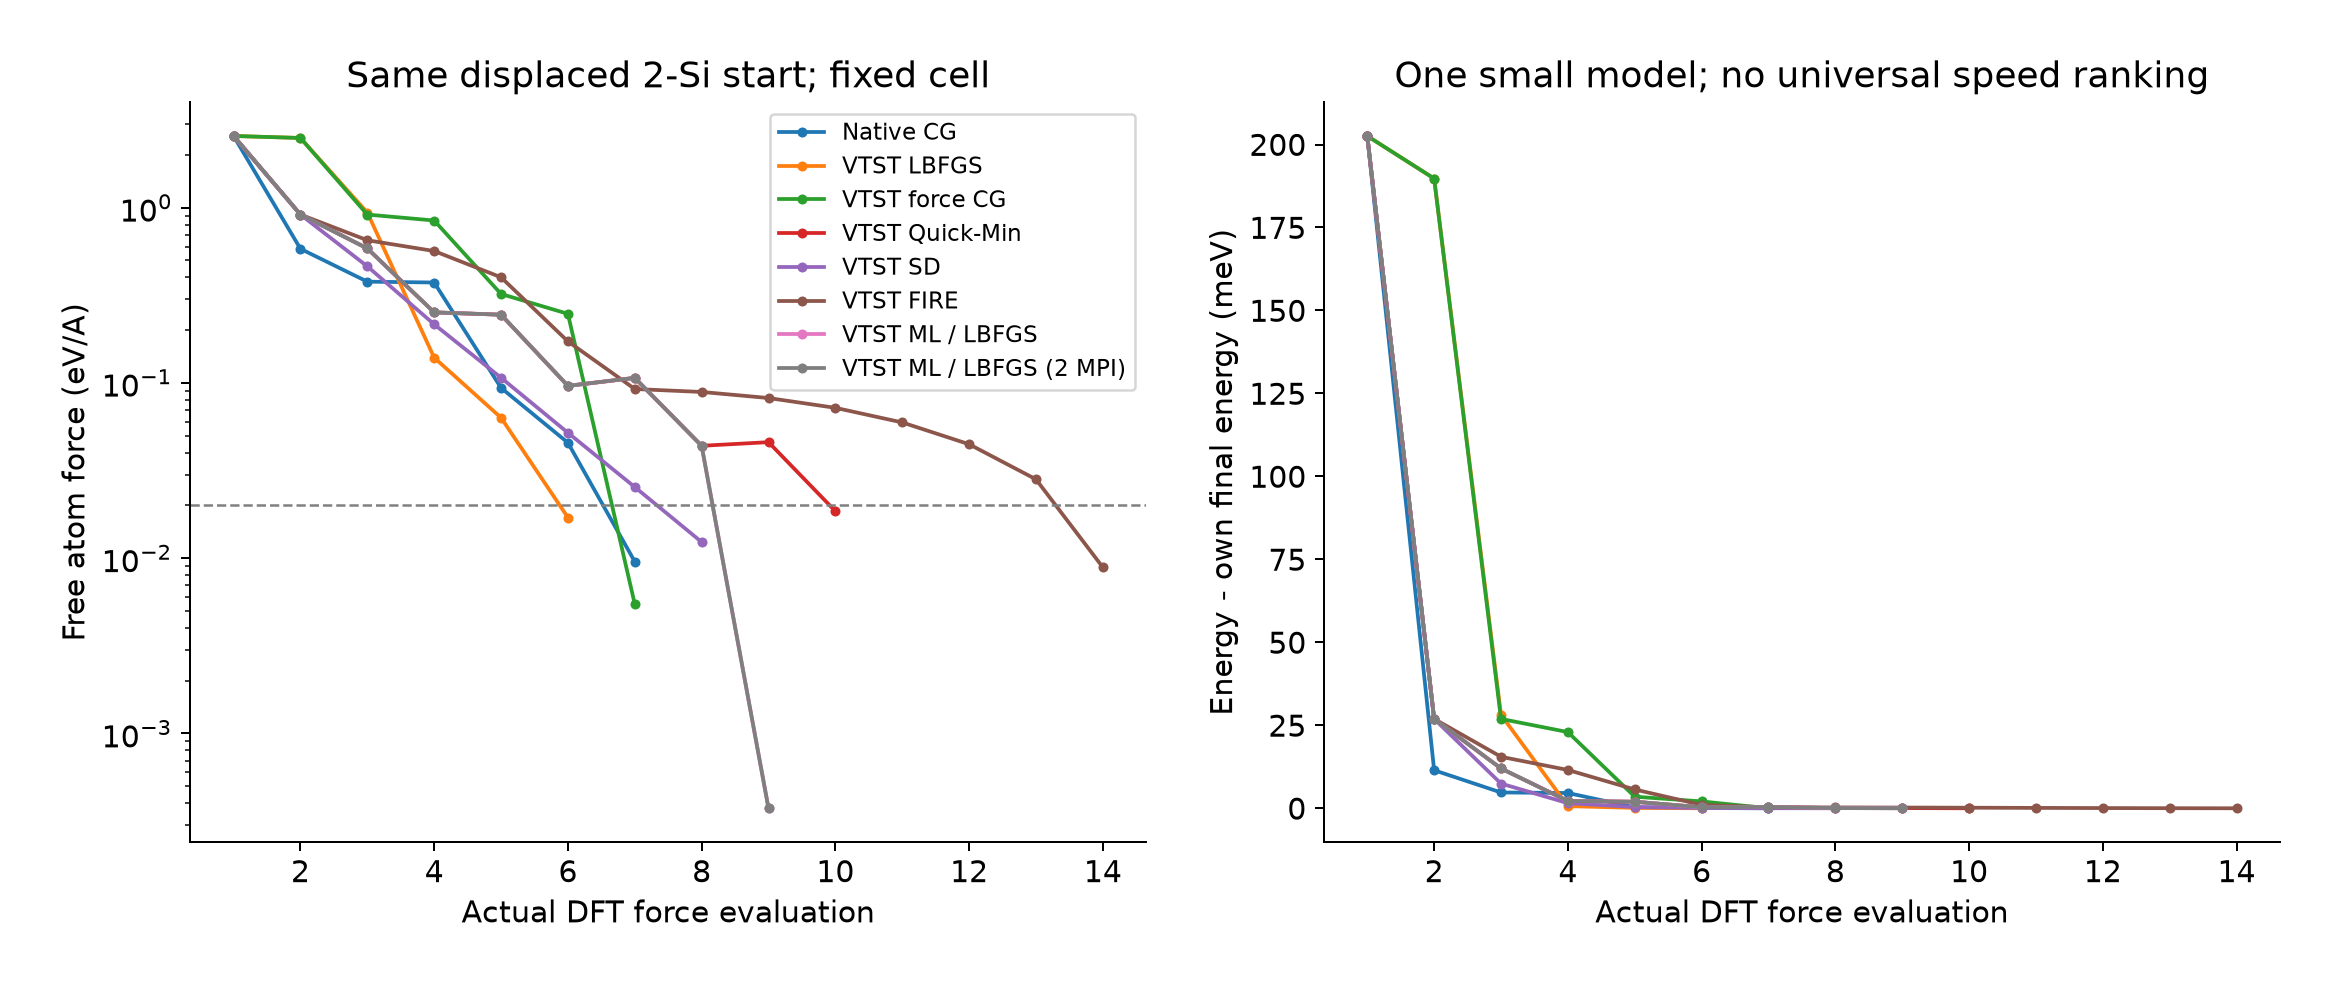
本例普通VASP CG需要7次DFT力调用,ML路线需要9次。因此它说明怎样运行和检查这条路线,不支持“打开ML就一定更快”的结论。
7 重画并分析自己的结果#
bash run.sh
head analysis/summary.csv
ls analysis/figures
新计算结束后:
module load ase/3.29.0
python analyze.py work analysis-my-ML
脚本针对这组两原子、固定第1个原子的模型提取真实DFT力与能量。换成实际材料后,相应修改自由原子选择和结构处理,再比较各优化方法。
方法参数见VTST官方优化器说明。常规选择、完整Si结构和KPOINTS见优化器选择与收敛。