
MACE原生HDF5数据预处理
用mace_prepare_data把真实能量力、偶极和极化率标签转为分片HDF5,完整读取并解释原始晶胞与邻居图。
阅读本篇目录
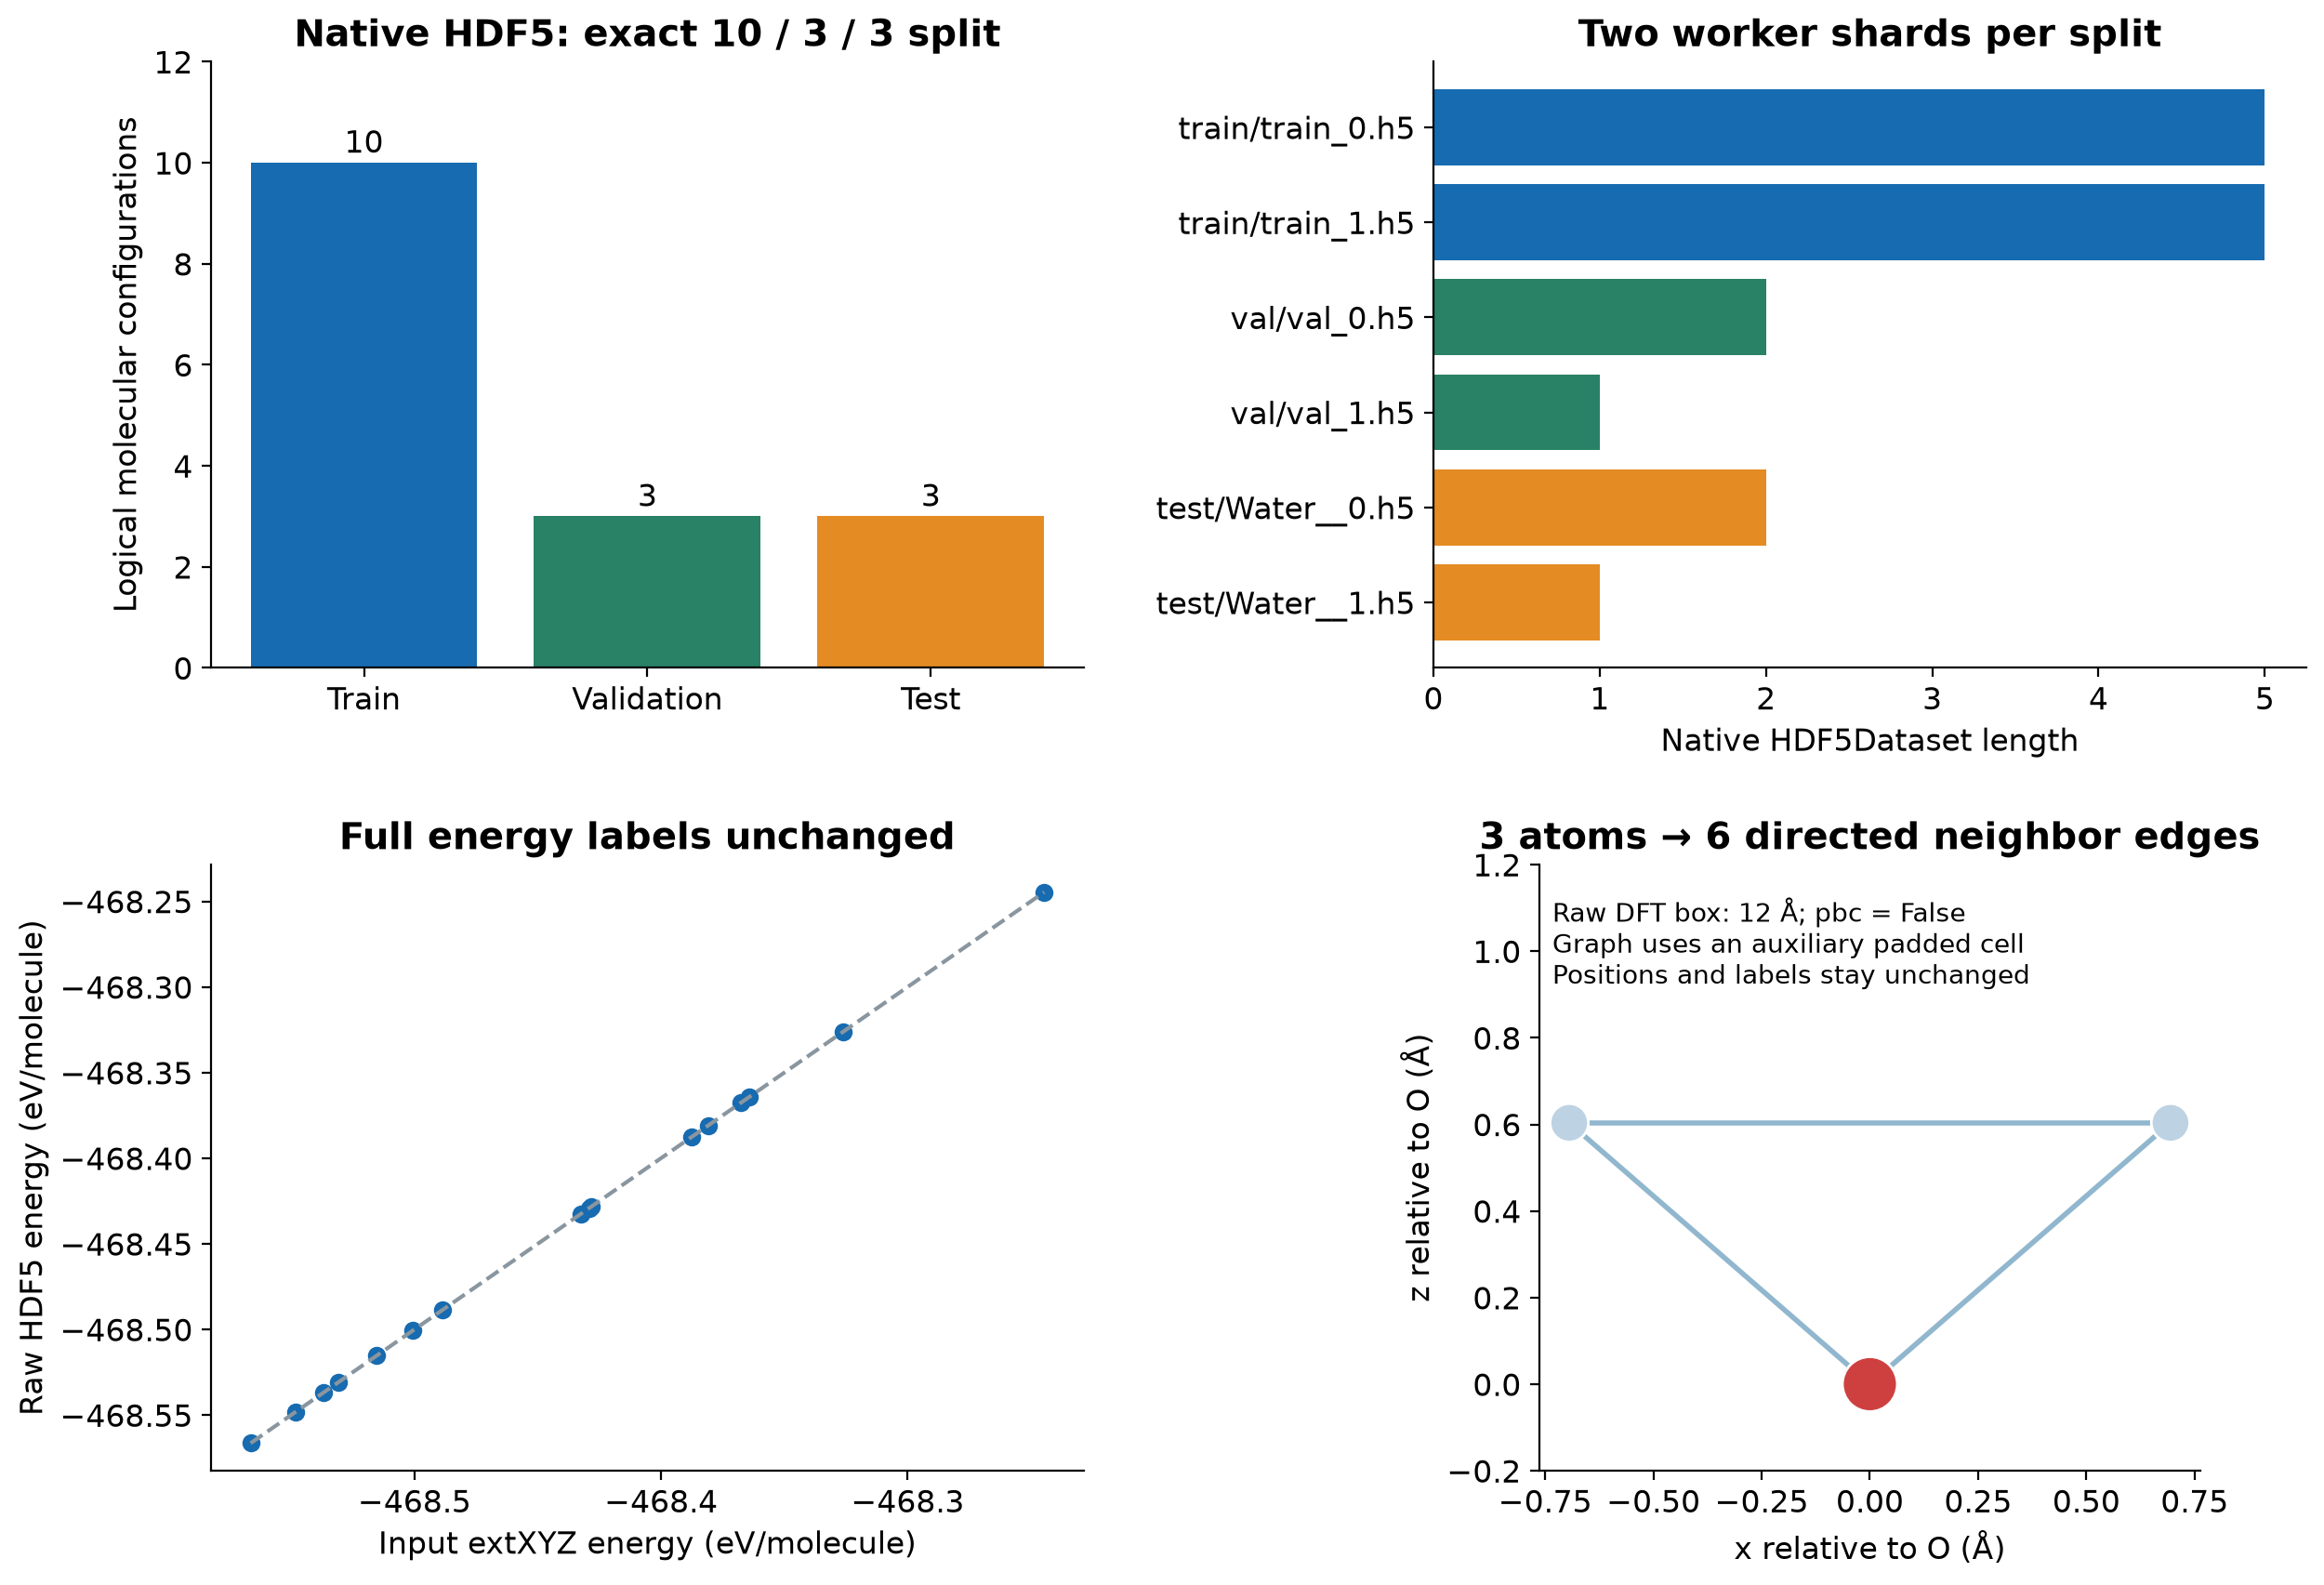
数据量增大时,可以用mace_prepare_data将extXYZ转换为分片HDF5,训练时再按需读取。它是数据格式与加载工具,不会给没有标签的结构自动计算DFT能量或力。本例使用前面分子属性教程的真实H₂O数据,拆分保持10训练、3验证、3测试。
1 下载后先看数据#
下载完整数据、三个自有Si模型、原生工具示例及高清绘图包。在已分配的计算资源内执行计算和推断,登录节点用于编辑和提交。MACE是Python包,本例使用Python3.11、MACE0.3.16、PyTorch2.8.0+cu126、ASE3.29及默认e3nn计算路径;这些工具示例实际采用CPU。
python3 -m zipfile -e mace-tools-practical-wave316-*.zip .
cd mace-tools-practical
bash run.sh
bash run.sh根据保存的完整数值生成三张图,不训练模型、不计算DFT,也不重新跑动力学。想独立读取HDF5、核对筛选标签,并用三个固定模型重新计算21帧结构上的能量和力,可执行:
bash run.sh verify
cat results/checks/VALIDATION.json
2 用一个短命令完成新的转换#
bash tools.sh prepare
输出放在results/new-hdf5/,与附件中已有的hdf5/参考数据分开;同名新结果已存在时,脚本拒绝覆盖。原生命令如下,所有标签键都明确写出:
module purge
module load mace/0.3.16
mkdir -p results/work
mace_prepare_data \
  --train_file inputs/water/train.xyz \
  --valid_file inputs/water/valid.xyz \
  --test_file inputs/water/test.xyz \
  --num_process 2 --work_dir results/work \
  --h5_prefix results/new-hdf5/ --r_max 4 \
  --energy_key REF_energy --forces_key REF_forces \
  --dipole_key REF_dipole --polarizability_key REF_polarizability \
  --charges_key REF_charges --shuffle False
小数据使用两个处理进程即可;不要直接沿用较大的默认进程数。--shuffle False便于追踪原始构型顺序,训练/验证/测试仍由三个输入文件区分。转换时读取测试文件,不代表它参与训练或参与训练统计。
本例未开启--compute_statistics。需要该可选功能时,应另行计算并检查参考原子能、邻居数与尺度参数;不要把一个固定组成H₂O数据的拟合基线当成唯一的孤立H、O原子能。
3 查看生成了哪些分片#
python - <<'PYCODE'
from pathlib import Path
import h5py
for p in sorted(Path('results/new-hdf5').rglob('*.h5')):
    with h5py.File(p, 'r') as f:
        n = sum(len(batch) for batch in f.values())
        print(p, n, dict(f.attrs))
PYCODE
本例输出:
| 数据集 | 两个分片的构型数 | 总数 |
|---|---|---|
| train | 5、5 | 10 |
| val | 2、1 | 3 |
| test | 2、1 | 3 |
验证/测试分片的原生drop_last属性可能为true,但HDF5Dataset本身仍可完整读取这3个构型。训练时还要单独检查DataLoader的batch大小和丢弃末batch设置,不能只从这个标记推断实际样本数。
4 用原生数据集接口读取完整标签#
python - <<'PYCODE'
import torch
from mace.data import HDF5Dataset
from mace.tools import AtomicNumberTable
torch.set_default_dtype(torch.float64)
d = HDF5Dataset('hdf5/train/train_0.h5', r_max=4,
                z_table=AtomicNumberTable([1, 8]))
x = d[0]
print('frames:', len(d))
print('positions:', x.positions)
print('energy:', x.energy)
print('forces:', x.forces)
print('dipole:', x.dipole)
print('polarizability:', x.polarizability)
print('neighbor edges:', x.edge_index)
PYCODE
本例单位与extXYZ一致:能量eV/分子、力eV/Å、偶极e·Å、极化率ų。MACE不会自动把Debye转换成e·Å。完整3×3张量和每个原子的三分量力均已保留,不能只读一个标量就认为所有属性都齐全。
5 为什么原生图数据的cell与DFT盒子不同#
H₂O原始DFT盒子是12 Å、pbc=False。HDF5保存的原始cell仍是12 Å;原生AtomicData构造邻居图时,会在非周期方向建立辅助大胞,其当前公式为:
auxiliary_length = (max(abs(all_positions)) + 1) * 5 * r_max
例如本例第一个构型会得到约153.8867 Å的图辅助胞。这个数用于非周期邻居查找,不代表DFT计算盒已变大,也不改变原子位置或属性标签。可以直接检查原始HDF5中的物理晶胞:
python - <<'PYCODE'
import h5py
with h5py.File('hdf5/train/train_0.h5', 'r') as f:
    g = f['config_batch_0']['config_0']
    print(g['cell'][()])
    print(g['positions'][()])
    print(list(g['properties']))
PYCODE
还应单独保留构型编号、数据拆分和来源表;任意extXYZ自定义元数据不一定都进入原生HDF5。附件保留原始三个输入文件,便于按完整坐标及标签追踪来源。