
MDAnalysis蛋白二级结构与二面角
用真实泛素轨迹操作DSSP、Ramachandran和Janin,处理末端原子命名并读懂三类二级结构。
阅读本篇目录
蛋白轨迹除了RMSD,还可以逐残基查看二级结构、主链角和侧链角。本文先把轨迹和拓扑读对,再用三个原生工具生成可以直接检查的数组和图片。
1 下载并运行真实示例#
下载泛素蛋白八类分析输入、轨迹、结果与绘图包,保存为 mdanalysis-protein-wave326-v3.zip:
module load pymatgen/2026.9.24
python -m zipfile -e mdanalysis-protein-wave326-v3.zip .
cd mdanalysis-protein
bash run.sh
source env.sh
run.sh在新目录中完成八类分析并生成results/和plots/,已有同名输出时先换一个解压目录。环境使用集群已安装的Python 3.11 / MDAnalysis 2.9.0;env.sh选择相应Python并限制数值库为单线程,没有调用qvasp或VASP。其他机器可把ANALYSIS_PYTHON设为含相同依赖的Python路径用于run.sh。
本包使用鸢算科技集群已完成的GROMACS泛素轨迹:1231个原子、76个残基、1237条键。原始轨迹有1001帧,间隔0.1 ps;本例每20帧取一帧,得到0、2、…、100 ps共51帧。这里重用真实轨迹进行分析,没有重新做分子动力学;100 ps的变化不能说明蛋白折叠、长时稳定性或构象自由能已经收敛。
2 先处理拓扑和周期性边界#
本例GROMACS 2026.4生成的TPR格式为138,MDAnalysis 2.9.0不能直接读取。包中已提供由原生GROMACS导出的protein-conect.pdb及质量、电荷、元素元数据,不靠PDB猜测来代替拓扑。需要重做导出时:
bash export-topology.sh
source env.sh
python - <<'PYCODE'
from load import load
u = load()
print(len(u.atoms), len(u.residues), len(u.bonds))
print(len(u.trajectory), u.trajectory.dt)
print(len(u.atoms.fragments), u.atoms.charges.sum())
PYCODE
前两行分别得到1231 76 1237及1001 0.1;只有一个连通蛋白片段,总电荷约为数值零。export-topology.sh实际使用:
module load gromacs/2026.4-p100-threadmpi
# export-topology.sh已建立topology-export目录
gmx editconf -f inputs/protein.tpr -o topology-export/protein-conect.pdb -conect
gmx dump -s inputs/protein.tpr > topology-export/native-topology.dump
python topology_metadata.py
重新导出的文件在topology-export/,不会覆盖已有inputs/。topology_metadata.py从原生TPR转储提取质量、电荷和原子序号;本例脚本限定为这个单蛋白拓扑,不要直接当成任意多分子溶剂体系的通用转换器。load()随后加载PDB和XTC、补齐明确元数据,并用键连接执行unwrap让蛋白完整。自己的轨迹必须先确认原子顺序、残基命名、键和盒信息匹配;配体、断链或多链体系要相应修改选择。
3 DSSP:逐残基二级结构#
python - <<'PYCODE'
import numpy as np
from load import load
from MDAnalysis.analysis.dssp import DSSP
u = load()
a = DSSP(u, heavyatom_names=('N','CA','C','O OC1'))
a.run(start=0, stop=1001, step=20)
x = a.results.dssp_ndarray
print(x.shape)
print('Loop / Helix / Sheet:', x.mean(axis=(0, 1)))
np.save('my-dssp.npy', x)
PYCODE
输出形状(51,76,3),分别是帧、残基、三类标签。这个蛋白的末端氧叫OC1,所以氧选择同时接受O OC1;直接沿用仅O的默认值会漏掉末端。自己的末端名称可能不同,先查看PDB再改选择,不要为了运行成功而删掉整个末端残基。
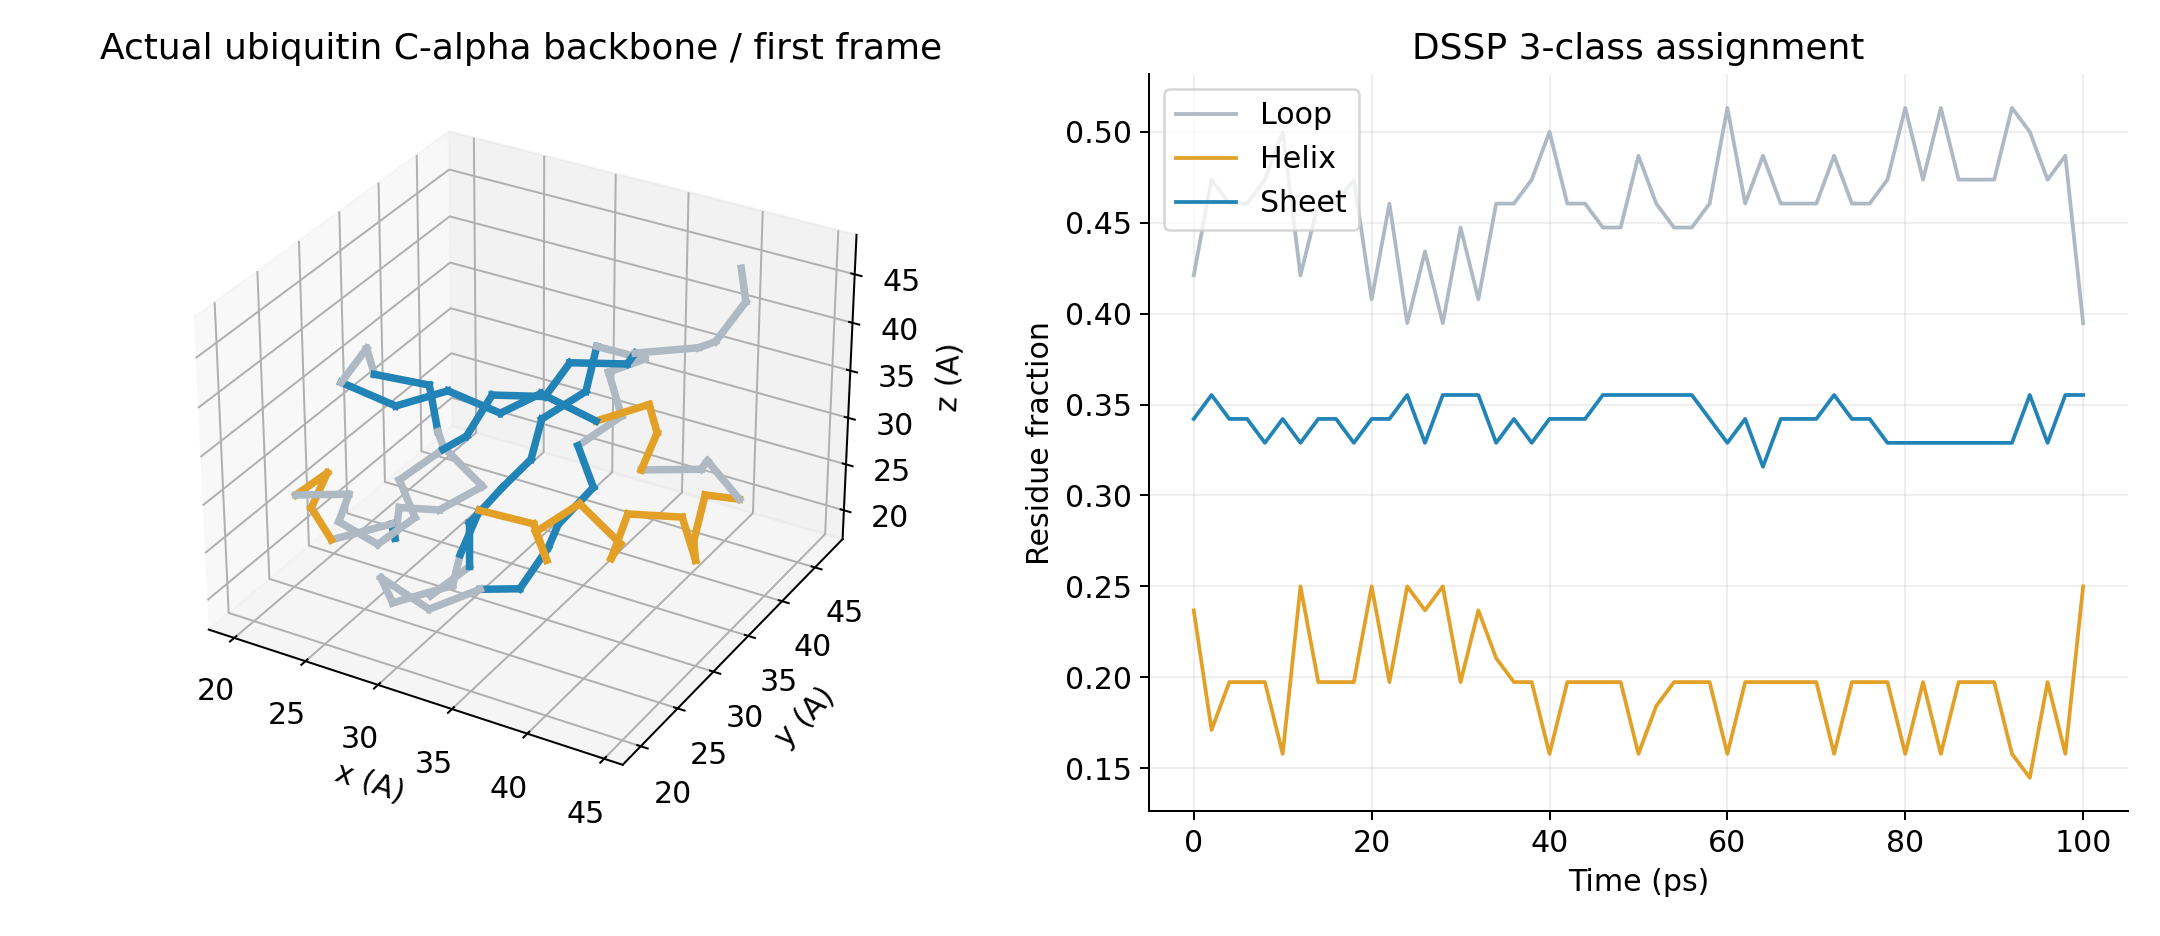
51帧平均:Loop 46.2332%、Helix 19.6336%、Sheet 34.1331%。它们是这个短轨迹里残基标签的比例;这个实现输出三类,不分别区分α、3₁₀、π螺旋等子类。MDAnalysis DSSP手册说明了分类范围。
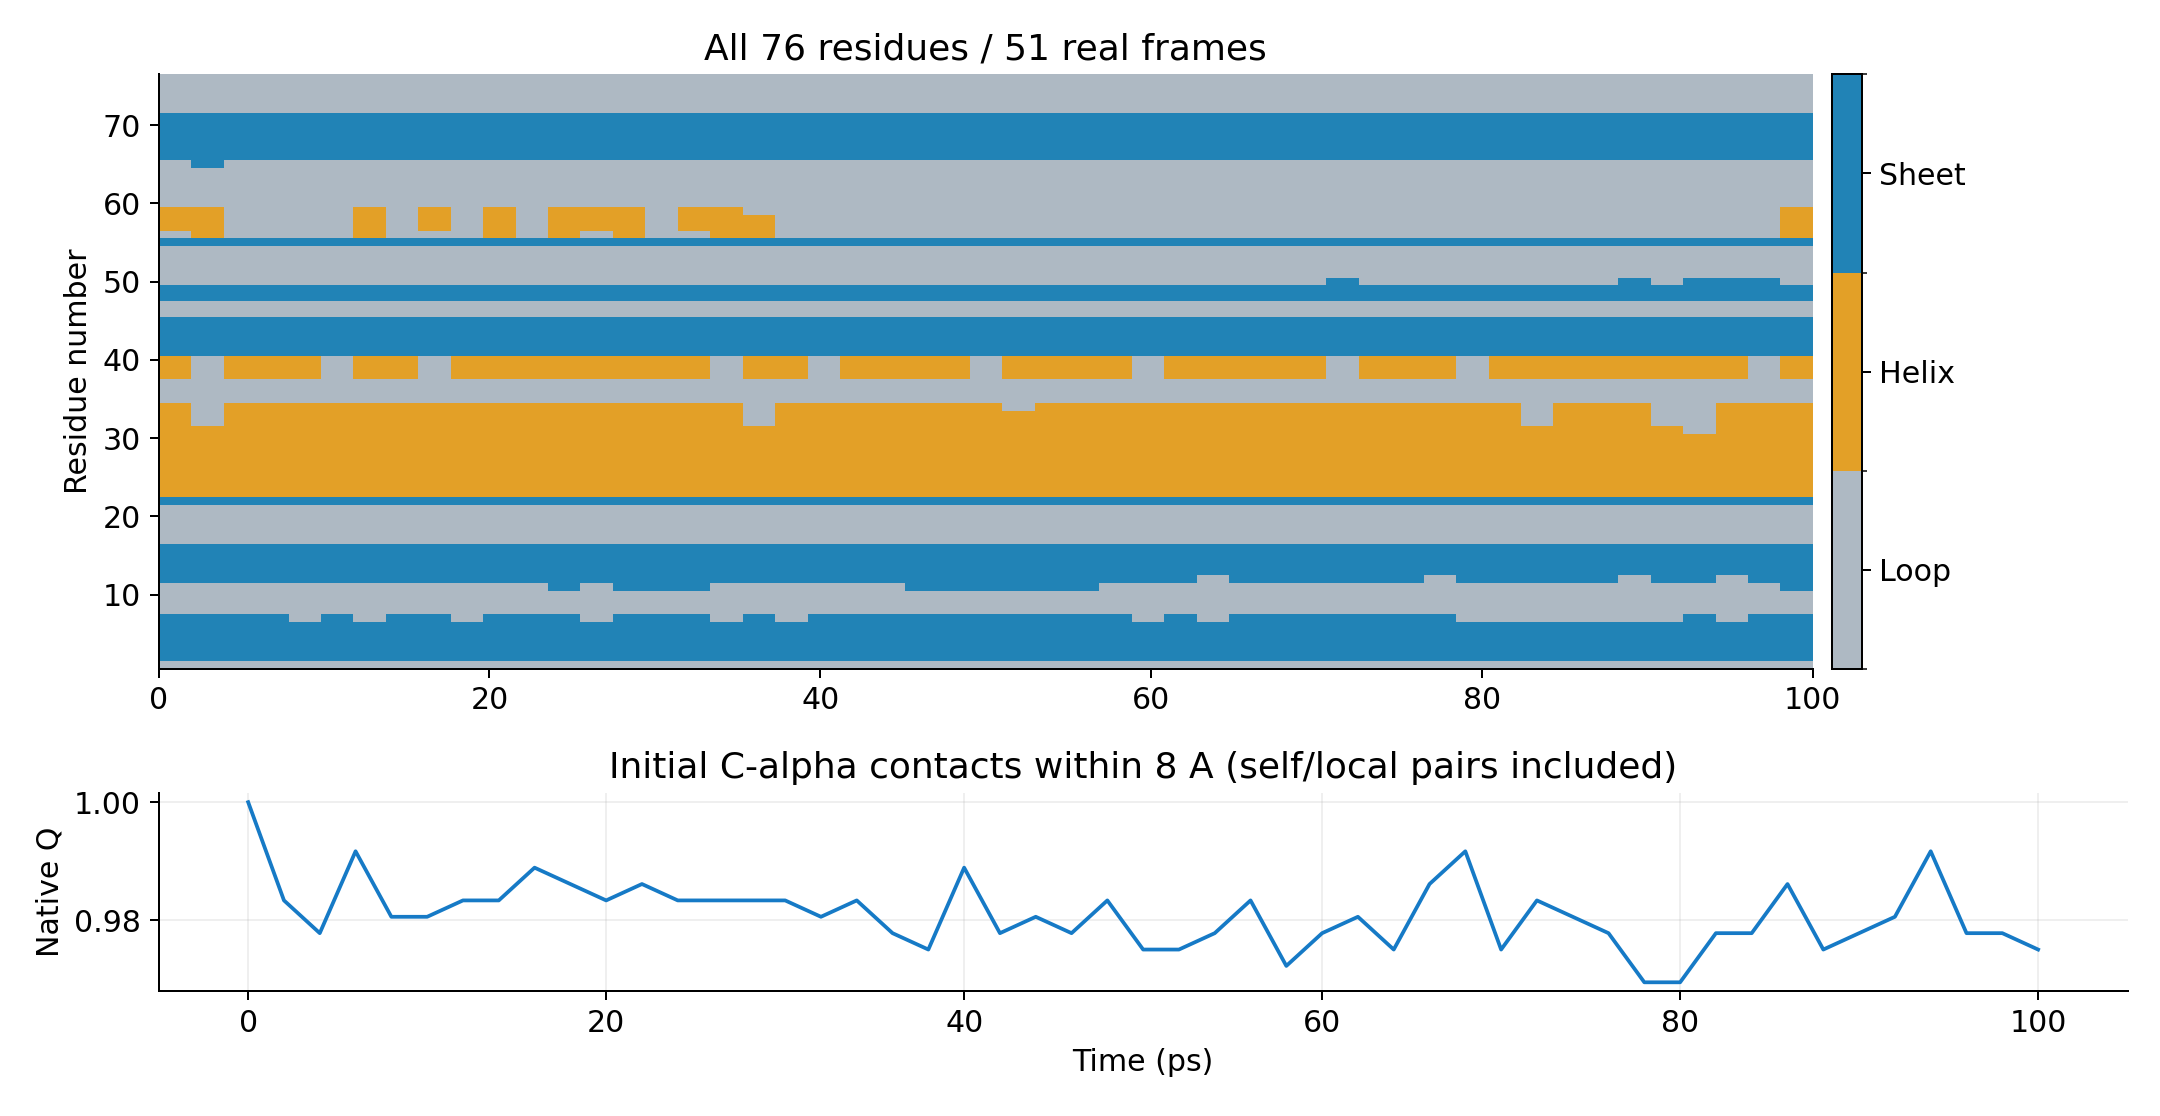
横向看同一残基是否保持标签,纵向看同一帧哪些区域为螺旋或折叠。短时间的标签变化可能来自局部几何涨落,不等于发生了完整折叠或解折叠。
4 Ramachandran:主链φ/ψ#
python - <<'PYCODE'
import numpy as np
from load import load
from MDAnalysis.analysis.dihedrals import Ramachandran
u = load()
a = Ramachandran(u.select_atoms('protein')).run(stop=1001, step=20)
print(a.results.angles.shape)
np.save('my-ramachandran-degrees.npy', a.results.angles)
PYCODE
本例形状为(51,74,2);末端缺少构成二面角的相邻残基,不能为所有76个残基都得到完整φ/ψ。最后一维是φ和ψ,单位为度,跨过−180°/180°时要用圆周角差比较。
5 Janin:侧链χ₁/χ₂#
python - <<'PYCODE'
import numpy as np
from load import load
from MDAnalysis.analysis.dihedrals import Janin
u = load()
a = Janin(u.select_atoms('protein')).run(stop=1001, step=20)
print(a.results.angles.shape)
np.save('my-janin-degrees.npy', a.results.angles)
PYCODE
得到(51,51,2),不是76个残基。原生默认规则排除ALA、CYS、GLY、PRO、SER、THR、VAL等不适合此两角定义的残基;自己的非标准残基也要先确认原子命名及选择。不要把缺少χ₂的残基补零后作为真实数据。
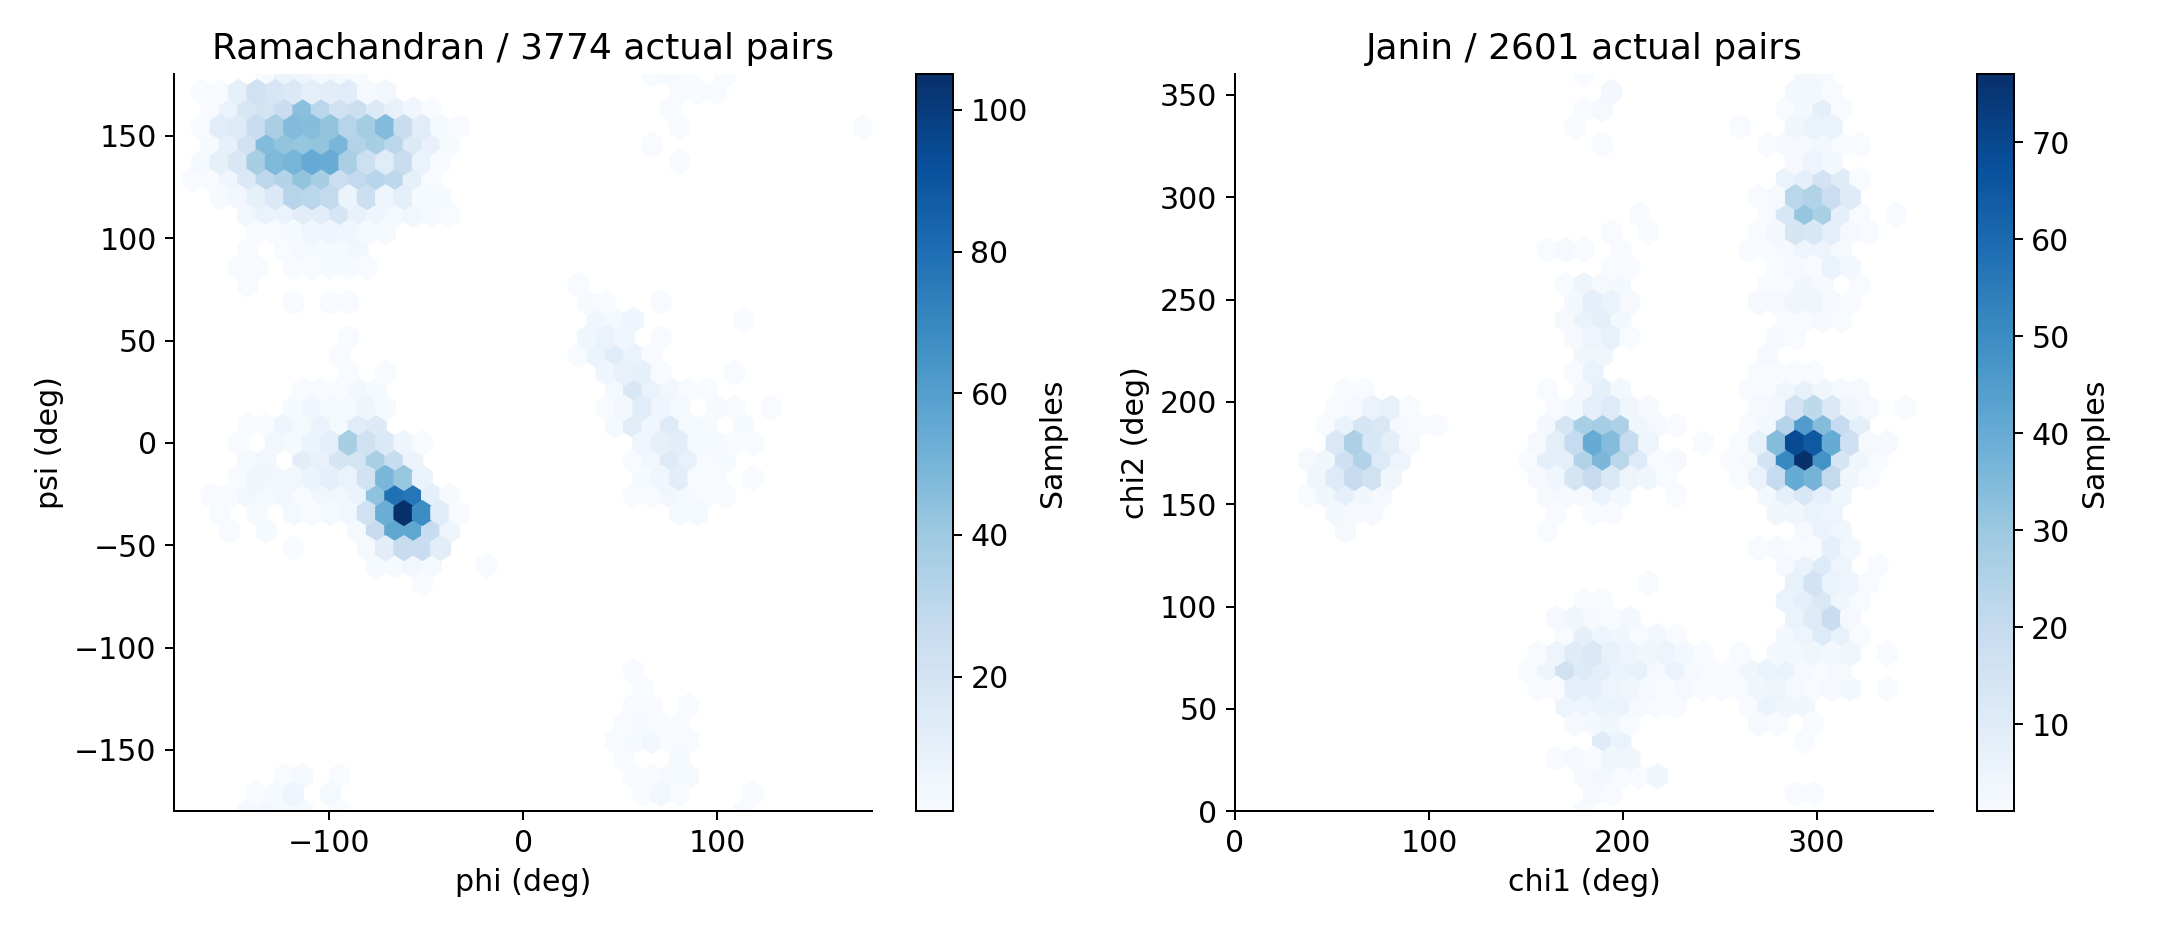
results/FULL-FIELDS.npz保存完整角度和相应原子分组,plots/protein-dihedrals.png是实际数据分布。下面两篇继续讲接触、GNM与PCA及BAT与螺旋几何。