
MDAnalysis协方差与HES重采样
用真实蛋白质轨迹演示收缩协方差和HES bootstrap,导出完整矩阵并解释统计波动的适用范围。
阅读本篇目录
比较两段蛋白质轨迹时,HES用坐标分布的均值与协方差描述差异。本篇先用3个Cα、9维坐标说明协方差,再运行原生bootstrap。较小的原子选择便于理解矩阵;得到的数字只描述这3个原子,不能直接代表整条蛋白质。
1 运行与结果位置#
下载SPE、协方差与重采样示例,保存为spe-covariance.zip:
python3 -m zipfile -e spe-covariance.zip .
cd mdanalysis-spe-covariance
bash setup.sh
bash run.sh
bash verify.sh
bash plot.sh
本例为MDAnalysis 2.9.0、NumPy 1.26.4、SciPy 1.13.1,使用已有泛素轨迹的51帧Cα坐标。前26帧和后26帧各作为一组,两组共享中间那一帧,不是两条独立模拟。所有结构已对齐同一参考,因此HES调用中显式使用align=False。
输出为results/FULL-FIELDS.npz和results/VALIDATION.json。如果已运行过随机邻近嵌入的同一个包,直接读取已有结果即可。
2 收缩协方差怎么用#
少量帧配合过多坐标,协方差矩阵可能奇异或数值不稳定。本例把每帧前三个Cα展平为9维,分别计算显式收缩系数0.25与原生自动系数的结果:
fixed = shrinkage_covariance_estimator(
    coordinates_26_by_9, shrinkage_parameter=0.25
)
automatic = shrinkage_covariance_estimator(coordinates_26_by_9)
这是原生收缩估计器,不等同于简单地给对角线加一个常数。配套代码独立重建该版本的样本矩阵、单因子先验及其组合,并核对全部9×9元素;当前版本还包含其自身的样本缩放约定。因此不要拿另一软件的默认np.cov结果直接判断这里计算错误。
source env.sh
"$YS_PY" - <<'PYCODE'
import numpy as np
f = np.load('results/FULL-FIELDS.npz')
for i in range(2):
    fixed = f[f'covariance_{i}_explicit']
    auto = f[f'covariance_{i}_auto']
    np.savetxt(f'covariance-window-{i+1}.dat', fixed)
    print('window', i+1, 'shape', fixed.shape,
          'fixed condition', np.linalg.cond(fixed),
          'auto condition', np.linalg.cond(auto),
          'minimum auto eigenvalue', np.linalg.eigvalsh(auto).min())
PYCODE
实际结果如下;条件数无量纲,协方差和本表特征值的单位为Ų。
| 26帧窗口 | 系数0.25的条件数 | 自动系数的条件数 | 自动矩阵最小特征值 |
|---|---|---|---|
| 前半段 | 16.1423 | 20.5126 | 0.005211 |
| 后半段 | 24.5199 | 16.6615 | 0.007569 |
这些数字用于检查当前小例子的数值行为,不表示选择了最优的物理模型或已经收敛。收缩可以改善矩阵估计,不能补回轨迹中没有采到的构象。
3 原生HES bootstrap#
mean, spread = hes(
    [first_26_frames, last_26_frames],
    select='index 0 1 2', cov_estimator='shrinkage',
    weights=None, align=False,
    estimate_error=True, bootstrapping_samples=4
)
脚本在这一操作前设置np.random.seed(338),从每段原有26帧中有放回抽样,再计算四组HES。这里的随机数可以固定;同包中的底层SPE随机数规则不同,不能混为一谈。weights=None表示等权,不使用原子质量加权。
source env.sh
"$YS_PY" - <<'PYCODE'
import numpy as np
f = np.load('results/FULL-FIELDS.npz')
values = f['HES_bootstrap_all4_matrices'][:, 0, 1]
np.savetxt('hes-bootstrap.dat',
           np.column_stack([np.arange(1, len(values)+1), values]),
           header='resample HES')
print('four values:', values)
print('mean:', values.mean(), 'STD(ddof=0):', values.std())
print('native mean matrix:', f['HES_bootstrap_mean'])
print('native STD matrix:', f['HES_bootstrap_stddev'])
PYCODE
本次四次重采样的HES平均为4.47545,标准差为1.00993。HES没有固定的0~1范围,不要套用CES或DRES的数值尺度。图中的阴影是这四次重采样的均值±标准差,不是置信区间、标准误,也不是新的独立轨迹之间的统计误差。
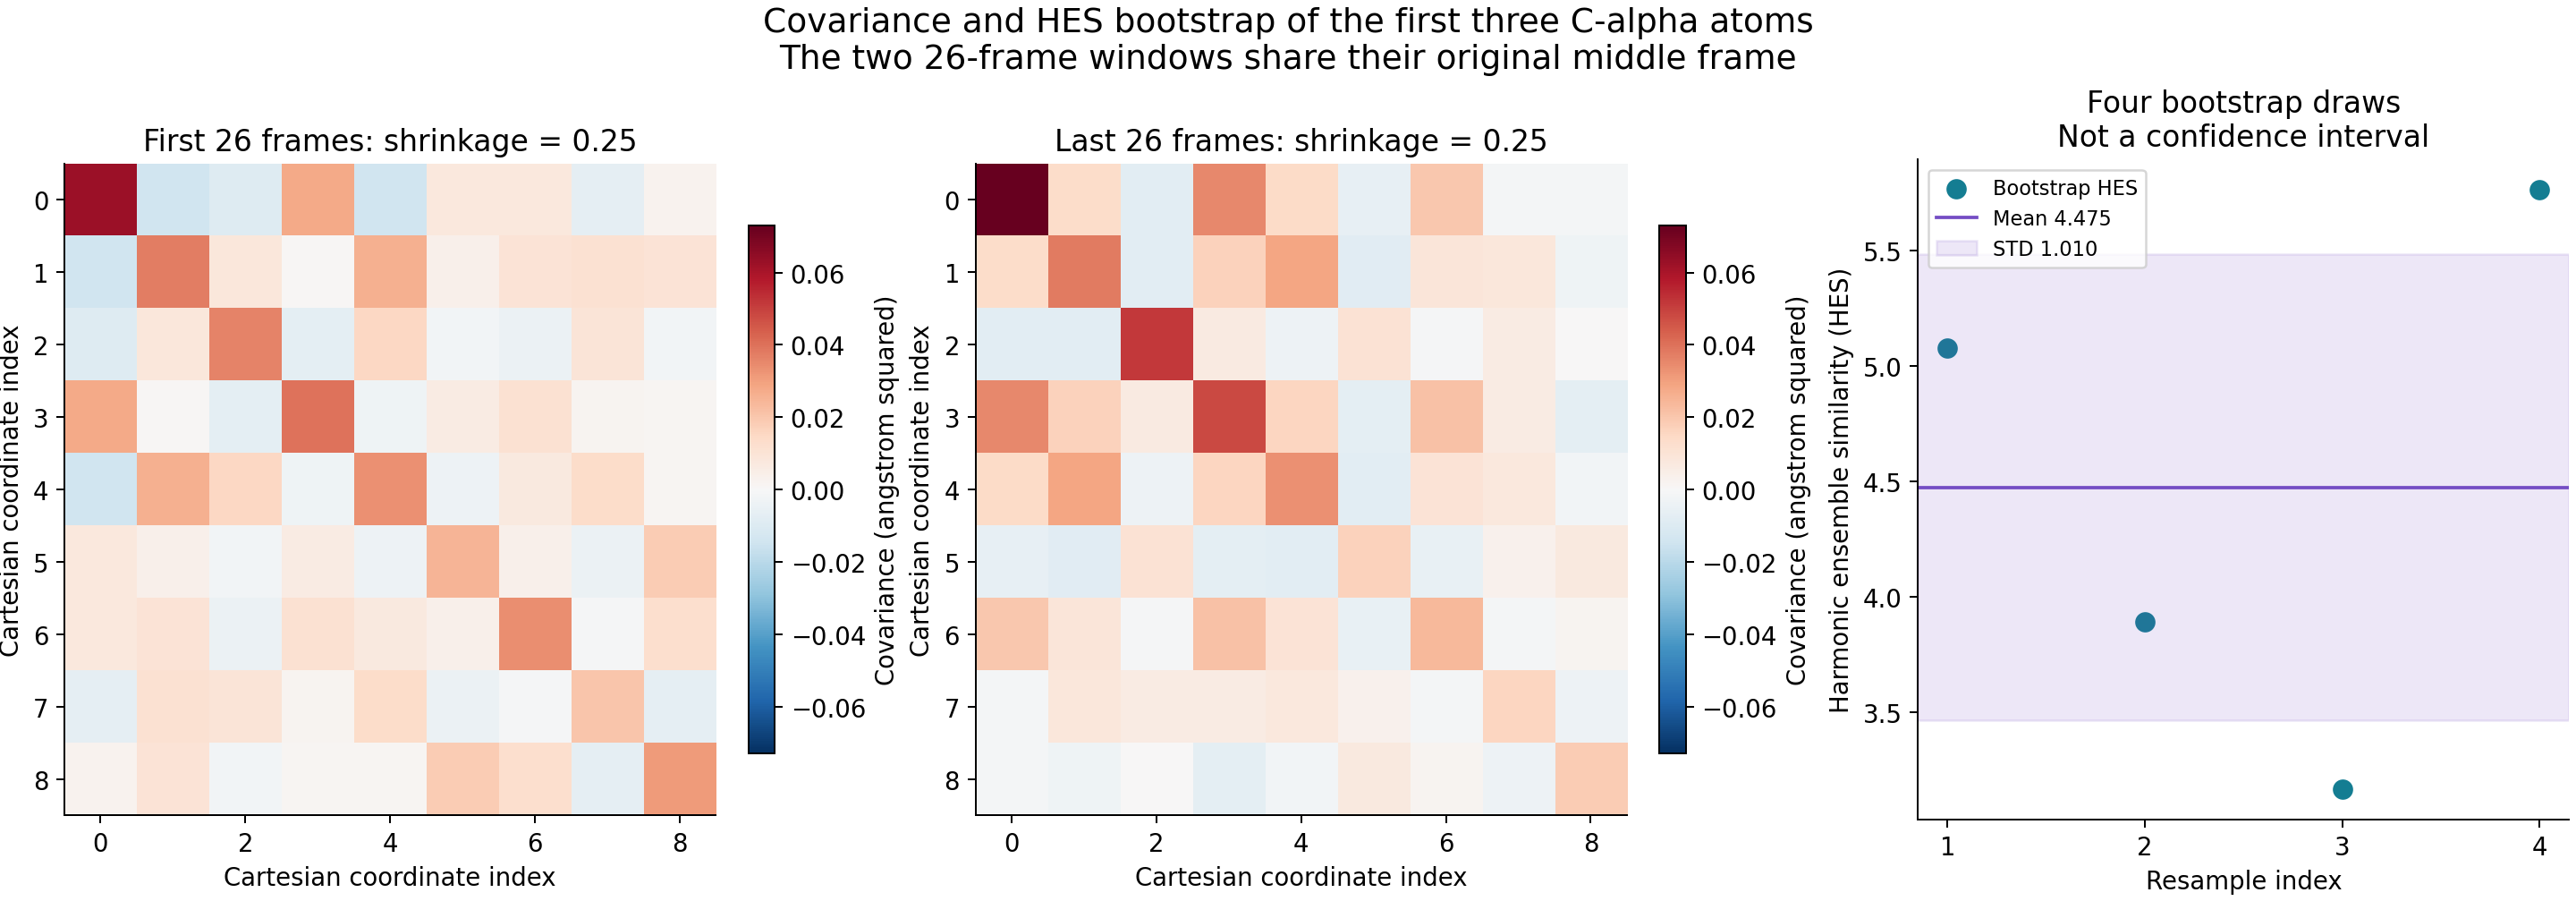
原轨迹的相邻帧存在时间相关;本例逐帧有放回抽样,仅演示接口和数据导出。用于正式研究时,应根据相关时间选择块长度,增加独立轨迹和采样,并检查结果对窗口、原子选择与估计器的敏感性。不能仅把bootstrapping_samples调大就宣称轨迹收敛。
4 改成自己的数据时#
先保证两段轨迹的原子身份、顺序和对齐规则相同;再根据问题选原子,并检查样本数相对坐标维度是否足够。包内analyze.py的uni()负责加载坐标,cov()和bootstrap()集中给出了本篇的输入、原生调用和独立核对公式,可从这三处替换数据。
接口依据MDAnalysis 2.9协方差与ENCORE相似性说明。目前教程对应2.9接口;后续升级mdaencore时应重新核对参数和随机数行为。