
dpdata结构格式转换实操
实际转换Si结构到POSCAR、LAMMPS、GRO、STRU、PWmat、XYZ和pymatgen,说明标签、周期性与文本精度。
阅读本篇目录
本篇从实际Si计算数据取出第一帧,转换为常见结构格式。该帧有2个Si,原始晶胞体积约40.89273 ų。目标是把结构正确交给下一个工具;转换后的结构文件不自动带有原有能量、力或virial标签。
1 下载与运行#
下载格式转换实操包,保存为dpdata-formats.zip:
python3 -m zipfile -e dpdata-formats.zip .
cd dpdata-format-workflows
bash setup.sh
bash run.sh
bash verify.sh
bash plot.sh
本例使用Python 3.11.16、dpdata 1.1.0及已有ASE、pymatgen依赖,CPU单线程即可。results/含实际生成的结构和标签存储文件。标签数据的选择和往返误差见标签存储与格式精度。
2 在终端转换自己的结构文件#
source env.sh
"$YS_PY" - <<'PYCODE'
from pathlib import Path
import dpdata
from ase.io import write
s = dpdata.LabeledSystem('inputs/si-nine', fmt='deepmd/npy')
frame = s.sub_system(0)
out = Path('my-structures')
out.mkdir()
frame.to('vasp/poscar', str(out / 'POSCAR'))
frame.to('lammps/lmp', str(out / 'si.lmp'))
frame.to('lammps/dump', str(out / 'si.dump'))
frame.to('xyz', str(out / 'si.xyz'))
frame.to('abacus/stru', str(out / 'STRU'), pp_file=['Si.upf'])
frame.to('pwmat/atom.config', str(out / 'atom.config'))
# ASE从原始完整晶胞写GRO,再由dpdata读取
atom = frame.to('ase/structure')[0]
write(out / 'si.gro', atom, format='gromacs')
# pymatgen结构对象不需要先写入文件
structure = frame.to('pymatgen/structure')[0]
back = dpdata.System(structure, fmt='pymatgen/structure')
print('pymatgen atoms=', back.get_natoms())
print('original labels:', sorted(frame.data.keys()))
PYCODE
ls my-structures
sub_system(0)使用从0开始的第一帧,避免把9帧数据误认为一个单结构。上面的Si.upf仅指定STRU中的文件名;用于ABACUS新计算时,应换成实际采用的赝势,并另行配置INPUT和KPT。
| 输出 | 实际保留内容 | 后续使用要点 |
|---|---|---|
| POSCAR | 元素、原子位置、晶胞 | 适合继续准备VASP输入 |
| LAMMPS data/dump | 原子类型、位置、晶胞 | 读回时给出真实type_map |
| GRO | 位置、盒;具有文本精度限制 | 本例用ASE写出以保留更多盒参数位数 |
| ABACUS STRU | 元素、位置、晶胞等结构字段 | 赝势文件名和新计算设置要另配 |
| PWmat atom.config | 元素、位置、晶胞 | 不含原有DFT能量与力标签 |
| 普通XYZ | 元素与笛卡尔位置 | 本例不保留周期晶胞与标签 |
| pymatgen Structure | 周期结构对象 | 对象转换不自动带入原标签 |
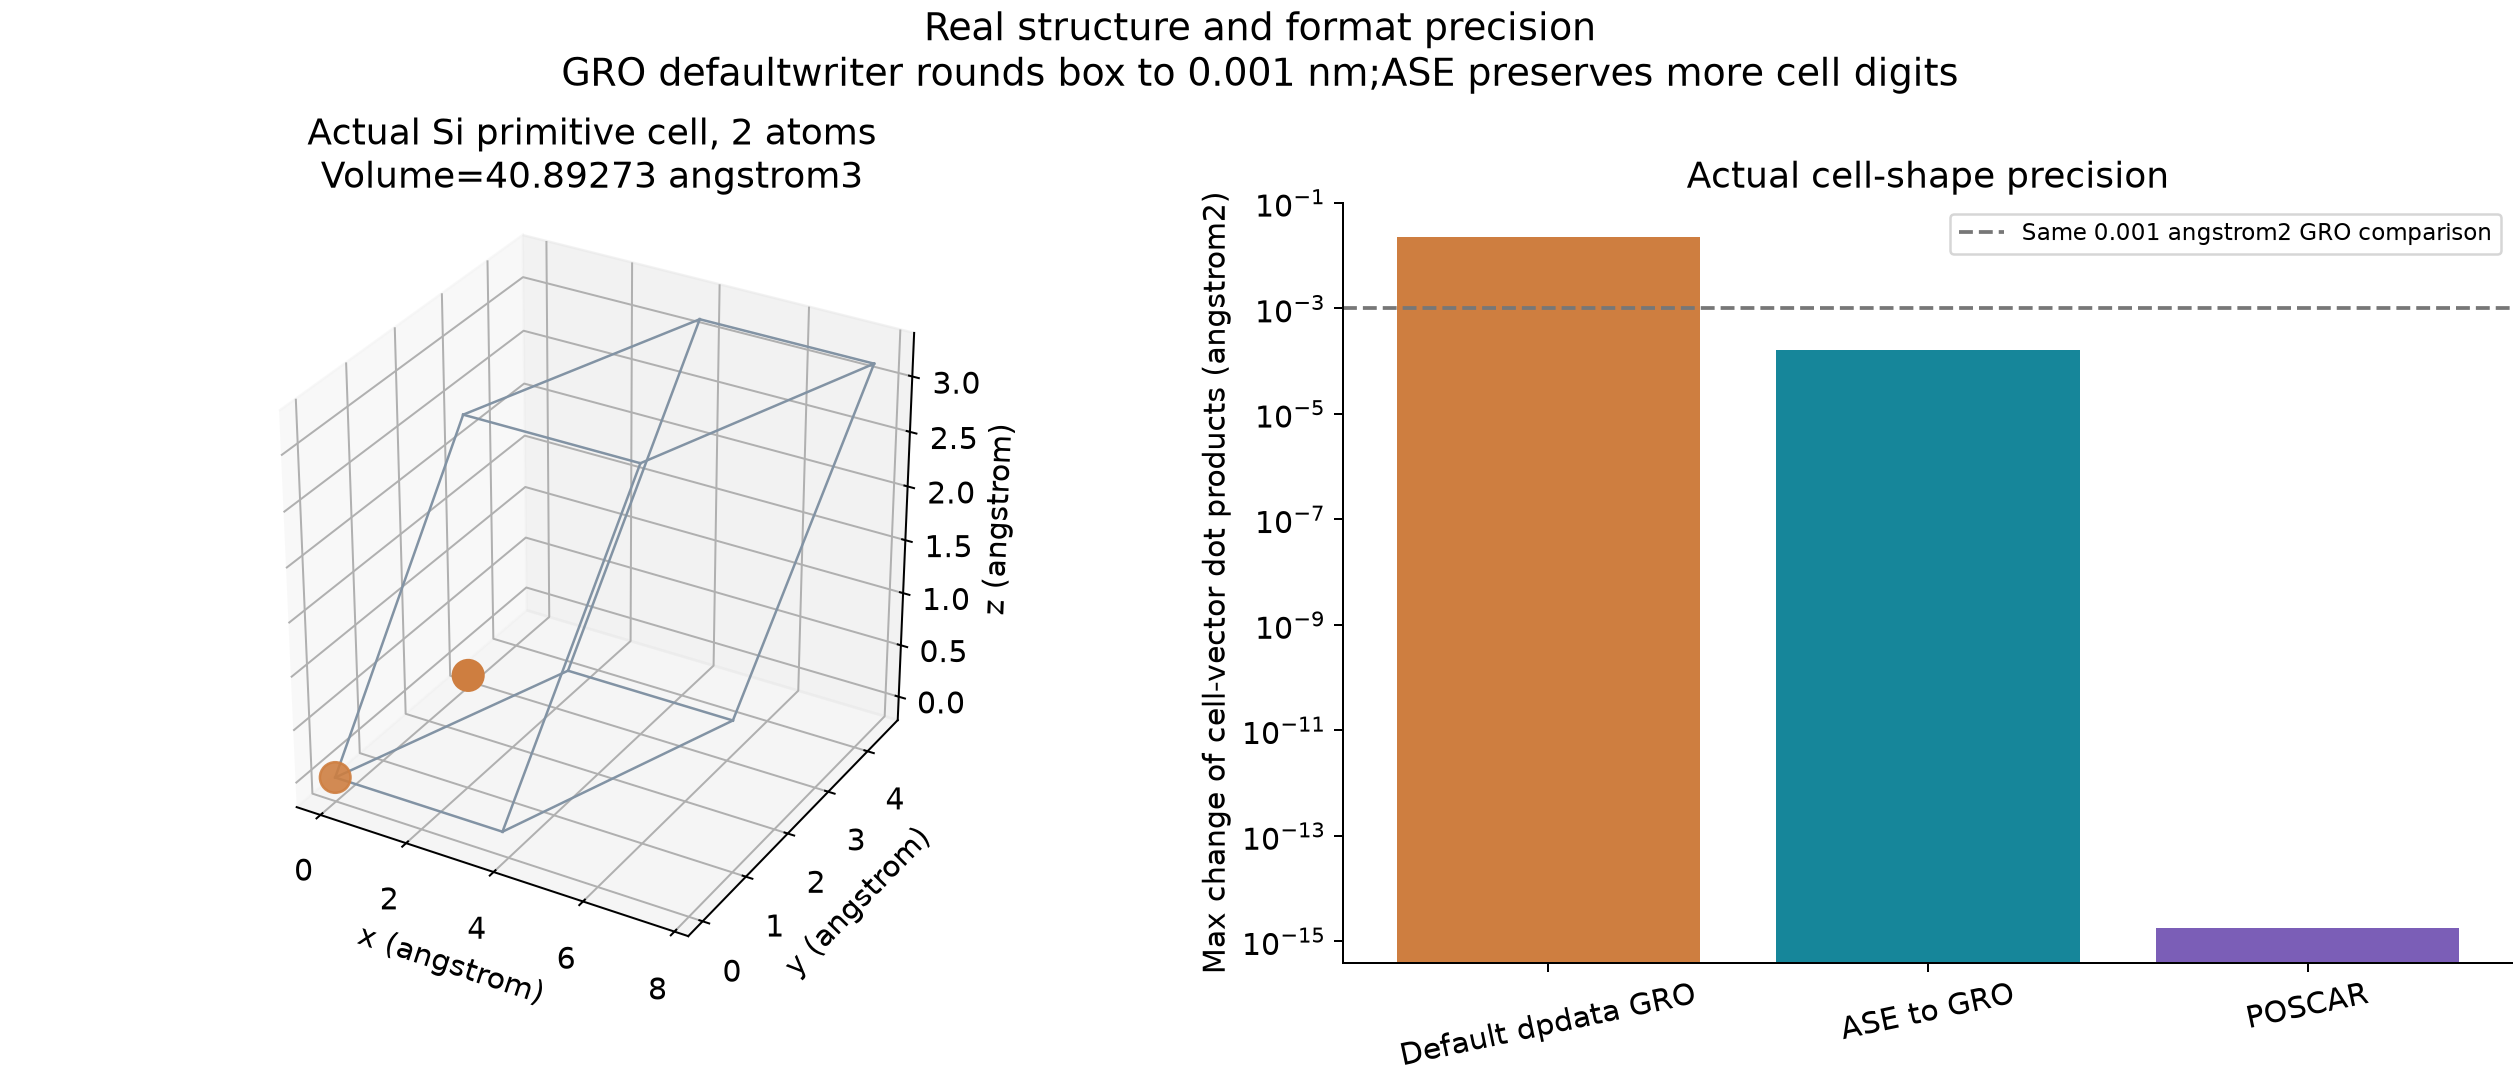
左图来自原始晶胞和真实原子坐标。右图比较晶胞向量内积矩阵的变化,单位Ų,用来观察盒形状精度;它不是原子位移,不能把该数值直接当作Å。
3 为什么GRO需要注意精度#
本环境的dpdata默认GRO写入器将盒参数保留为三位nm。这组Si小晶胞的内积矩阵最大变化约0.0223247 Ų;采用ASE从原始晶胞写GRO后,降为约0.0001656 Ų。
但GRO原子坐标仍有文本舍入:本例周期等价坐标最大分量变化约0.003676 Å,最短镜像原子间距变化约0.003254 Å。因此,使用GRO是为了与GROMACS结构格式衔接;需要高精度保存晶胞和标签时,可选择POSCAR、HDF5或NumPy等合适格式。不要先写成低精度GRO,再期待转换器恢复已丢失的小数位。
4 读回来,检查类型、帧数和标签#
source env.sh
"$YS_PY" - <<'PYCODE'
import dpdata
files = [('vasp/poscar', 'my-structures/POSCAR', {}),
         ('lammps/lmp', 'my-structures/si.lmp', {'type_map': ['Si']}),
         ('lammps/dump', 'my-structures/si.dump', {'type_map': ['Si']}),
         ('gromacs/gro', 'my-structures/si.gro', {}),
         ('xyz', 'my-structures/si.xyz', {}),
         ('abacus/stru', 'my-structures/STRU', {}),
         ('pwmat/atom.config', 'my-structures/atom.config', {})]
for fmt, path, options in files:
    t = dpdata.System(path, fmt=fmt, **options)
    print(fmt, 'frames=', len(t), 'atoms=', t.get_natoms(),
          'elements=', t['atom_names'],
          'nopbc=', t.data.get('nopbc', False))
    print('energy present=', 'energies' in t.data)
PYCODE
bash plot.sh --reference
回读得到每文件1帧、2个Si,结构交换文件没有补造能量、力和virial。普通XYZ在本例按非周期结构读取;若以后把它转成周期晶体输入,必须补回真实晶胞,不能把缺省盒当作原晶胞。
程序除了核对元素、原子数和帧数,还比较晶胞形状、周期等价位置与最短镜像距离,允许合法的周期平移。对更复杂的晶胞或多元素数据,还应核对原子类型顺序;LAMMPS的数字类型不能靠猜测对应元素。
更多格式、只读与只写接口见dpdata格式文档。本篇操作以安装的1.1.0和随包完整脚本为准;对应软件重新计算出的标签,需按新的方法和单位重新检查,不能把旧标签自动附到新计算上。