
DP-GEN模型偏差与独立测试误差
逐帧检查四模型力偏差、分辨委员会分歧和DFT真实误差,给出两组分的留出集误差和后续补标流程。
阅读本篇目录
model_devi.out回答“四个模型对同一结构是否一致”;它不能单独回答“预测是否正确”。这篇用同一组真实水/过氧化氢实例同时看委员会分歧和未参与训练的DFT标签。
下载本组三篇共用的输入、真实标注、参考轨迹和运行绘图包。先完成数据篇的共同运行。下面只读取已有模型、轨迹并画图,不重复训练和MD。
1. 读取原生偏差文件#
head -n 6 iter.000000/01.model_devi/task.000.000000/model_devi.out
各列依次是 step,max_devi_v,min_devi_v,avg_devi_v,max_devi_f,min_devi_f,avg_devi_f。力偏差单位eV/Å。对于每个原子,先对四个模型的三个力分量分别计算总体标准差,再对三个分量取欧氏范数;最后在所有原子间取最大、最小和平均。
写成公式是 σᵢ=√[Var(Fᵢx)+Var(Fᵢy)+Var(Fᵢz)],这里方差除以模型数4,不使用样本方差的除数3,也不是对“力的模长”先求标准差。
本例使用 max_devi_f,低阈值0.01、高阈值1.0 eV/Å:小于低阈值归为当前模型一致区间,低阈值到高阈值之间归为待标注候选,大于等于高阈值归为失败区间。阈值应结合自己的DFT误差和探索行为设定,本例数值不是所有体系的通用推荐。
四条轨迹各21帧,本次84帧全部位于候选区间。它们没有因此自动变成84个新DFT任务;本篇只完成训练与探索,没有运行FP筛选和补标。正式循环需按间隔、相似性或结构多样性去重并限制每轮标注数量。
2. 独立读取全部轨迹复核#
module load deepmd-kit/3.2.0
python analyze.py
analyze.py按原子ID读取全部84帧的完整坐标、类型与受力,用四个冻结模型重新预测。它比较模型0力与MD输出,独立计算四模型偏差,再与原生文件逐行比较,还检查两类分子的原子组成和最短距离;结果写入 VALIDATION.json、完整数组写入 analysis-fields.npz。
本次模型0力的最大差约1.1×10⁻¹⁶ eV/Å;委员会偏差最大读回差约3.0×10⁻⁸ eV/Å,主要来自原生偏差文件的显示精度。脚本另用位移±10⁻⁴ Å的能量中心差分检查两种留出结构上模型0的一项力分量。该检查验证模型的能量/力一致性,不替代DFT准确性检查。
3. 查看真正未参与训练的误差#
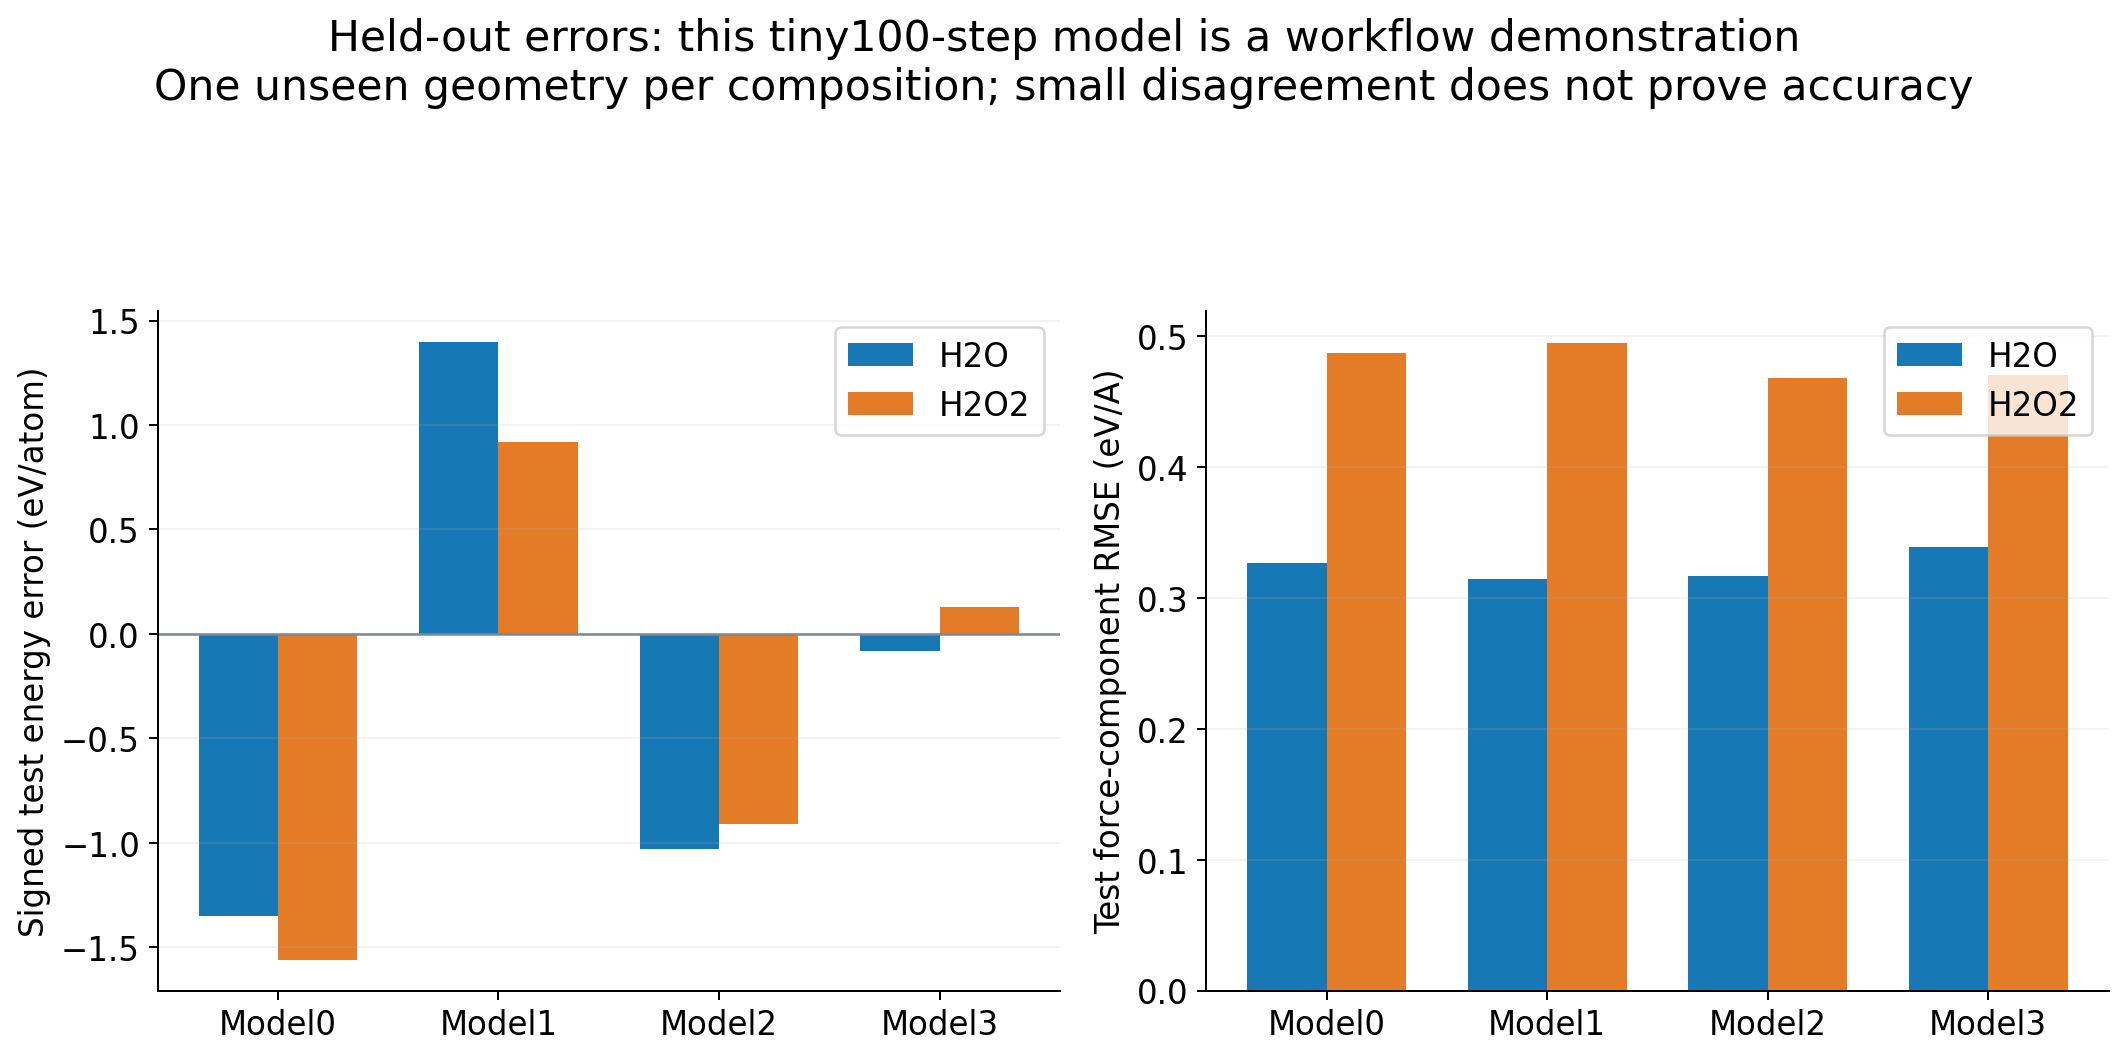
| 独立测试结构 | 模型 | 有符号能量误差/eV·atom⁻¹ | 力分量RMSE/eV·Å⁻¹ |
|---|---|---|---|
| H2O | 0 | -1.348481 | 0.327009 |
| H2O | 1 | 1.399289 | 0.314625 |
| H2O | 2 | -1.029755 | 0.316698 |
| H2O | 3 | -0.084067 | 0.338479 |
| H2O2 | 0 | -1.559379 | 0.486975 |
| H2O2 | 1 | 0.918875 | 0.494691 |
| H2O2 | 2 | -0.907860 | 0.467759 |
| H2O2 | 3 | 0.126406 | 0.470411 |
每个组分只留一个独立测试结构,上表能量误差为 (模型总能−DFT总能)/原子数,力RMSE在全部3N个分量上计算。结果说明这组小数据、100步训练模型尚不适合生产;即便模型之间的力分歧仅约0.06–0.12 eV/Å,真实力误差仍约0.31–0.49 eV/Å。四个模型可能一起预测错,不能凭偏差小就宣布训练完成。
本组PBE标签的原生净受力最大约0.198 eV/Å,体现当前有限网格/基组下的数值误差,脚本保留原值。正式模型既要增加并平衡不同组分、温度和局部化学环境,也要检查标签收敛和质量。
4. 重画结果与继续改进#
module purge
module load sisl/0.16.4
python plot.py
图保存在 plots/,无需再跑任何DFT、训练或MD。当前结果不理想时,先检查:元素顺序和单位是否一致、测试集是否独立、各组分是否有足够构型、训练损失是否继续下降、探索有没有离开训练域、DFT标签是否数值可靠。不要只放宽阈值来把候选变成“准确”。
需要继续主动学习时,按完整训练循环把候选送入DFT、汇总能量和力、加入训练集,再用保持独立的测试集评估。长时间探索、反应/成键断键、压力变化和高温新构型都需要单独补充数据,本篇4 fs短轨迹不能证明这些能力。