
DP-GEN多组分结构与标注数据
用水和过氧化氢认识共享元素映射、不同原子数系统及训练验证测试集,附完整结构与CP2K输入。
阅读本篇目录
同一套势函数需要处理不同化学计量比时,首先统一元素编号,再把不同原子数、不同组分的数据分成各自的系统目录。本例在鸢算科技集群实际计算水和过氧化氢:二者都含H/O,但H:O分别为2:1与1:1。它们是两个独立的分子系统,不是混合液体。
下载本组三篇共用的输入、真实标注、参考轨迹和运行绘图包。三篇按数据准备 → 组分与温度探索 → 模型偏差与误差检查阅读。完整选帧、DFT补标及再训练循环见既有入门教程。
1. 解压、提交、查看结果#
将下载文件保存为 example.zip,进入自己的工作目录:
python3 -m zipfile -e example.zip .
cd dpgen-composition
提交实际训练与探索:
sbatch job.slurm
使用CPU分区56核整节点申请规则;私有接口编译最多用8核,四次训练和四组MD顺序各用1核。CPU分区维护时请等待恢复,不在登录节点自行运行生产计算。已分配CPU作业内的直接入口是 bash run.sh。
本例使用DP-GEN0.14.0、DeePMD-kit3.2.0 TensorFlow、LAMMPS22Jul2025 Update6 CPU,编译接口用oneAPI2024.2,绘图用sisl0.16.4。脚本只在自己的解压目录构建CPU接口,公共模块无需修改。它会依次完成私有接口构建、四模型训练/冻结、四组MD、数据检查和绘图。默认直接使用附件中的真实DFT标签,避免每次练习重复量子化学计算。
完成后:
ls plots
cat VALIDATION.json
四张图分别是分子结构、标注数据、探索轨迹/模型偏差和留出误差。reference-results/是本文原始实算结果;新运行生成的数据在当前目录,二者分开保存。
2. 两个完整结构#
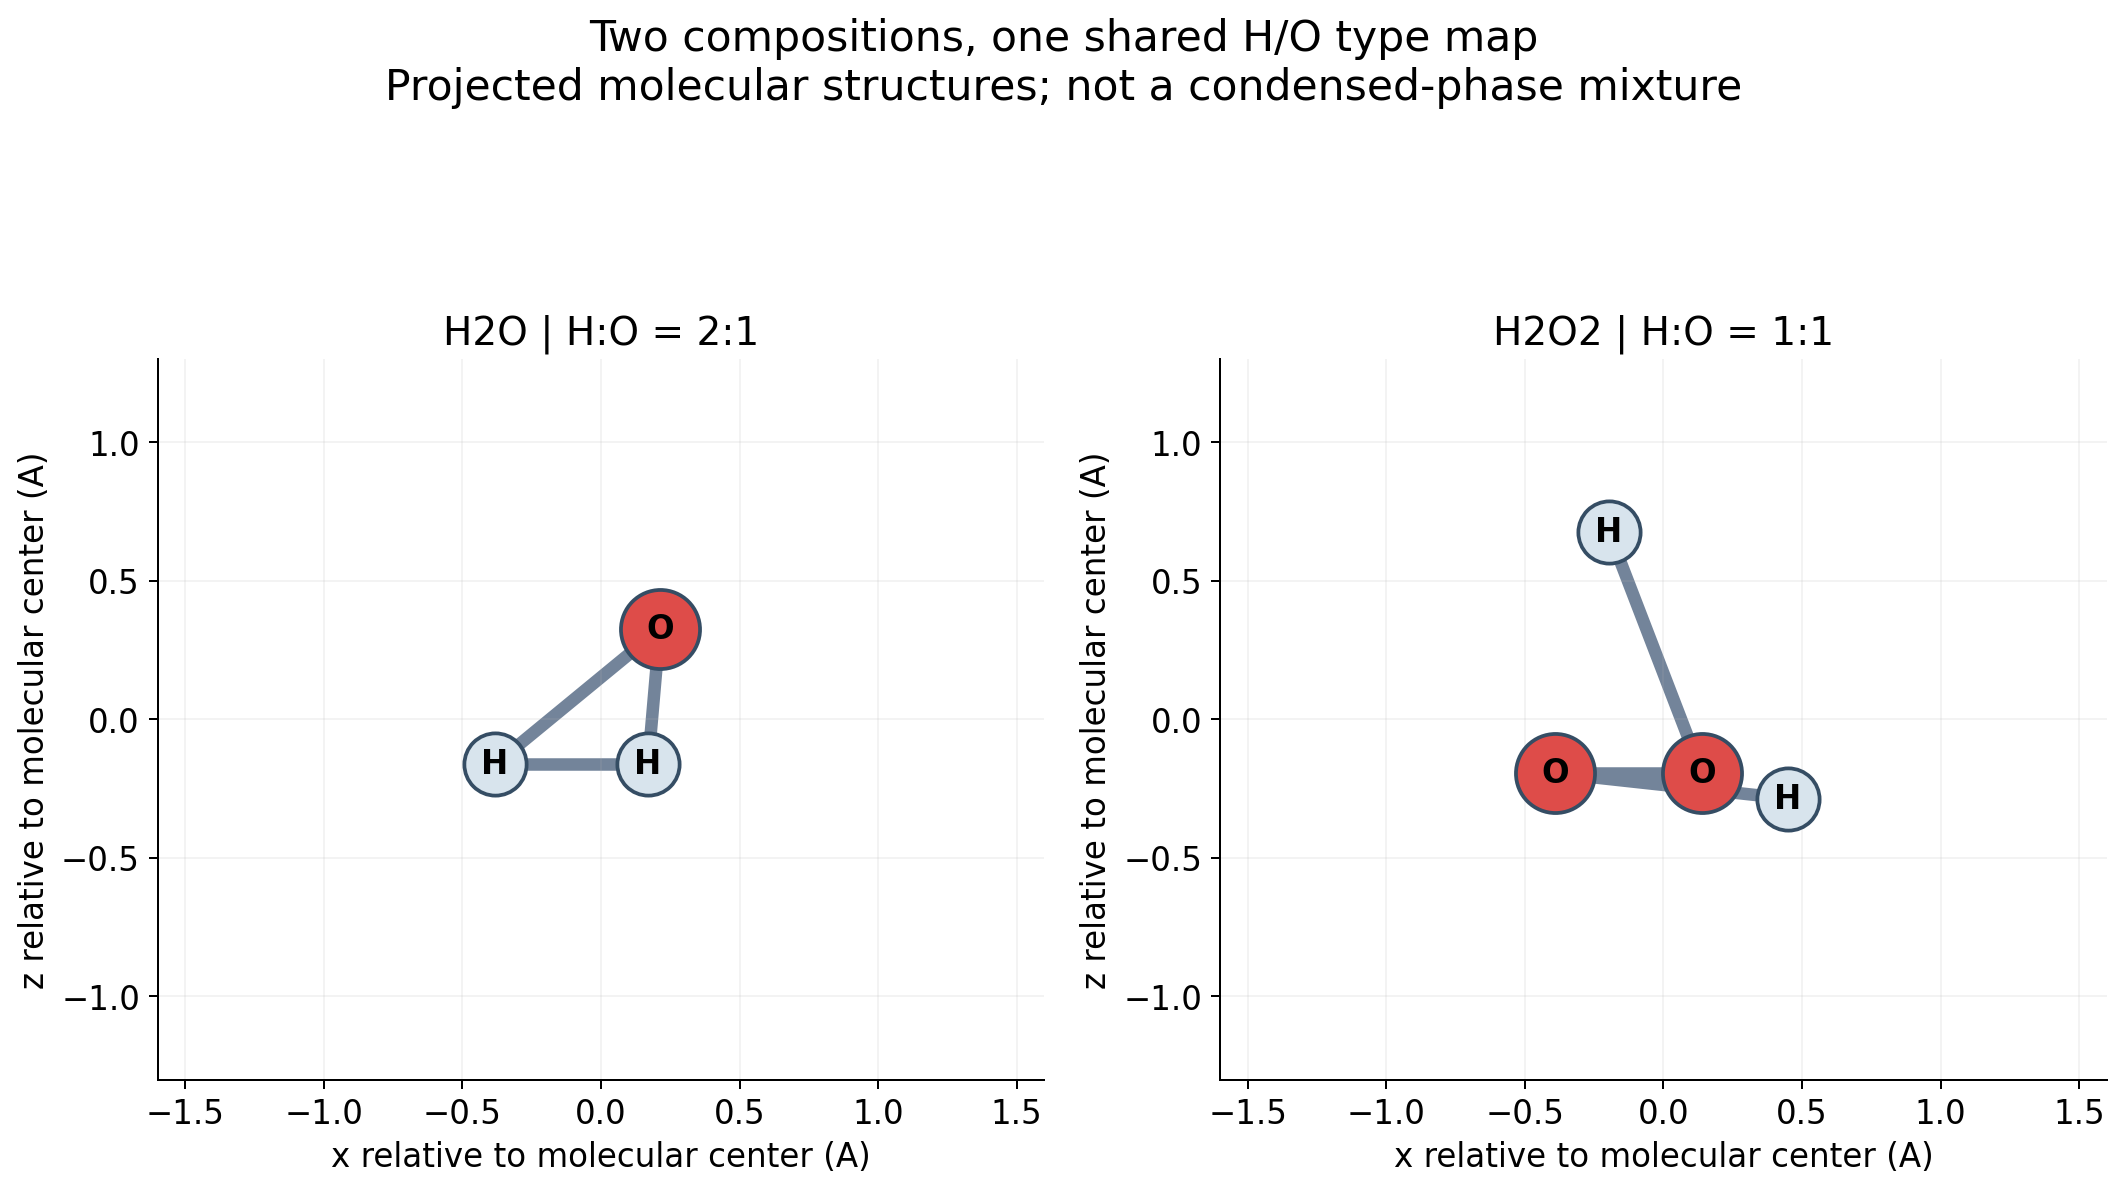
H2O 初始结构#
O  H
 1.0000000000000000
    12.0000000000000000    0.0000000000000000    0.0000000000000000
     0.0000000000000000   12.0000000000000000    0.0000000000000000
     0.0000000000000000    0.0000000000000000   12.0000000000000000
 O   H
   1   2
Cartesian
  6.2123257573209445  6.0823533395354739  6.3258423265822801
  5.6178381206620216  6.6704119211652673  5.8370788367088604
  6.1698361220170330  5.2472347392992589  5.8370788367088604
H2O2 初始结构#
O  H
 1.0000000000000000
    12.0000000000000000    0.0000000000000000    0.0000000000000000
     0.0000000000000000   12.0000000000000000    0.0000000000000000
     0.0000000000000000    0.0000000000000000   12.0000000000000000
 O   H
   2   2
Cartesian
  5.6077710450583282  6.6352081807110830  5.8054356419399200
  6.1386644465730003  5.2664434873893340  5.8054356419399200
  6.4498539846718490  7.1191628647446983  5.7136152005351004
  5.8037105236968225  4.9791854671548856  6.6755135155850587
结构给出12 Å真空盒。训练数据目录中有 nopbc 标志,探索也采用非周期边界;盒尺寸是坐标容器,不是液态分子的密度定义。DP-GEN生成的 conf.lmp 会重写坐标容器,核对元素与分子内部几何,不要求其盒长与POSCAR逐字相同。
3. 元素映射和数据目录#
cat data/train/H2O/type_map.raw
cat data/train/H2O/type.raw
cat data/train/H2O2/type.raw
ls data/train/H2O/set.000
所有系统的 type_map.raw 都是先H、后O,所以DeePMD的编号H=0、O=1;LAMMPS的类型编号从1开始,对应H=1、O=2。水结构原子顺序O,H,H,对应 type.raw 为1,0,0;过氧化氢为O,O,H,H,对应1,1,0,0。不要把“类型表先写H”误当成“坐标必须先排所有H”。
| 系统 | 每帧原子数 | 训练 | 验证 | 独立测试 |
|---|---|---|---|---|
| H₂O | 3 | 6 | 1 | 1 |
| H₂O₂ | 4 | 6 | 1 | 1 |
每个 set.000 中:coord.npy 是Å坐标,box.npy 是Å晶胞矩阵,energy.npy 是eV总能,force.npy 是eV/Å受力。不同原子数不能直接拼成同一个规则数组,因此保留为两个系统;训练参数同时列出两个目录。
每个系统含原结构和7个小位移结构,固定随机种子46417、位移标准差0.008 Å。编号0–5训练、6验证、7测试;测试构型没有传入训练器。附件的 labels-reference.json 逐帧保存原子顺序、位置、数据用途及原生输出校验值。
4. 这16份DFT标签如何得到#
全部采用CP2K2026.2 CPU、PBE、GTH赝势、DZVP-MOLOPT-SR基组、600 Ry/50 Ry网格、EPS_SCF 1E-8,每个构型计算一次能量和力,不先优化掉扰动。CP2K构建环境为oneAPI2024.2/IntelMPI;实际标签计算每次8个MPI进程、每进程1线程。完整水分子输入如下,过氧化氢及所有扰动输入也在 labels/ 中:
&GLOBAL
 PROJECT response
 RUN_TYPE ENERGY_FORCE
 PRINT_LEVEL MEDIUM
&END GLOBAL
&FORCE_EVAL
 METHOD QS
 &DFT
  &PRINT
   &MOMENTS ON
    PERIODIC .FALSE.
    REFERENCE COM
   &END MOMENTS
  &END PRINT
  BASIS_SET_FILE_NAME ../../DATA/BASIS_MOLOPT
  POTENTIAL_FILE_NAME ../../DATA/GTH_POTENTIALS
  &QS
   EPS_DEFAULT 1.0E-12
  &END QS
  &MGRID
   CUTOFF 600
   REL_CUTOFF 50
  &END MGRID
  &SCF
   EPS_SCF 1.0E-8
   MAX_SCF 100
   SCF_GUESS ATOMIC
   &OT
    MINIMIZER DIIS
    PRECONDITIONER FULL_SINGLE_INVERSE
   &END OT
  &END SCF
  &XC
   &XC_FUNCTIONAL PBE
   &END XC_FUNCTIONAL
  &END XC
  &POISSON
   PERIODIC NONE
   POISSON_SOLVER MT
  &END POISSON
 &END DFT
 &SUBSYS
  &CELL
   ABC 12 12 12
   PERIODIC NONE
  &END CELL
  &COORD
O 6.21232575732094 6.08235333953547 6.32584232658228
H 5.61783812066202 6.67041192116527 5.83707883670886
H 6.16983612201703 5.24723473929926 5.83707883670886
  &END COORD
  &KIND O
   BASIS_SET DZVP-MOLOPT-SR-GTH
   POTENTIAL GTH-PBE-q6
  &END KIND
  &KIND H
   BASIS_SET DZVP-MOLOPT-SR-GTH
   POTENTIAL GTH-PBE-q1
  &END KIND
 &END SUBSYS
 &PRINT
  &FORCES ON
  &END FORCES
 &END PRINT
&END FORCE_EVAL
标签生成脚本 run_labels.py 使用 mpirun -np 8 cp2k.psmp -i input.inp -o cp2k.out 这一计算形式,在分配到的核数不足8时相应减少进程数。运行环境需要无限栈 ulimit -s unlimited、每MPI进程1线程。附件已带原生输出;若自行重算,请用新副本,并按README重新解析与导出数据,不能只改参考校验值。
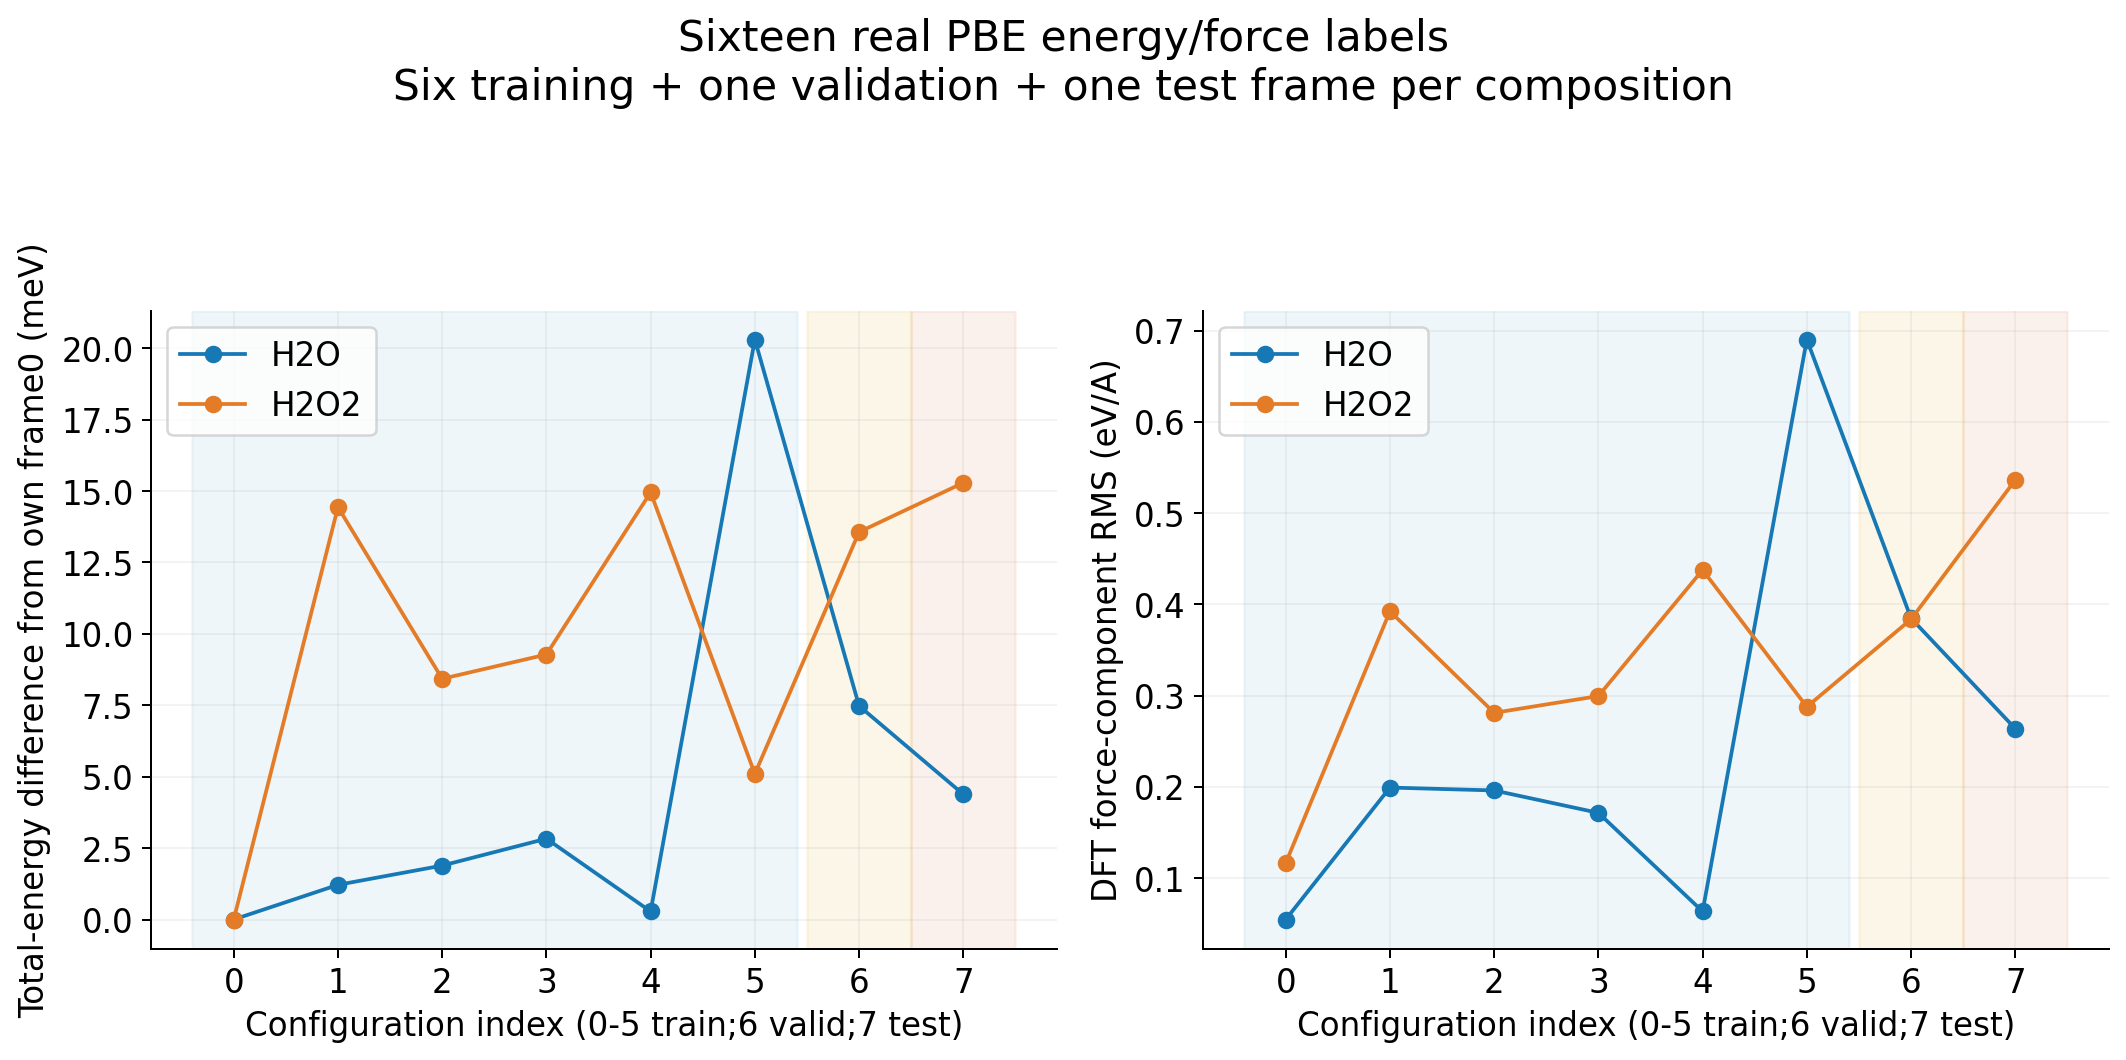
图中每种组分的能量都减去自己的第0帧,避免把不同化学计量比的绝对总能直接当成稳定性比较。本例未做基组/截断能/真空盒收敛;原生受力存在有限数值不平衡,未人为归零。数据用于工作流教学,正式训练前需提高标签质量并扩大构型覆盖。