
DP-GEN组分与温度探索矩阵
统一H/O模型训练后,分别探索两种组分的100K和300K短程NVT,展示完整参数和生成的LAMMPS输入。
阅读本篇目录
组分覆盖和温度覆盖是两件事。把温度改成多个值,并不会自动产生另一种化学计量比;必须先准备相应结构和初始标注,再把系统编号加入探索任务。本例将两个组分与两个温度组合成四个任务。
下载本组三篇共用的输入、真实标注、参考轨迹和运行绘图包。先按数据篇提交共同资料包,完整运行一次即可,不必为阅读三篇文档训练三遍。
1. 查看科学参数和启动方式#
cat param-template.json
cat run-dp.sh
cat run-lammps-cpu-args.sh
param-template.json定义结构、类型、训练和探索参数,运行时会把 __ROOT__ 换成解压路径,生成实际 param.json。machine.json由脚本生成,指定已分配资源内的本地顺序执行;本例先通过 job.slurm 获得CPU资源,再在该资源内运行,不会另开嵌套Slurm作业。
本例调用原生DP-GEN的五个阶段:make_train → run_train → post_train → make_model_devi → run_model_devi。这份参数针对训练与探索练习,不是可以直接替代完整生产 dpgen run 配置的全循环模板;选帧、FP与再训练请参考完整循环。
展开完整训练与探索参数
{
  "type_map": [
    "H",
    "O"
  ],
  "mass_map": [
    1.008,
    15.999
  ],
  "init_data_prefix": "__ROOT__/data/train",
  "init_data_sys": [
    "H2O",
    "H2O2"
  ],
  "init_batch_size": [
    2,
    2
  ],
  "sys_configs_prefix": "__ROOT__/structures",
  "sys_configs": [
    [
      "H2O.POSCAR"
    ],
    [
      "H2O2.POSCAR"
    ]
  ],
  "sys_batch_size": [
    2,
    2
  ],
  "numb_models": 4,
  "train_backend": "tensorflow",
  "model_format": "pb",
  "default_training_param": {
    "model": {
      "type_map": [
        "H",
        "O"
      ],
      "descriptor": {
        "type": "se_e2_a",
        "sel": [
          4,
          4
        ],
        "rcut_smth": 0.5,
        "rcut": 4.5,
        "neuron": [
          8,
          16
        ],
        "resnet_dt": false,
        "axis_neuron": 4,
        "precision": "float64"
      },
      "fitting_net": {
        "neuron": [
          16,
          16
        ],
        "resnet_dt": true,
        "precision": "float64"
      }
    },
    "learning_rate": {
      "type": "exp",
      "start_lr": 0.001,
      "stop_lr": 1e-05,
      "decay_steps": 20
    },
    "loss": {
      "type": "ener",
      "start_pref_e": 0.02,
      "limit_pref_e": 1.0,
      "start_pref_f": 1000.0,
      "limit_pref_f": 1.0,
      "start_pref_v": 0,
      "limit_pref_v": 0
    },
    "training": {
      "training_data": {
        "systems": [],
        "batch_size": 4
      },
      "validation_data": {
        "systems": [
          "__ROOT__/data/valid/H2O",
          "__ROOT__/data/valid/H2O2"
        ],
        "batch_size": 1,
        "numb_btch": 1
      },
      "numb_steps": 100,
      "disp_file": "lcurve.out",
      "disp_freq": 20,
      "save_freq": 100,
      "save_ckpt": "model.ckpt",
      "disp_training": true,
      "time_training": true
    }
  },
  "model_devi_dt": 0.0002,
  "model_devi_skip": 0,
  "model_devi_f_trust_lo": 0.01,
  "model_devi_f_trust_hi": 1.0,
  "model_devi_clean_traj": false,
  "model_devi_jobs": [
    {
      "sys_idx": [
        0,
        1
      ],
      "temps": [
        100,
        300
      ],
      "trj_freq": 1,
      "nsteps": 20,
      "ensemble": "nvt",
      "taut": 0.1,
      "_idx": "00"
    }
  ],
  "shuffle_poscar": false,
  "ratio_failed": 0.0,
  "model_devi_nopbc": true,
  "fp_task_min": 1
}
关键参数:
| 参数 | 本例值 | 需要理解的含义 |
|---|---|---|
type_map |
H,O | 所有组分共享相同类型顺序 |
numb_models |
4 | 独立初始化四个模型,用于委员会分歧 |
sys_idx |
0,1 | 同时使用水和过氧化氢两个系统 |
temps |
100,300 K | 每个系统分别在两个目标温度下探索 |
nsteps |
20 | 每个任务20步,连同初帧共21帧 |
model_devi_dt |
0.0002 ps | 即0.2 fs,总时长4 fs |
ensemble |
nvt | 控温、不调节盒体积 |
model_devi_nopbc |
true | 气相分子不使用周期镜像 |
start_pref_v/limit_pref_v |
0 | 本批没有virial标签,不训练virial |
四个模型都使用 se_e2_a、4.5 Å截断、双精度,每个只训练100步。这是快速练习的设置;正式势函数需要更大数据、足够训练步数和独立误差评估。不要把这一组100步参数直接当成生产推荐。
2. 查看生成的原生输入#
cat iter.000000/01.model_devi/task.000.000000/input.lammps
cat iter.000000/01.model_devi/task.000.000000/model_devi.out
第一组是水分子100 K,完整输入:
variable        NSTEPS          equal 20
variable        THERMO_FREQ     equal 1
variable        DUMP_FREQ       equal 1
variable        TEMP            equal 100.000000
variable        PRES            equal -1.000000
variable        TAU_T           equal 0.100000
variable        TAU_P           equal 0.500000

units           metal
boundary        f f f
atom_style      atomic

neighbor        1.0 bin

box          tilt large
if "${restart} > 0" then "read_restart dpgen.restart.*" else "read_data conf.lmp"
change_box   all triclinic
mass            1 1.008000
mass            2 15.999000
pair_style      deepmd ../graph.000.pb ../graph.001.pb ../graph.002.pb ../graph.003.pb  out_freq ${THERMO_FREQ} out_file model_devi.out
pair_coeff      * * H O

thermo_style    custom step temp pe ke etotal press vol lx ly lz xy xz yz
thermo          ${THERMO_FREQ}
dump            1 all custom ${DUMP_FREQ} traj/*.lammpstrj id type x y z fx fy fz
dump_modify 1 sort id format float %.17g
restart         10000 dpgen.restart

if "${restart} == 0" then "velocity        all create ${TEMP} 256788"
fix             1 all nvt temp ${TEMP} ${TEMP} ${TAU_T}
velocity        all zero linear
fix             fm all momentum 1 linear 1 1 1

timestep        0.000200
run             ${NSTEPS} upto
pair_style deepmd后面列出四个模型。第0个模型的力驱动轨迹,四个模型共同计算分歧,不是把四套力平均后积分。out_freq 1 每步输出偏差,dump每步保存坐标与力;17位输出便于可靠复核。restart变量由DP-GEN启动命令传入,包装脚本保留原生参数,不要只复制输入后直接执行而遗漏它。
boundary f f f对应非周期分子;目标温度是热浴设定,不代表4 fs内已达到平衡。这种真空分子不能对着盒体积做有材料意义的NPT,因此本篇没有给气相体系强加压力矩阵。
3. 实际运行得到什么#
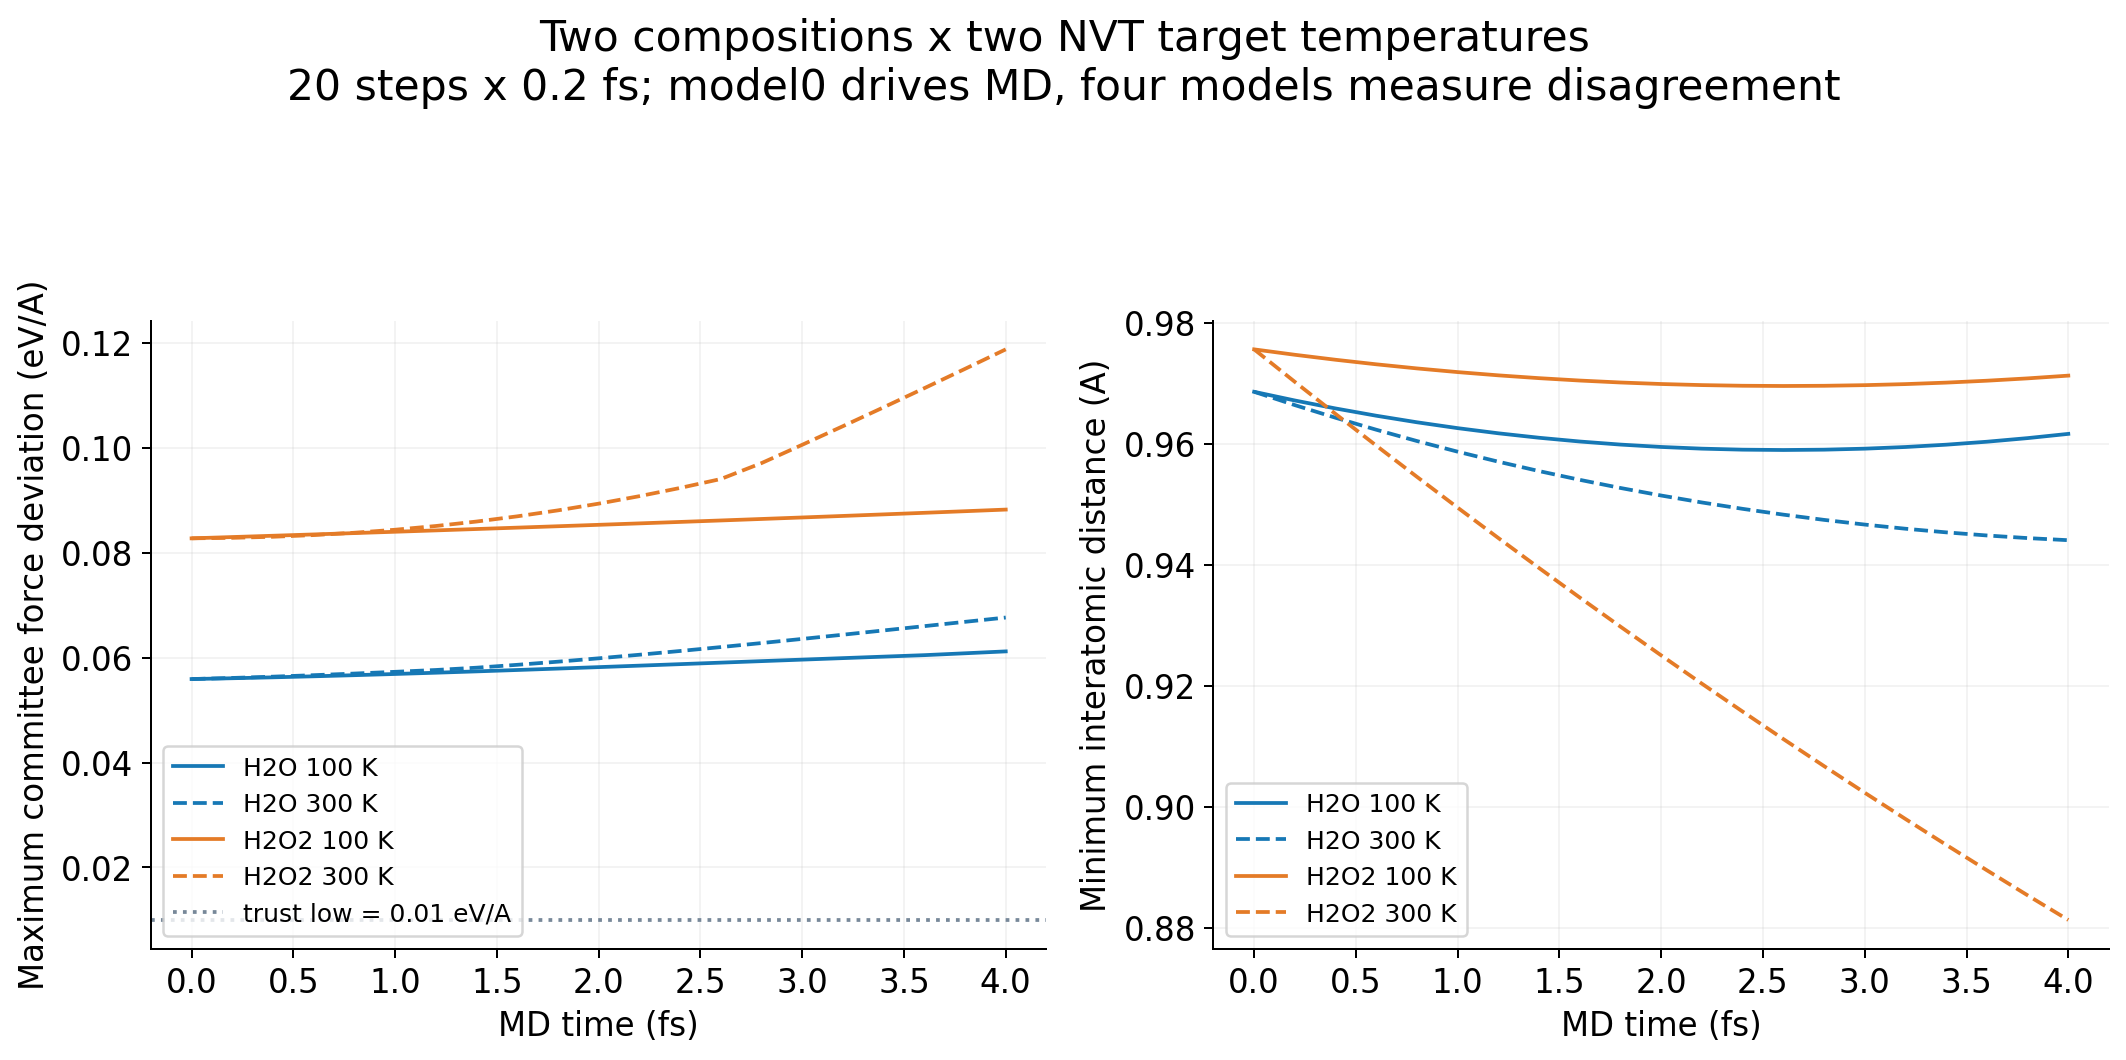
| 组分 | NVT目标温度/K | 保存帧数 | 最短原子间距/Å | 最大原子力偏差范围/eV·Å⁻¹ |
|---|---|---|---|---|
| H2O | 100 | 21 | 0.958951 | 0.055902–0.061172 |
| H2O | 300 | 21 | 0.944052 | 0.055902–0.067621 |
| H2O2 | 100 | 21 | 0.969526 | 0.082713–0.088189 |
| H2O2 | 300 | 21 | 0.881323 | 0.082713–0.118716 |
所有轨迹都是20步、4 fs,表内21帧包括第0帧。它们用于说明“多系统编号×多温度”的任务展开和数据读取,不用于计算扩散系数、反应速率、平衡结构或温度下的材料稳定性。
需要研究凝聚相温压覆盖时,先建立合理周期结构和对应标注,再启用NPT;既有Si完整循环已给出300/600 K与0/10000 bar四个短NPT实例。这与本篇的组分练习互补,不等于两种分子也在这些压力下完成了计算。