
MDAnalysis平均结构与迭代参考
从真实泛素轨迹运行等权Cα平均、主链质量权平均及迭代参考,说明完整分子、对齐与坐标平均的顺序。
阅读本篇目录
直接平均一条旋转、平移或跨周期边界的蛋白轨迹,通常得不到有意义的平均结构。正确顺序是读入可靠拓扑、使分子完整、按指定原子对齐,再对同一原子顺序的坐标求平均。
下载完整真实轨迹、拓扑、分析脚本和数据图包,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd mdanalysis-average-contact
sbatch job.slurm
三篇共用一次分析,不重新运行分子动力学。使用现有MDAnalysis2.9.0,Python位于qvasp2.26环境;这里只调用MDAnalysis及分析绘图库,不运行qvasp或VASP。CPU分区按56核整节点申请,实际最多2个分析进程;分区维护时等待恢复,在已分配CPU作业内可 bash run.sh。程序拒绝覆盖已有 VALIDATION.json,重复整套分析请使用新目录。
数据为此前已完成的真实GROMACS泛素轨迹,1231原子、76残基,原保存帧0、20至1000抽取51帧,实际时间0—100ps、间隔2ps。完整数组在 analysis-fields.npz,汇总在 VALIDATION.json,图在 plots/,本文参考原件在 reference-results/。
1. 先解决拓扑和时间轴#
head -n 6 inputs/protein-conect.pdb
head -n 6 inputs/topology-metadata.json
当前MDAnalysis2.9不能直接读取本例新版GROMACS TPR138。资料包使用此前核对过的PDB_CONECT与原始XTC,并由原生GROMACS dump导出质量、荷电、元素及残基序号到JSON;脚本逐原子检查残基顺序,不依靠猜测质量或新猜连通关系。
读取逻辑为:
import json
import MDAnalysis as mda
from MDAnalysis.transformations import unwrap
meta=json.load(open('inputs/topology-metadata.json'))
u=mda.Universe('inputs/protein-conect.pdb','inputs/protein.xtc')
u.add_TopologyAttr('masses',meta['masses'])
u.add_TopologyAttr('charges',meta['charges'])
u.add_TopologyAttr('elements',meta['elements'])
u.trajectory.add_transformations(unwrap(u.atoms))
u.transfer_to_memory(step=20)
unwrap依赖真实连通键,先使蛋白完整。本例抽样后的原生时间不是0—50ps,而是0—100ps;读取自己的轨迹时检查 ts.frame 和 ts.time,不要把帧序号当作ps。
2. 一次对齐参考下的平均结构#
from MDAnalysis.analysis.align import AverageStructure
ca_mean=AverageStructure(u,select='name CA',weights=None).run()
positions=ca_mean.results.positions
mean_frame_rmsd=ca_mean.results.rmsd
本例有76个Cα。results.positions是对齐后的平均坐标;results.rmsd为参与平均的各帧对参考的RMSD均值,不是“平均结构相对参考”的RMSD,也不是RMSF。
另一组使用 select='backbone', weights='mass',实际选中303个主链原子;这组含不同元素质量,不能用等权平均替代。每组使用独立Universe副本,避免内存轨迹对齐修改影响后续分析。
| 实际原生分析 | 原子数 | 帧对参考RMSD均值/Å | 全部平均坐标与独立Kabsch最大分量差/Å |
|---|---|---|---|
| Cα等权 | 76 | 0.8750972 | 9.1221e−7 |
| 主链质量权 | 303 | 0.8799147 | 1.1580e−6 |
3. 让平均结构自己成为参考#
from MDAnalysis.analysis.align import iterative_average
optimal=iterative_average(u,select='name CA',niter=50,eps=2e-5)
positions=optimal.results.positions
迭代过程用上轮平均结构重新对齐所有帧并再平均,直到参考变化小于给定eps。本例另外做独立Kabsch迭代,对两种结果作一个正常旋转/平移对齐后,全部Cα坐标最大差约2.143e−6Å。平均结构的整体朝向是参考约定,不能仅凭绝对朝向不同判定两次平均不一致。
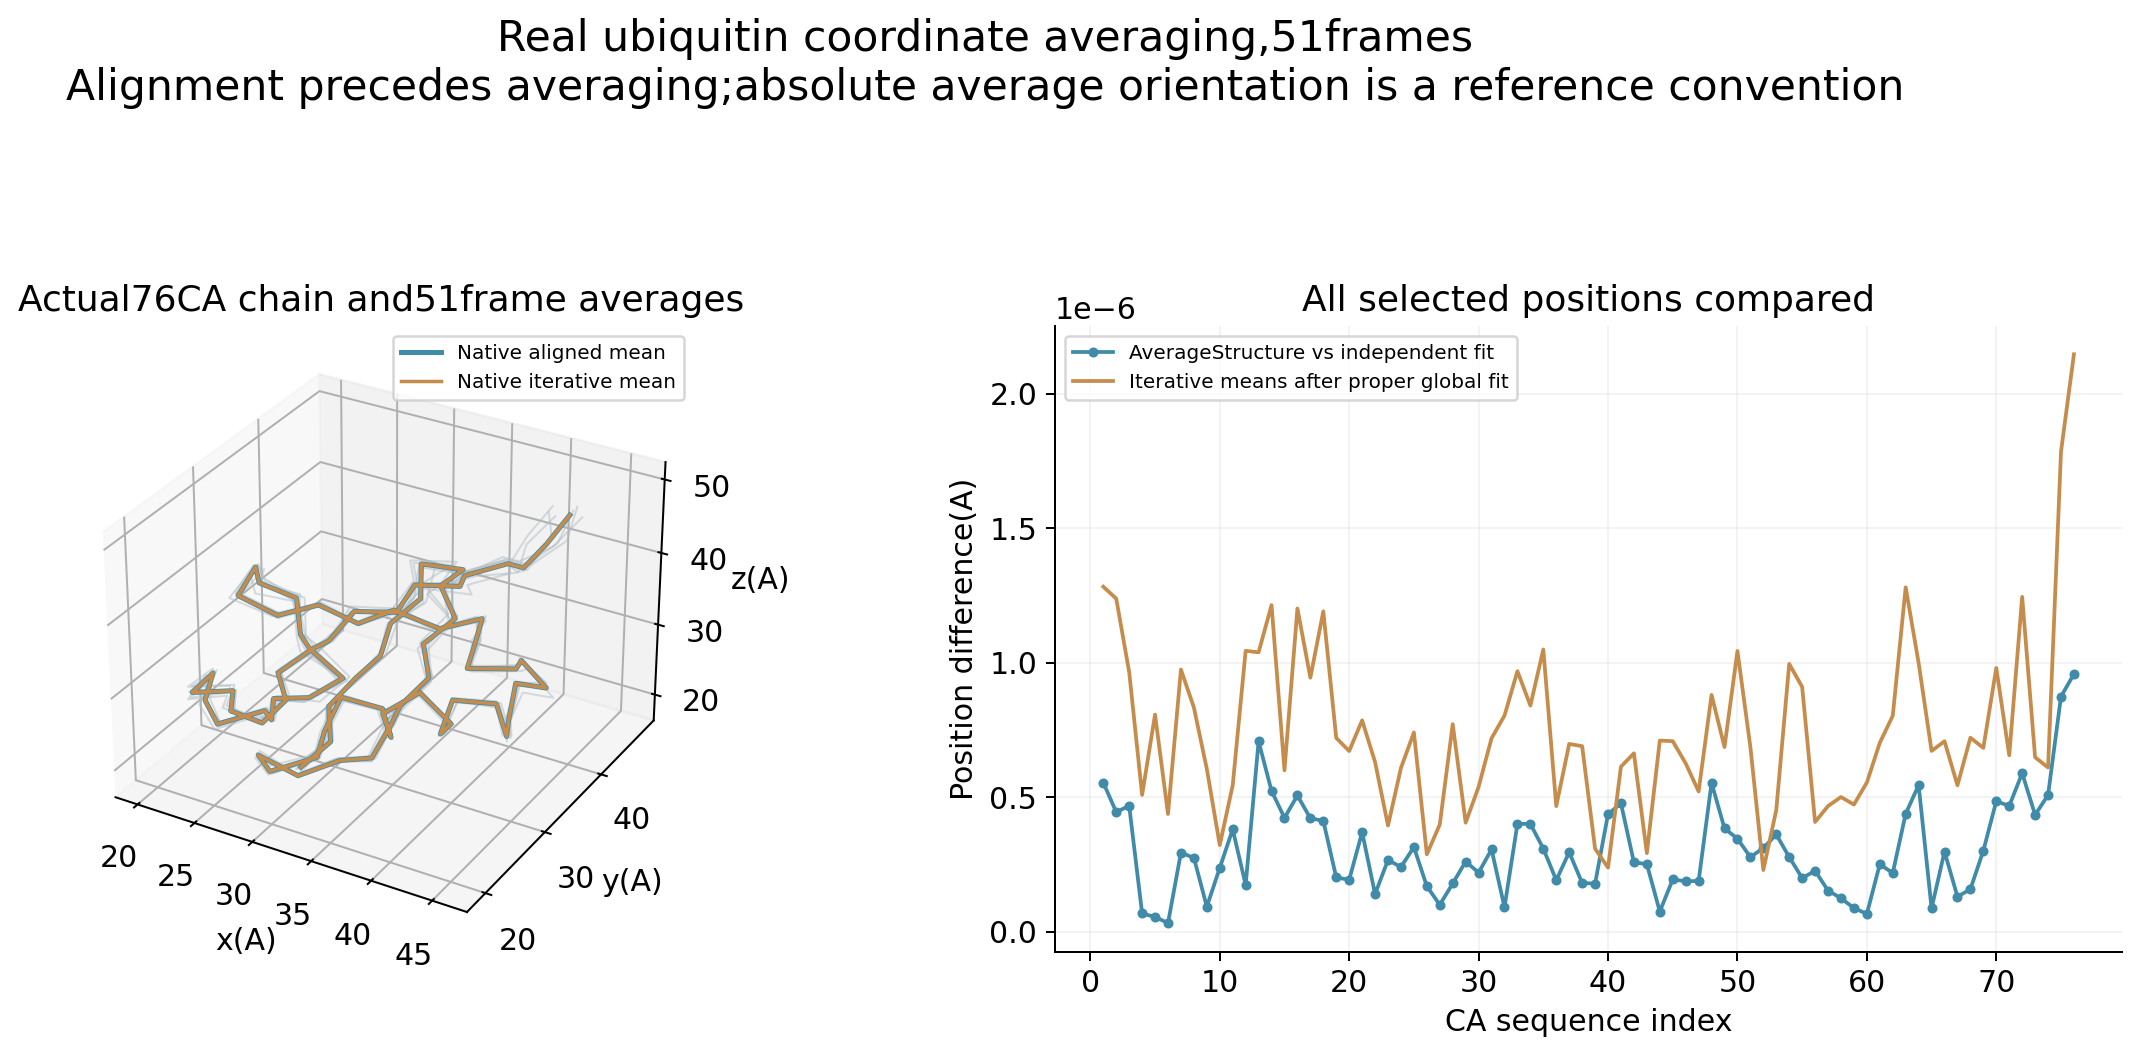
这些微埃级差异是相同有限精度输入的数值核对,不表示原MD轨迹具有微埃物理精度。100ps也不足以代表蛋白完整构象采样;如果有大尺度域运动,选择哪部分对齐会直接影响平均结构。
4. 导出平均坐标并只重画图#
export PATH="/public/toolkit/miniconda3/envs/qvasp-2.26/bin:$PATH"
python - <<'PYDATA'
import numpy as np
x=np.load('analysis-fields.npz')
np.savetxt('mean-CA.dat',x['CA-equal_average_native_A'],header='x_A y_A z_A')
np.savetxt('iterative-mean-CA.dat',x['iterative_average_native_A'],header='x_A y_A z_A')
PYDATA
export PATH="/public/toolkit/miniconda3/envs/qvasp-2.26/bin:$PATH"
python plot.py
只重新画图不重复分析。近接触网络见残基网络篇,两进程分析见分析框架篇。参考MDAnalysis2.9对齐与平均结构说明。