
Moltemplate按键赋电荷与生成文件
用实际逐键电荷分配说明DATA与运行电荷、避免重复连接累加,并解释生成文件及内部工具。
阅读本篇目录
Moltemplate生成的不只有一个DATA文件。初始化、相互作用系数、电荷和变量编号可能位于不同文件,运行时要按顺序读取。本篇沿用四珠子自动拓扑例子,说明按键赋电荷的方法,以及生成文件各自的用途。
1. 下载与完整流程#
下载完整LT、LAMMPS输入、真实输出与绘图脚本,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd moltemplate-graph-types-charges
先查看已经计算的数据:
bash show-reference.sh
cat graph-energy-forces.csv
cat charge-fields.csv
重新计算时,在新解压目录提交:
sbatch job.slurm
CPU模板按56核整节点申请,本例短任务实际单进程执行;分区维护时等待可用资源。在已分配的资源中也可以用 bash run.sh。脚本依次完成:生成拓扑和参数 → 对最终键表赋一次电荷 → 含电荷、仅读DATA、改变平衡角三个 run 0 → 导出表格和图片。重新执行整套流程请换新目录,避免覆盖已有 work/。
使用现有Moltemplate2.22.5/Python3.11与LAMMPS30Sep2026 CPU版,后者以Intel oneAPI2024.2、Intel MPI和MKL构建。分析绘图通过 sisl/0.16.4 的Python完成,不用修改公共软件。
2. 按每条键给两端原子分配电荷#
本例的规则为:
write_once("Data Charge By Bond") {
 @atom:A @atom:B 0.2 -0.2
}
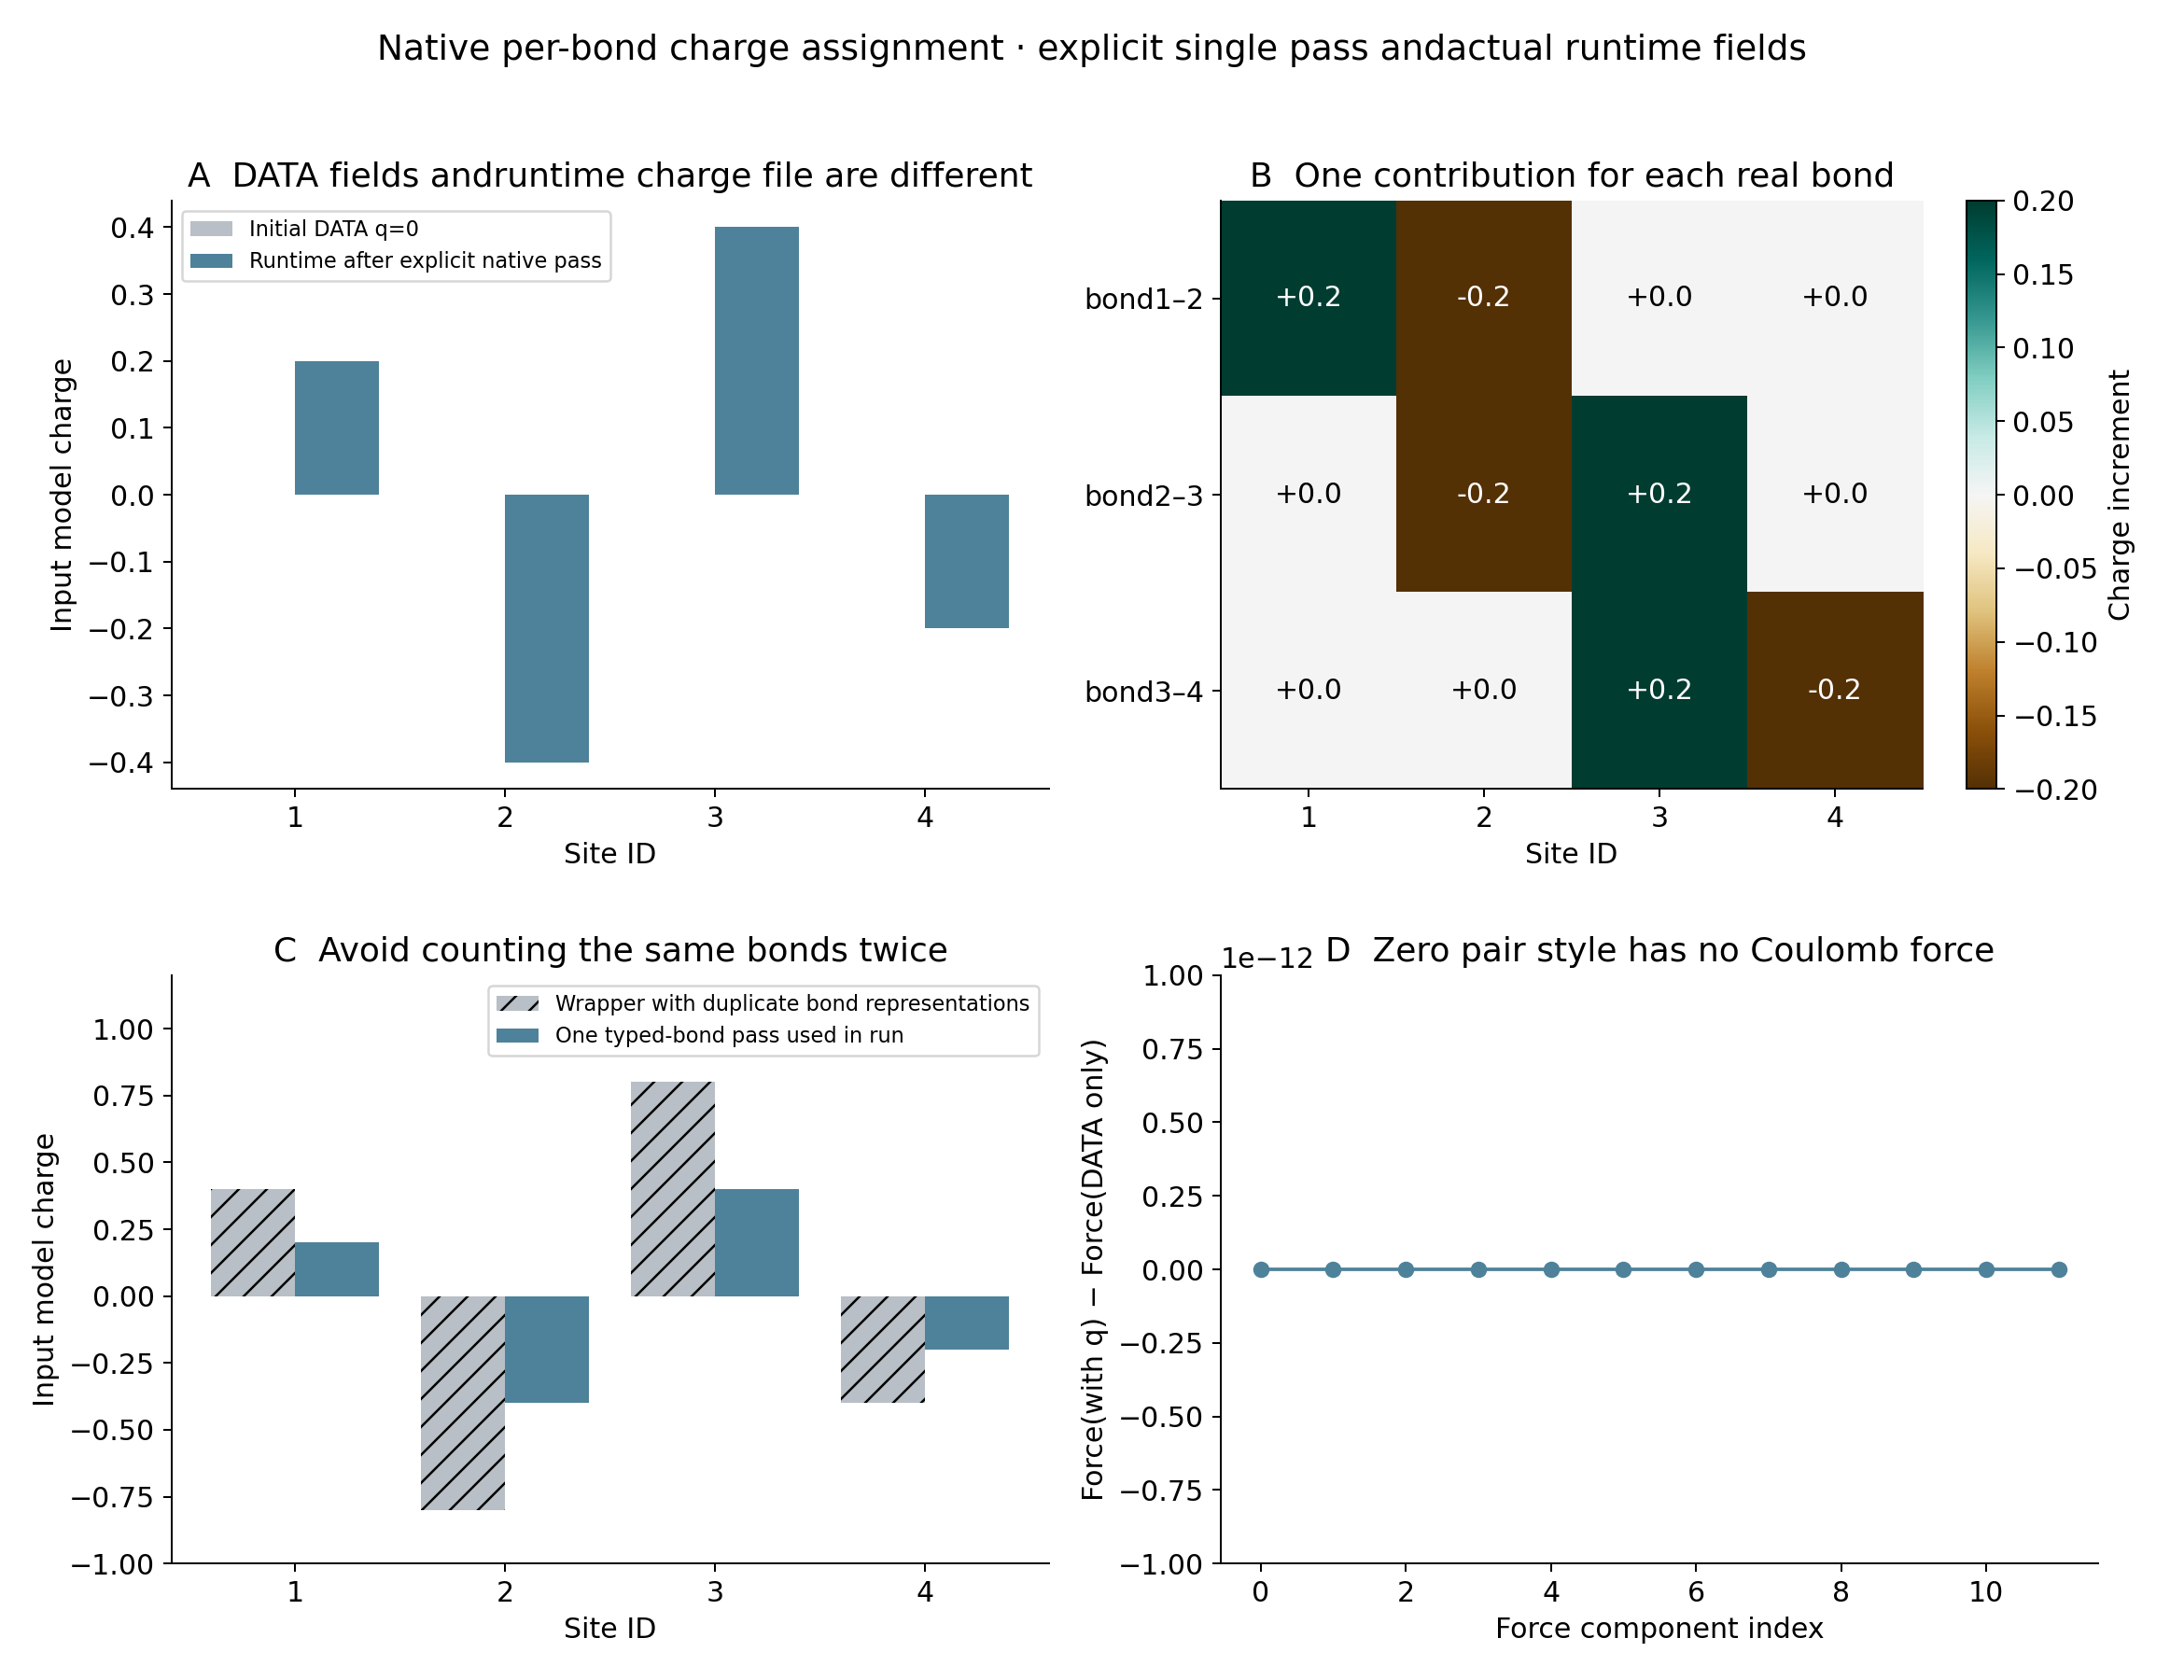
每个A–B连接对A贡献+0.2、对B贡献−0.2。内部原子各有两条连接,因此最终是:
| 原子ID | 类型 | 连接数 | 本例最终电荷数值 |
|---|---|---|---|
| 1 | A | 1 | +0.2 |
| 2 | B | 2 | −0.4 |
| 3 | A | 2 | +0.4 |
| 4 | B | 1 | −0.2 |
这些只是约化模型的输入数值,不能当作某种真实分子的电荷参数。两套互为倍数的电荷也可能都满足总和为0,因此只检查总电荷不足以发现重复累加,需要逐个原子核对。
3. 只给最终键表赋一次电荷#
在当前2.22.5的本例中,自动生成流程同时保留最终 Data Bonds 和原始 Data Bond List,默认调用会把相同连接算两次。随包工作流在建模后明确执行一次原生 charge_by_bond.py,只传最终的typed Bonds,不再同时传原始Bond List。
assign-charges.sh 的完整内容:
#!/bin/bash
# Run inside work/ after moltemplate.sh. Use exactly one representation of
# each bond: the final typed table. Do not also pass the original Bond List.
set -euo pipefail
charge_by_bond.py -atom-style full \
  -atoms 'output_ttree/Data Atoms' \
  -bonds 'output_ttree/Data Bonds' \
  -chargebybond 'output_ttree/Data Charge By Bond' > system.in.charges
这段脚本是给已生成的 work/ 使用的。直接查看真实参考结果并在自己的副本中重做一次:
source ./env.sh
cd reference-results/native
bash ../../assign-charges.sh
cat system.in.charges
输出为:
set atom 1 charge 0.2
set atom 2 charge -0.4
set atom 3 charge 0.4
set atom 4 charge -0.2
命令输出的是 set atom ... charge ...,会设置对应原子的最终值。本例的初始DATA电荷均为0;如果自己的DATA已有电荷,不能理解为它会自动加上所有原有值,应按力场定义处理基准电荷和键增量。自定义的电荷修改也应明确先后顺序,避免后一个文件覆盖前面的设置。
图中灰色保留了重复输入时的实际输出,蓝色才是后续计算采用的单次赋值:
4. 为什么DATA里还是0#
本例电荷通过 system.in.charges 进入LAMMPS,原 system.data 不随之改写。先看两个文件,再看实际导出的运行字段:
sed -n '/Atoms/,+6p' reference-results/native/system.data
cat reference-results/native/system.in.charges
cat charge-fields.csv
运行时的顺序为:
include system.in.init
read_data system.data
include system.in.settings
include system.in.charges
配套的 data-only 对照不读最后一行,因此运行电荷仍为0。两组能量和力相同是因为本例用了 pair_style zero,没有库仑作用;这不是“电荷对任何体系都不重要”。实际带电体系还要配置合适的相互作用和必要的长程处理。
5. 生成文件怎么用#
| 文件 | 用途 |
|---|---|
system.data |
盒子、质量、原子、初始电荷和各类拓扑。 |
system.in.init |
单位、atom_style和相互作用形式等初始化设置。 |
system.in.settings |
实际类型编号对应的系数。 |
system.in.charges |
读取DATA之后应用的电荷命令。 |
run.in.EXAMPLE |
生成的运行示例;正式使用前检查自己的任务设置。 |
output_ttree/ttree_assignments.txt |
变量名到数字编号的对应表。 |
output_ttree/*.template |
保留变量表达式的中间模板。 |
output_ttree/Data Bonds等 |
已经展开的分段数据,适合核对与工具处理。 |
查看本例文件和编号:
ls reference-results/native
head -n 12 reference-results/native/output_ttree/ttree_assignments.txt
cat 'reference-results/native/output_ttree/Data Bonds'
cat 'reference-results/native/output_ttree/Data Angles'
cat 'reference-results/native/output_ttree/Data Dihedrals'
6. 自动调用的内部工具#
本例构建实际调用了下面这些入口。日常主要运行 moltemplate.sh,根据需要再使用赋电荷、格式转换等工具;一般不必把全部内部步骤手工重跑一遍。
| 入口 | 作用 |
|---|---|
moltemplate.sh |
组织整个构建流程。 |
lttree_check.py |
检查LT语法及所需参数定义。 |
lttree.py |
展开LAMMPS模板、对象和变量。 |
ttree_render.py |
将变量编号应用到文本模板。 |
bonds_by_type.py |
按原子类型匹配键类型。 |
nbody_by_type.py |
从连接图生成并匹配角、二面角等相互作用。 |
nbody_reorder_atoms.py |
按相互作用的对称规则整理原子顺序。 |
nbody_fix_ttree_assignments.py |
协调自动生成相互作用后的变量编号。 |
charge_by_bond.py |
累计每条键给两端原子的电荷贡献。 |
remove_duplicate_atoms.py |
处理重复原子定义。 |
remove_duplicates_nbody.py |
处理重复相互作用定义。 |
renumber_DATA_first_column.py |
整理相应DATA片段的首列编号。 |
postprocess_input_script.py |
整理生成的输入脚本。 |
postprocess_coeffs.py |
处理参数命令中的类型表达。 |
lttree_postprocess.py |
检查展开后生成文件中的对应关系。 |
这张表说明本例中各程序的角色,不代表每个可选参数、特殊势或外部模拟引擎都已覆盖。手工修改中间文件后,重新构建可能覆盖它们;长期应将模型与参数修改留在LT源文件或明确的后处理脚本中。
需要转换快照,见轨迹与DATA转换;需要反向生成LT,见模板还原与类型清理。官方说明:Moltemplate手册。