
LAMMPS 剪切流实操:SLLOD、速度分箱与温度
LAMMPS 30Sep2026 剪切流的终端操作、完整输入、速度分箱及温度与应力数据提取。
阅读本篇目录
本例从 500 个 Lennard-Jones 粒子开始,先短时预热,再让模拟盒沿 xy 方向剪切。您将得到原子轨迹、沿 y 分箱的速度曲线、去掉流动速度后的温度,以及剪切压力随时间的变化。
这是一套短轨迹操作参考。预热只有 500 步,剪切只有 3000 步,不能据此认定体系已经充分平衡,也不能把输出的压力平均值直接当成收敛黏度。
1. 下载并进入算例#
下载输入、真实轨迹与绘图资料包。在登录节点将下载的 ZIP 放到当前目录,然后运行:
python3 -m zipfile -e lammps-sllod-6852deca2b.zip lammps-SLLOD
cd lammps-SLLOD
包中 reference/ 是已经计算好的结果;worker.py 生成各组输入,p100.slurm 与 v100.slurm 是作业脚本。重新计算的输出放在 work/,不会覆盖参考结果。
cat p100.slurm
本例使用 LAMMPS 30Sep2026,GCC 13.3.0、OpenMPI 5.0.10 与 CUDA 12.8。本资料包统一使用 Kokkos 5.2.1 双精度后端。GPU 包采用混合精度;对于这种在截断处力不连续的 LJ 模型,极靠近截断半径的粒子对可能因舍入改变是否计入力,比较逐原子力时建议保持双精度后端一致。请使用配套版本:2026 年 SLLOD 增加了新的可逆积分器及相关选项,较旧版本不能直接照搬全部命令。
2. 一条命令提交整套短算例#
bash run.sh
脚本依次提交 P100 和 V100 16G 两个 Slurm 作业,每个申请 1 张 GPU、2 个 CPU 核,实际使用 1 个 MPI 进程和 1 个线程。共 12 组:两种 GPU 平台的 Kokkos 后端 × 两个剪切速率 × 两个随机种子,另有四种 P100 Kokkos SLLOD 选项对照。请保持终端运行直至脚本结束;sbatch --wait 会等待计算完成,排队也会增加等待时间。需具备对应分区权限。若中途停止,先用 squeue -u "$USER" 查看仍在运行的作业,再决定是否取消;不要对同一目录反复启动。
重新开始整套任务时请使用新解压目录。运行结束后自动生成 figures/ 三张图片和 tables/ 十二份 CSV。
3. 看懂完整输入#
下面是速率 0.1、种子 32001 的输入,速度分箱格式已补上列间空格,可直接读成数表:
units lj
atom_style atomic
boundary p p p
lattice fcc 0.8442
region cell block 0 5 0 5 0 5
create_box 1 cell
create_atoms 1 box
mass 1 1.0
pair_style lj/cut 2.5
pair_coeff * * 1.0 1.0 2.5
pair_modify shift yes
neighbor 0.3 bin
neigh_modify every 1 delay 0 check no
velocity all create 1.2 32001 mom yes rot no dist gaussian
timestep 0.001
fix eq all nvt temp 1.2 1.2 0.2
thermo 100
thermo_style custom step atoms temp pe ke vol
thermo_modify norm no format float %.16g
run 500
write_restart warmup.restart
unfix eq
reset_timestep 0
change_box all triclinic
fix deform all deform 0 xy erate 0.1 remap v units box
fix flow all nvt/sllod temp 1.2 1.2 0.2 peculiar no kick yes integrator reversible psllod no
compute td all temp/deform
compute tlab all temp
compute pp all pressure td
compute sa all stress/atom td
compute layers all chunk/atom bin/1d y lower 0.1 units reduced
fix profile all ave/chunk 1 1 100 layers vx vy vz file velocity.profile format " %.16g"
thermo_style custom step atoms temp c_td c_tlab c_flow_temp c_pp[4] pe ke vol xy
thermo_modify temp td norm no format float %.16g
dump trace all custom 100 shear.dump id type x y z vx vy vz fx fy fz c_sa[4]
dump_modify trace sort id format float %.16g pbc yes
print BEGIN_SHEAR
run 3000
write_data final.data nocoeff
units lj:全部为约化单位,不是 K、ps、GPa。质量、ε、σ 都为 1,粒子数密度 0.8442,截断半径 2.5σ,并将截断处的势能平移到零。run 500:预热;write_restart warmup.restart保存预热末态。本例为讲解工作流而缩短预热,实际研究需延长并检查平衡。fix deform ... 0 xy erate 0.1 remap v:盒子发生简单剪切,工程剪切应变为速率乘时间。0对应当前可逆 SLLOD 的每步更新要求。peculiar no kick yes:保存包含流动分量的实验室速度,初始流动速度由 fix 添加一次。不要再额外velocity ... ramp,否则会重复添加。compute td all temp/deform:扣除指定的仿射流动速度后计算热运动温度。compute tlab all temp则直接用保存速度计算,两者通常不同。compute ... chunk/atom和fix ... ave/chunk:沿 y 分十箱,每 100 步输出一次瞬时速度均值。format " %.16g"中开头的空格用于分隔各列。neigh_modify every 1 delay 0 check no:本例每步重建邻居列表,使坐标、周期边界与速度偏置在同一输出时刻保持一致;这是本教学输入的选择,并非性能调优结论。
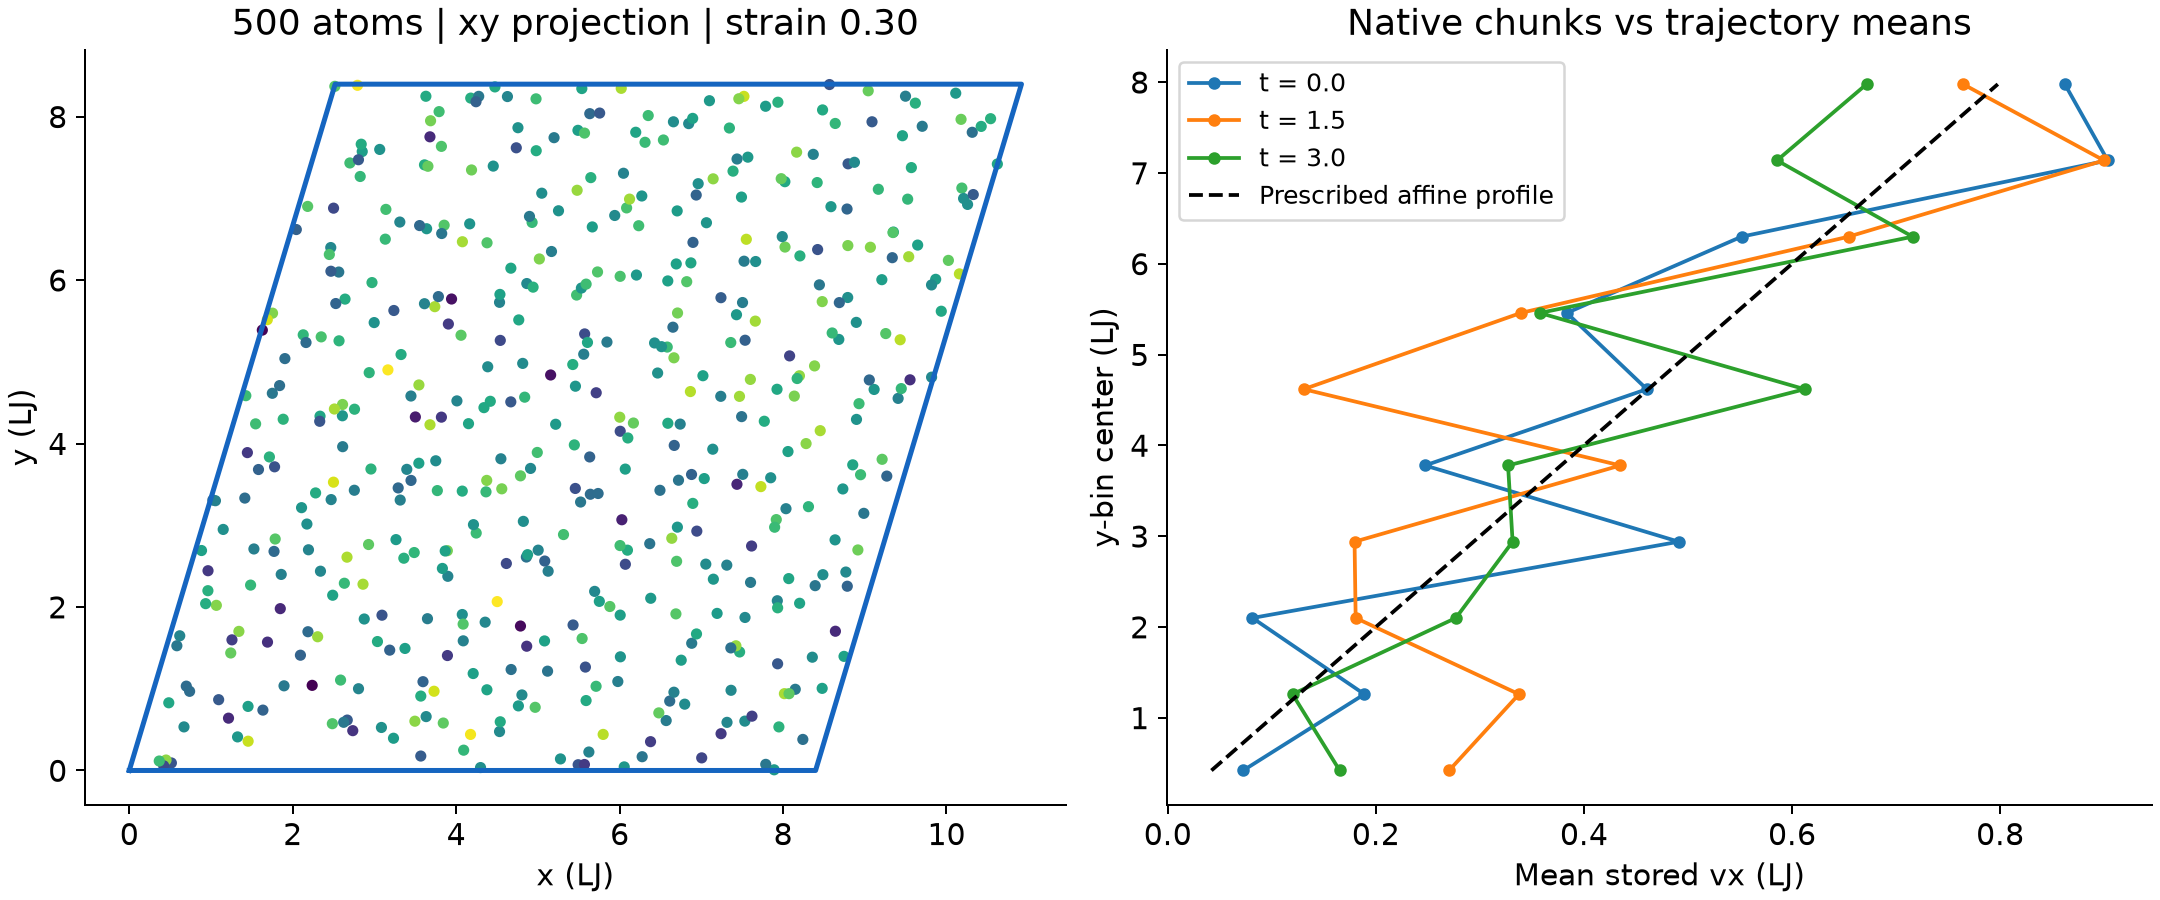
左图是最终轨迹的 xy 投影;颜色表示保存的 vx,边框是剪切后的周期盒。右图来自原生分箱结果及轨迹独立取数,虚线仅表示指定的仿射速度。短轨迹和每箱有限粒子会产生起伏,不能假定实测速度剖面始终与虚线重合。原图。
4. 查看数据与重新画图#
head -n 6 tables/p100-kokkos-rate0.10-s32001.csv
CSV 保留步数、应变、热运动温度、保存速度对应温度、恒温器温度、Pxy、独立重算 Pxy、每原子势能、动能、体积和 xy 倾斜量。最终应变为 0.1 × 3000 × 0.001 = 0.30。
若只想看随包提供的结果,无需提交新作业:
bash analyze.sh
重新处理自己刚计算的 work/:
bash analyze.sh work
分析脚本使用集群现有 ASE 3.29.0 环境中的 NumPy 与 Matplotlib,按真实周期盒重算粒子对能量、力和剪切维里,再输出图表。它会遍历全部轨迹,运行需要一些时间。GPU 归约和动力学微小差异可使新轨迹逐渐分离,新旧曲线无需逐字节相同;应比较各条轨迹本身的物理量定义与稳定性。
详见 LAMMPS 官方 SLLOD、盒形变 与 速度分箱。