
LAMMPS 裂纹加载实操
用2880粒子二维LJ薄片实际演示预制缺口、恒速张开、GPU Slurm任务和粒子结构输出。
阅读本篇目录
这篇用鸢算科技集群实际运行的二维 Lennard-Jones 薄片,说明怎样准备预制缺口、施加张开位移和保存可观察的粒子轨迹。下一篇继续提取反力、近邻变化和 OVITO 数据。
模型有 2880 个粒子,使用 LJ 约化单位;它帮助理解输入与结果,不对应某一种已标定的金属。长度单位为 σ,能量为 ε,质量为 m,时间为 τ=σ√(m/ε),力为 ε/σ。不要将图中的力值直接读成牛顿或 GPa。
1. 解压,先观察已有结果#
下载完整输入、八组真实轨迹和绘图包,在登录节点执行:
python3 -m zipfile -e lammps-LJ-crack-wave540-45cee1432795.zip LJ-crack
cd LJ-crack
head -n 20 sheet.data
sheet.data 包含 60 列、48 行的错位三角晶格,最近邻距离约 1.114277 σ,行间距约 0.964992 σ。五个粒子类型的质量和 LJ 参数完全相同;类型用于区分缺口两侧与夹持层,不代表五种元素。
bash analyze.sh
这一步读取附带的实际输出、提取曲线并重画四张图,不会开始新的分子动力学计算。输入数据在 reference/,图在 figures/,八份数据表在 tables/。
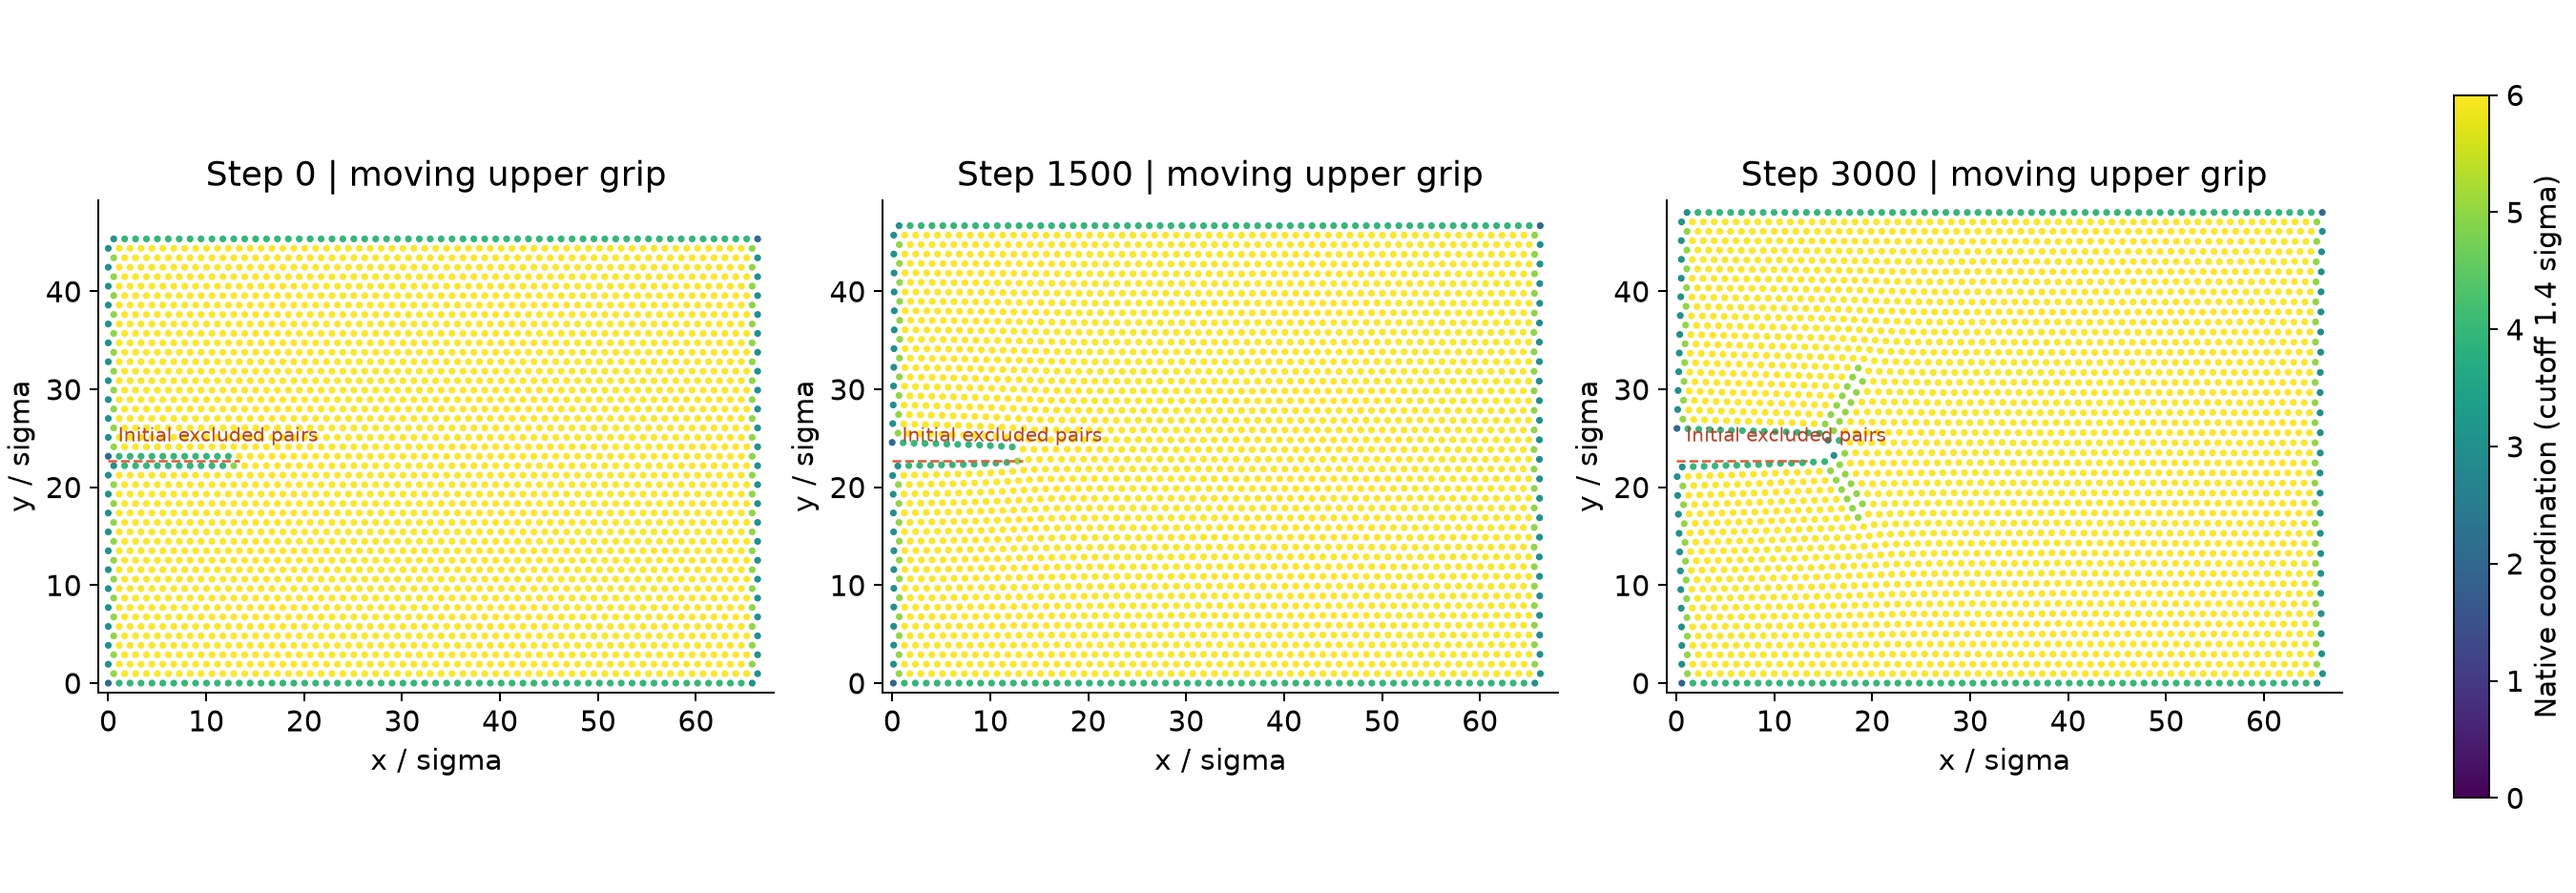
图示为固定选取的较快加载实例。颜色是 LAMMPS 输出的 1.4 σ 截断配位数;左侧虚线标出最初不相互作用的缺口区。图中没有删除缺口两侧的原子,所有 2880 个粒子始终保留。
2. 从头提交八个短任务#
bash run.sh
脚本使用普通账号 Slurm,分别提交 P100 和 V100 16G 的 Kokkos 版本;每个平台测试上夹持层速度 0.15、0.30 两种情形,每种速度使用随机种子 48001、48002。每个任务一张 GPU、两个申请的 CPU 核心、一个 MPI 进程和一个 OpenMP 线程。
计算完会自动分析和画图。work/ 已存在时脚本拒绝覆盖;新一轮计算请解压到新目录。八个任务的作业号保存在:
cat work/SUBMISSIONS.json
终端中断并不自动取消已提交的任务。需要停止时先根据这里的作业号查看 squeue,再正常取消自己需要停止的作业;重新解压前先确认旧作业状态。
3. 实际 LAMMPS 输入#
cat work/p100-speed0.3-seed48001/in.lmp
ls figures
以下为这组实际输入;脚本在各自实例子目录运行,../sheet.data 指向共用结构:
units lj
dimension 2
boundary s s p
atom_style atomic
read_data ../sheet.data
pair_style lj/cut 2.5
pair_coeff * * 1.0 1.0 2.5
neighbor 0.3 bin
neigh_modify every 1 delay 0 check yes exclude type 2 3
group lower type 4
group upper type 5
group grips union lower upper
group mobile subtract all grips
compute thermal mobile temp
velocity mobile create 0.01 48001 mom yes rot no dist gaussian temp thermal
velocity lower set 0.0 0.0 0.0
velocity upper set 0.0 0.3 0.0
velocity mobile ramp vy 0.0 0.3 y 2.412480714425727 42.942156716777944 sum yes units box
fix integrate all nve
fix raw all store/force
fix constrained grips setforce NULL 0.0 0.0
fix planar all enforce2d
compute interaction all stress/atom NULL pair
compute coordination all coord/atom cutoff 1.4
compute reaction upper reduce sum f_raw[2]
timestep 0.003
thermo 100
thermo_style custom step atoms c_thermal pe ke etotal c_reaction
thermo_modify norm no format float %.16g
dump frames all custom 100 crack.dump id type x y z vx vy vz fx fy fz f_raw[1] f_raw[2] c_interaction[1] c_interaction[2] c_interaction[4] c_coordination
dump_modify frames sort id format float %.16g
run 3000
write_data final.data nocoeff
dimension 2 必须放在读入模拟盒之前,fix enforce2d 保持位置、速度和运动在平面内。x、y 为自由边界,z 仅满足二维 LAMMPS 的周期边界要求,不代表一层层重复的三维材料。
缺口两侧分别用类型 2、3 标记;neigh_modify ... exclude type 2 3 使这些类型之间不再计算相互作用。这是持续生效的类型排除,不会因为粒子后来移动就自动解除。它也不是通过删除原子构造一个有有限宽度的槽。
底部三行是类型 4,顶部三行是类型 5。fix setforce NULL 0 0 将夹持层 y、z 力设为零,但保留 x 方向的横向响应。将力设为零不等于将速度设为零:顶部预先赋予 vy=0.30,之后仍持续向上运动;底部初始 vy=0,因此保持其纵向位置。
本例只在最初给 mobile 粒子生成 0.01 的随机速度温度,再叠加纵向速度坡度;加载期间没有恒温器。输出 c_thermal 是 mobile 粒子的动能温度,包含所加的流动/加载速度,不应当作已经减去流动速度的纯热温度。
4. 运行多长,怎样比较#
时间步长 0.003,运行 3000 步,总时间为 9 τ。顶部总位移分别为 1.35 σ 和 2.70 σ;每 100 步保存一次轨迹,包含初始态共 31 帧。
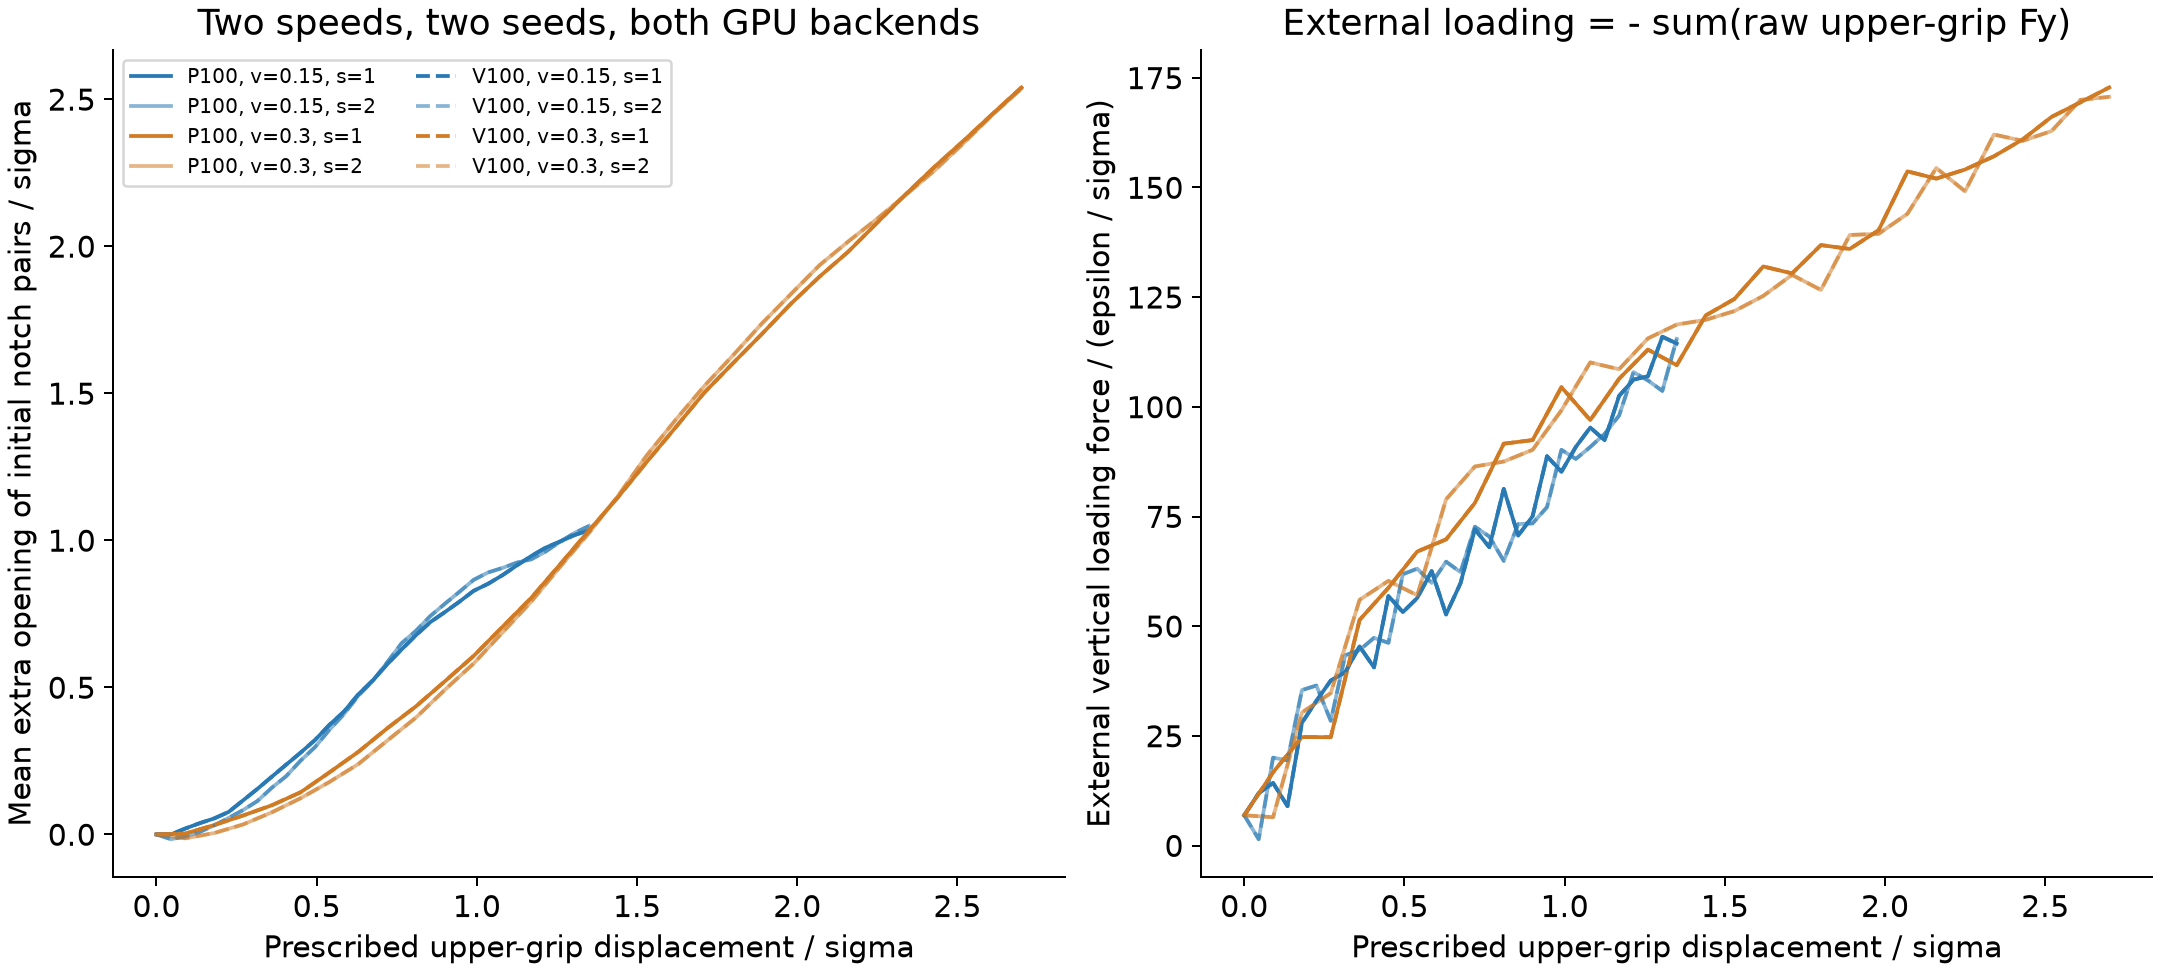
较慢两种子末态平均额外缺口张开约 1.0341、1.0491 σ;较快约 2.5402、2.5361 σ。较快加载的顶部外加载荷约 172.80、170.66 ε/σ,较慢约 114.42、115.50 ε/σ。P100 和 V100 16G 的本例曲线接近重合;两种子间的小幅差异保留在图与数据表中。
这些是给定尺寸、速度和短时间下的动态响应。不能从两条速率曲线直接推出准静态断裂强度、临界应力强度因子或收敛的断裂韧度。做材料研究时,还需要合适的势函数、三维厚度/二维面积定义、晶向、边界、初态平衡、尺寸和加载速度检查。
本例使用 LAMMPS 30Sep2026、GCC 13.3、CUDA 12.8、OpenMPI 5.0.10、Kokkos 5.2.1;模块为 lammps/30Sep2026-p100-kokkos、lammps/30Sep2026-v100-kokkos。思路可对照官方裂纹示例,二维设置见dimension 文档。