
LAMMPS 镍晶体拉伸实操
建立500原子FCC镍,先最小化与控温,再沿y方向加载,输出应力、应变和完整轨迹。
阅读本篇目录
本篇用 500 原子 FCC Ni 跑通 建立晶胞 → 能量最小化 → 控温预热 → 拉伸 → 分析与作图。所有曲线和结构来自鸢算科技集群实际运行。先学会固定横向尺寸的做法,再到横向控压篇比较边界条件,数据分析篇解释应力、应变和结构结果。
1. 下载,然后运行#
下载三篇共用的输入、势函数、脚本、真实输出与绘图包。上传到自己的工作目录后:
python3 -m zipfile -e lammps-Ni-tension-wave544-546-078bd09327d9.zip Ni-tension
cd Ni-tension
bash run.sh
run.sh 建立 work/fixed 与 work/transverse,经普通账号 Slurm 提交计算,等待结束,再生成 tables/*.csv 和 figures/*.png。完整对照需要 P100 与 V100 16G 两个分区权限;两张卡分别处理各自的八个小算例。每份分配只用 1 张 GPU、1 个 MPI 进程、1 个 OpenMP 线程,申请 2 个 CPU 核心。同一张卡上的案例按顺序执行,不是八个程序同时抢一张卡。
另一个 V100 16G 作业只对 12 个已保存快照做能量差分,不继续动力学。GPU 计算都经 Slurm;脚本自动排除 TC 分区成员与 V100 32G 节点。登录节点只进行单线程分析和绘图。
作业号保存在 work/SUBMISSIONS.json 和 work/FD-SUBMISSION.json。终端中断不代表已提交作业自动取消;先看这些文件和 squeue。已有 work 时脚本会停止,重新计算请用新解压目录。
2. 模型和时间设置#
| 项目 | 本例设置 |
|---|---|
| 晶体 | FCC Ni,a=3.52 Å,5×5×5 常规胞,共 500 原子 |
| 初始盒长 | x、y、z 均为 17.6 Å,三方向周期 |
| 势函数 | Ni_u3.eam,Foiles 等,Phys. Rev. B 33, 7983 (1986) |
| 温度 | 100 K,温控阻尼 0.1 ps |
| 时间步 | 0.001 ps,即 1 fs |
| 预热 | 1000 步,即 1 ps |
| 拉伸 | 4000 步,即 4 ps,每 200 步保存一帧,共 21 帧 |
| 工程应变率 | 0.005 和 0.015 ps⁻¹,分别为 5×10⁹ 和 1.5×10¹⁰ s⁻¹ |
| 随机种子 | 56001、56002 |
这是一套快速学习操作的小晶体与短时间设置。应变率远高于一般宏观实验;两种速率在相同 4 ps 后分别达到 2% 和 6% 工程应变。比较速率时应在共同应变区间比较,不能把两个不同终点的应力差全归因于速率。
本例最小化只改变原子位置,不优化晶胞;a=3.52 Å 是输入值。因此初始应力不必为零。三方向周期也意味着它不是带自由表面的拉伸试样。
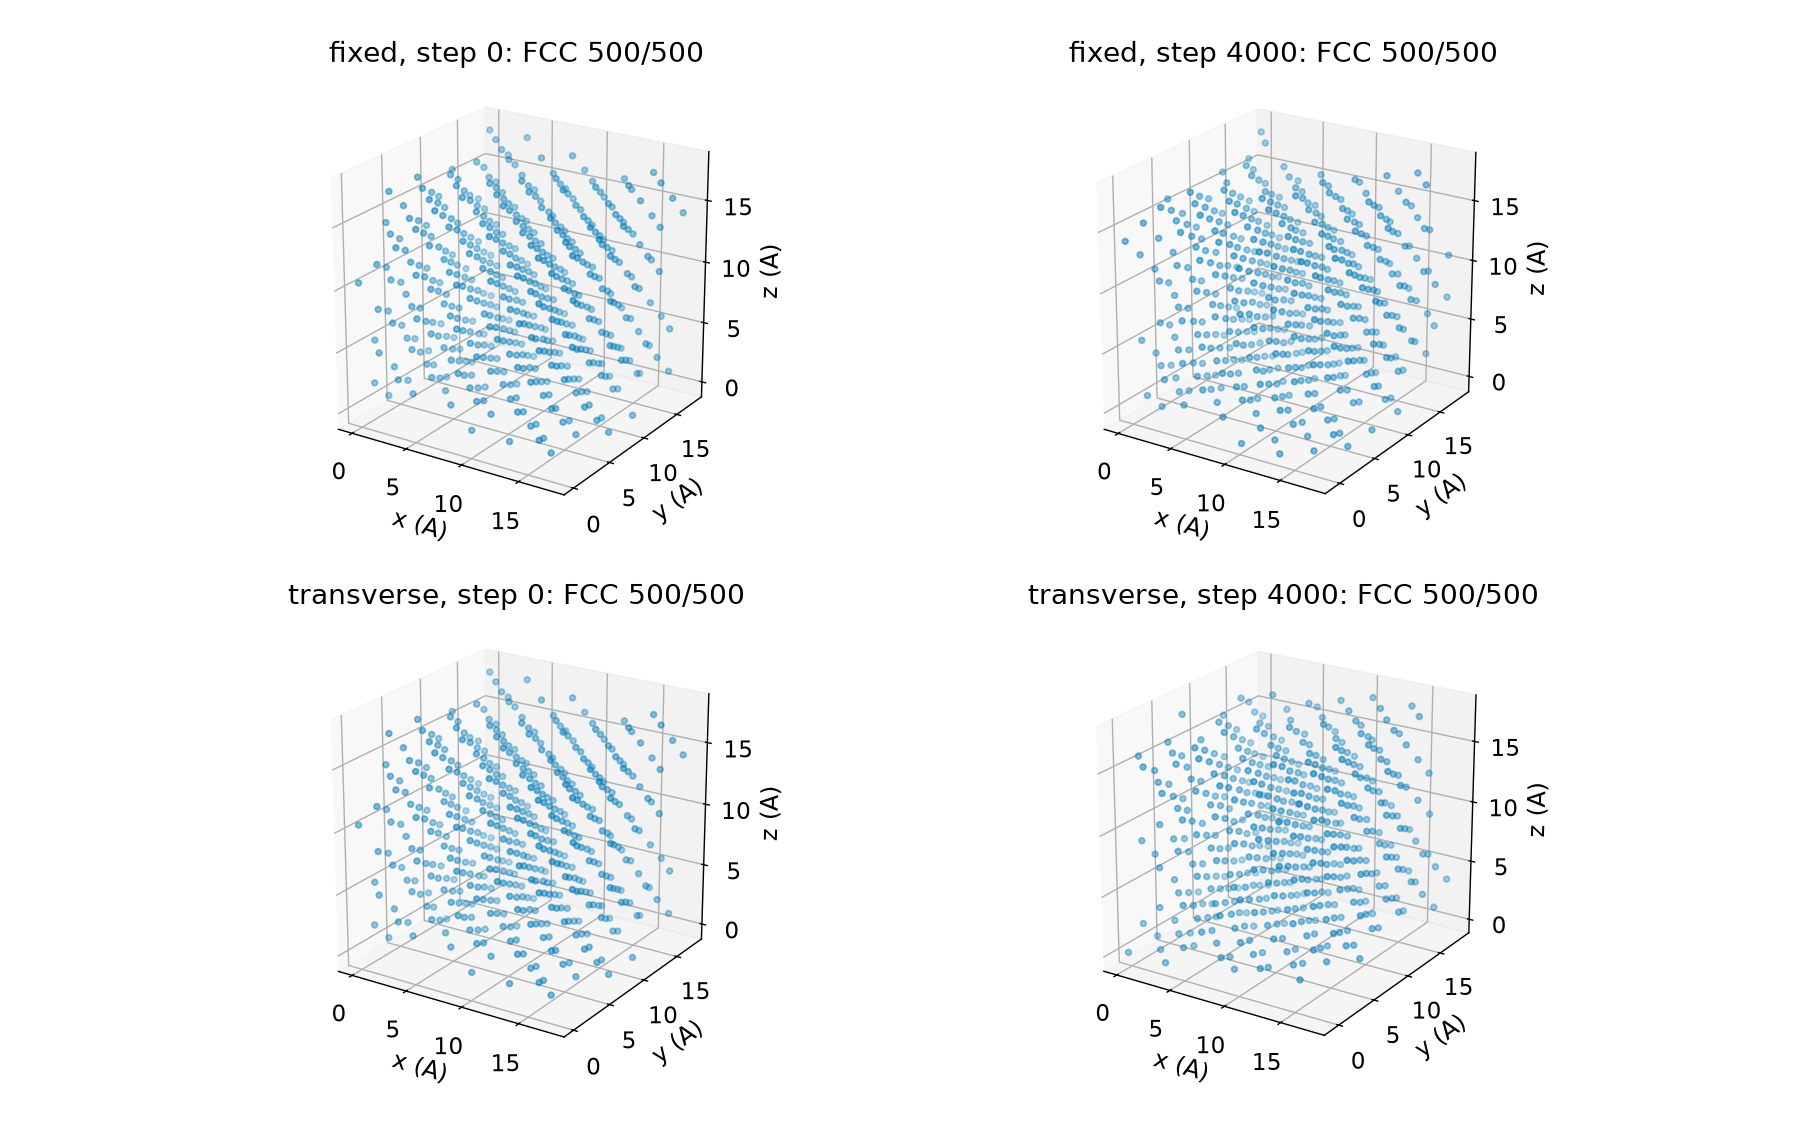
图中蓝色表示 OVITO 自适应 CNA 判定的 FCC 局部环境;本次初末快照均为 500/500 FCC。晶胞变长不等于已经屈服,也不能据此把 6% 时的应力叫作材料极限强度。
3. 看完整 LAMMPS 输入#
cat work/fixed/p100-rate0.005-seed56001/in.lmp
这份实际输入为:
units metal
atom_style atomic
boundary p p p
lattice fcc 3.52
region cell block 0 5 0 5 0 5
create_box 1 cell
create_atoms 1 box
mass 1 58.71
pair_style eam
pair_coeff * * ../Ni_u3.eam
neighbor 2.0 bin
neigh_modify every 1 delay 0 check yes
min_style cg
minimize 0 0.002 2000 20000
velocity all create 100 56001 mom yes rot no dist gaussian
timestep 0.001
fix bath all nvt temp 100 100 0.1
thermo 200
thermo_style custom step atoms temp pe ke etotal
thermo_modify norm no format float %.16g
run 1000
unfix bath
reset_timestep 0
fix bath all nvt temp 100 100 0.1
fix load all deform 0 y erate 0.005 remap x units box
compute full all stress/atom bath_temp
compute conf all stress/atom NULL pair
compute kinetic all ke/atom
variable strain equal ly/17.6-1
thermo_style custom step atoms temp pe ke etotal pxx pyy pzz pxy pxz pyz lx ly lz vol v_strain
thermo_modify norm no format float %.16g
dump tr all custom 200 tension.dump id type x y z vx vy vz fx fy fz c_full[1] c_full[2] c_full[3] c_full[4] c_full[5] c_full[6] c_conf[1] c_conf[2] c_conf[3] c_conf[4] c_conf[5] c_conf[6] c_kinetic
dump_modify tr sort id format float %.16g
print BEGIN_TENSION
run 4000
write_data final.data nocoeff
关键设置:
minimize 0 0.002 ...先做固定晶胞的原子松弛;这里不使用fix box/relax。velocity ... create 100产生初始热速度;先运行 1000 步 NVT 温控预热,再把加载阶段步数归零。fix load all deform 0 y erate 0.005 remap x units box沿 y 施加工程应变。这里的 0 是本版支持的形变更新顺序选择:积分位置后、计算力前更新晶胞;不是“运行零步”,加载仍有 4000 步。使用本例指定的 LAMMPS 30Sep2026 模块。remap x随晶胞重映射坐标,不给存储速度额外叠加仿射流动速度。本例使用普通温度,不再用temp/deform重复扣除并不存在于速度中的流动分量。- 温控器名字叫
nvt,但 y 盒长由外部持续改变,整个加载过程不是平衡态定容系综。x、z 长度固定,横向应力会发展。 thermo_modify norm no保持输出为整个 500 原子体系的总能量;看每原子能量时再除以 500。
4. 先查看结果,再决定下一步#
head -n 4 tables/p100-rate0.005-seed56001.csv
bash analyze.sh work
后一个命令重新分析已完成轨迹,不提交新的动力学。两种 GPU、两种种子、两种速率和两种边界条件共 16 条原生轨迹。本次 P100、seed56001、固定横向尺寸的末帧为:
| 速率 /ps | 工程应变 | 总 Cauchy 应力 σyy /GPa | σxx /GPa | σzz /GPa |
|---|---|---|---|---|
| 0.005 | 0.02 | 3.564659 | 2.066110 | 2.064867 |
| 0.015 | 0.06 | 11.345214 | 6.702386 | 6.682005 |
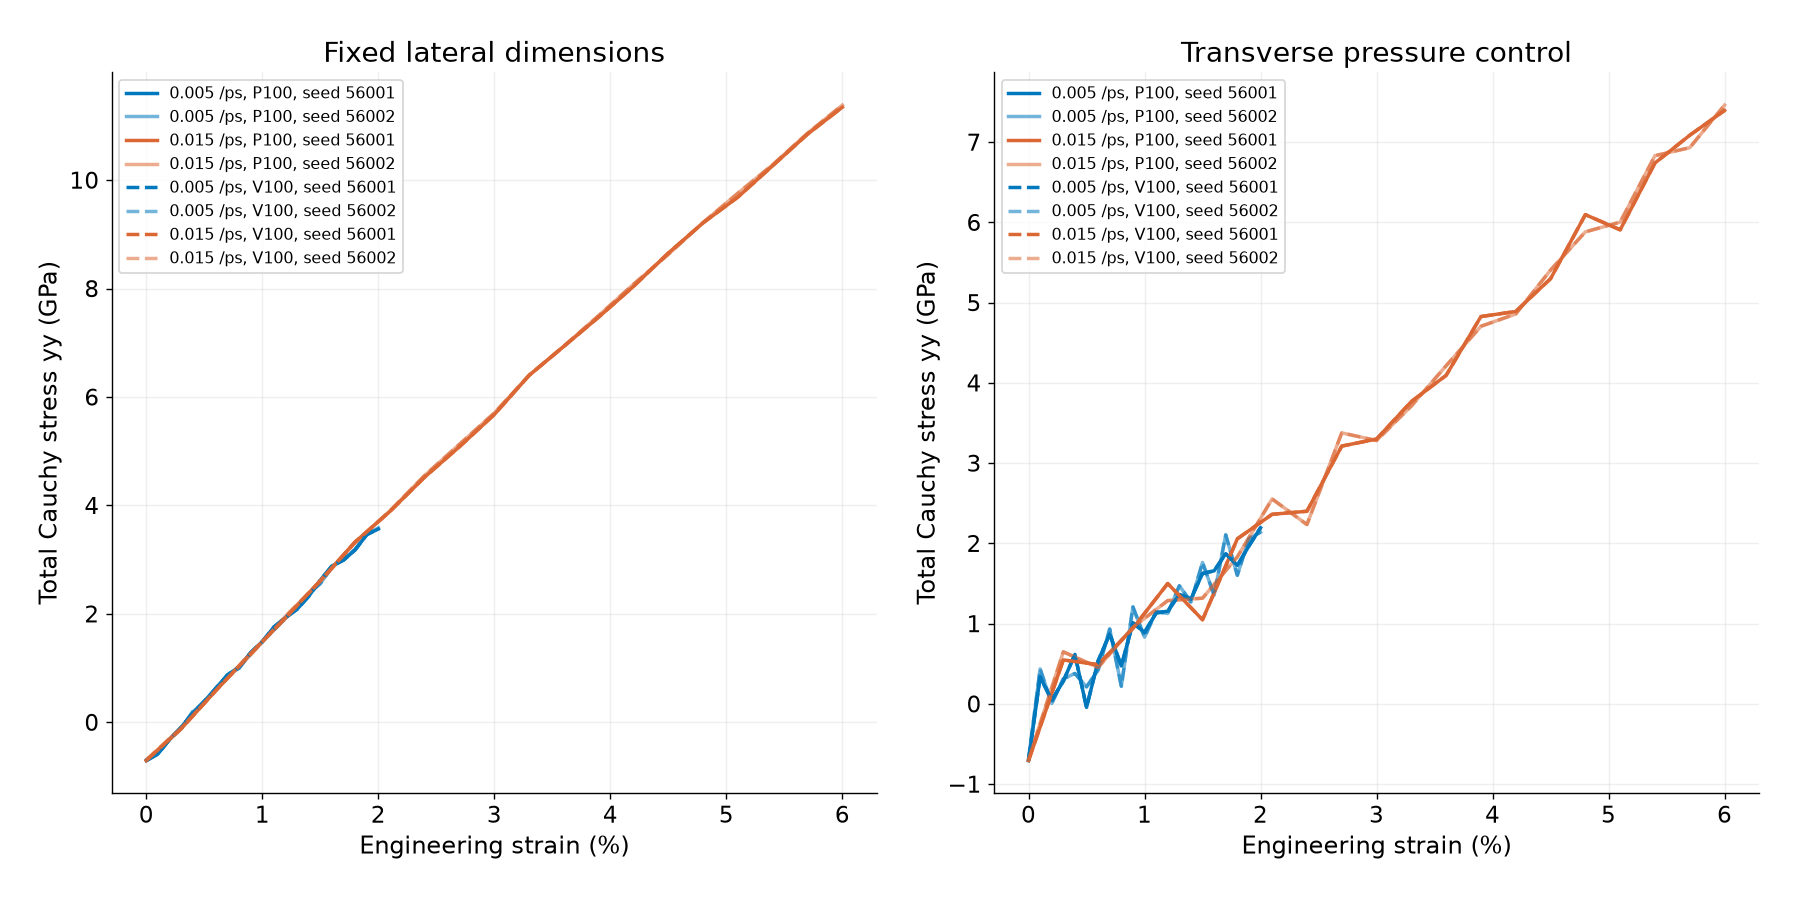
图中实线为 P100、虚线为 V100 16G,浅色为另一个随机种子;部分曲线几乎重叠。线段连接每 0.2 ps 的实际输出点,不是拟合出来的光滑材料本构。
本例使用 LAMMPS 30Sep2026,GCC 13.3、CUDA 12.8、OpenMPI 5.0.10 与 Kokkos 5.2.1;结构分析为 OVITO Python 3.16.1,表格与绘图使用现有 ASE 3.29.0 环境中的 NumPy、Matplotlib。Ni EAM 模型不包含显式电子或磁性自由度。