
LAMMPS 通道流分块统计与续算
从真实400τ与追加1600τ轨迹学习分块比较、延长统计和读取速度剖面,附可直接运行的长算例。
阅读本篇目录
在壁面通道流中,40τ 的短轨迹已能演示外力、横向温控和分层速度,但近壁外推仍有明显波动。本篇继续同一个 384 粒子的二维 LJ 模型,说明如何延长计算、比较统计窗口,以及何时应继续采样。
全部输入、轨迹和图表来自鸢算科技集群实际运行。下载较长轨迹、续算输入、分析与绘图包。
1. 先用配套数据学会读结果#
上传资料包后:
python3 -m zipfile -e lammps-channel-statistics-wave550-552-c094da9b4412.zip channel-statistics
cd channel-statistics
bash analyze.sh
这一条只分析 reference/ 中提供的真实轨迹,不提交新作业。它会输出八个条件的 CSV、两张 PNG,并保留先前较短统计中不稳定的分块结果。
cat tables/selected-statistics.csv
两种壁面相互作用 ε=0.25/1.0、两种种子 58001/58002、P100/V100 16G,共 8 个条件;外力统一为 0.04。每个条件仍有 288 个移动粒子、96 个固定壁面、dt=0.002、目标 Ty=1。坐标、温控定义和壁面参考面与前两篇相同。
2. 400τ 与追加1600τ分别是什么#
先读取前篇短程计算末态的 final.data,保留原子位置和速度,再运行 200000 步=400τ。这八个条件每 1000 步保存一次,共 201 帧。
本次先比较最后 100 个保存样本,分为两个各 50 帧的块:
| 阶段 | 第一块步数 | 第二块步数 | 输出间隔 |
|---|---|---|---|
| 400τ | 101000–150000 | 151000–200000 | 1000 步=2τ |
| 追加1600τ | 404000–600000 | 604000–800000 | 4000 步=8τ |
400τ 阶段的每块样本首末跨度为 98τ;追加阶段为 392τ。这里比较的是保存样本的均值,不把样本首末跨度和完整连续积分区间混称。
八个条件中,六个在 400τ 阶段达到本例预先设置的比较标准;另外两个条件继续读取各自 400τ 末态,追加 800000 步=1600τ。原来的结果也保留在包内,不用更长阶段覆盖它。
每个长阶段都使用明确的新 Langevin 随机流。read_data 保留该检查点的坐标、速度和盒子,不等于恢复原随机数发生器的每一位状态,也不是重新从理想晶格创建速度。
3. 怎样比较两个块#
脚本对每个块分别计算:
- 移动粒子整体平均 vx。
- 以粒子占据数加权的 y 分层速度剖面。
- 内部层的加权二次拟合、上下壁内法向导数与带符号表观外推长度。
本例使用以下比较标准:
| 比较量 | 本例标准 |
|---|---|
| 平均流速相对变化 | 不超过 20% |
| 上、下壁内法向导数的相对变化 | 各不超过 30% |
| 上、下壁表观长度的绝对变化 | 各不超过 2σ |
相对变化用 abs(块1-块2)/max(abs(块2),1e-12);靠近零的量会使相对变化敏感,所以表观长度使用绝对变化。这些是教学示例预先选定的比较标准,不是所有通道模型通用的收敛要求。
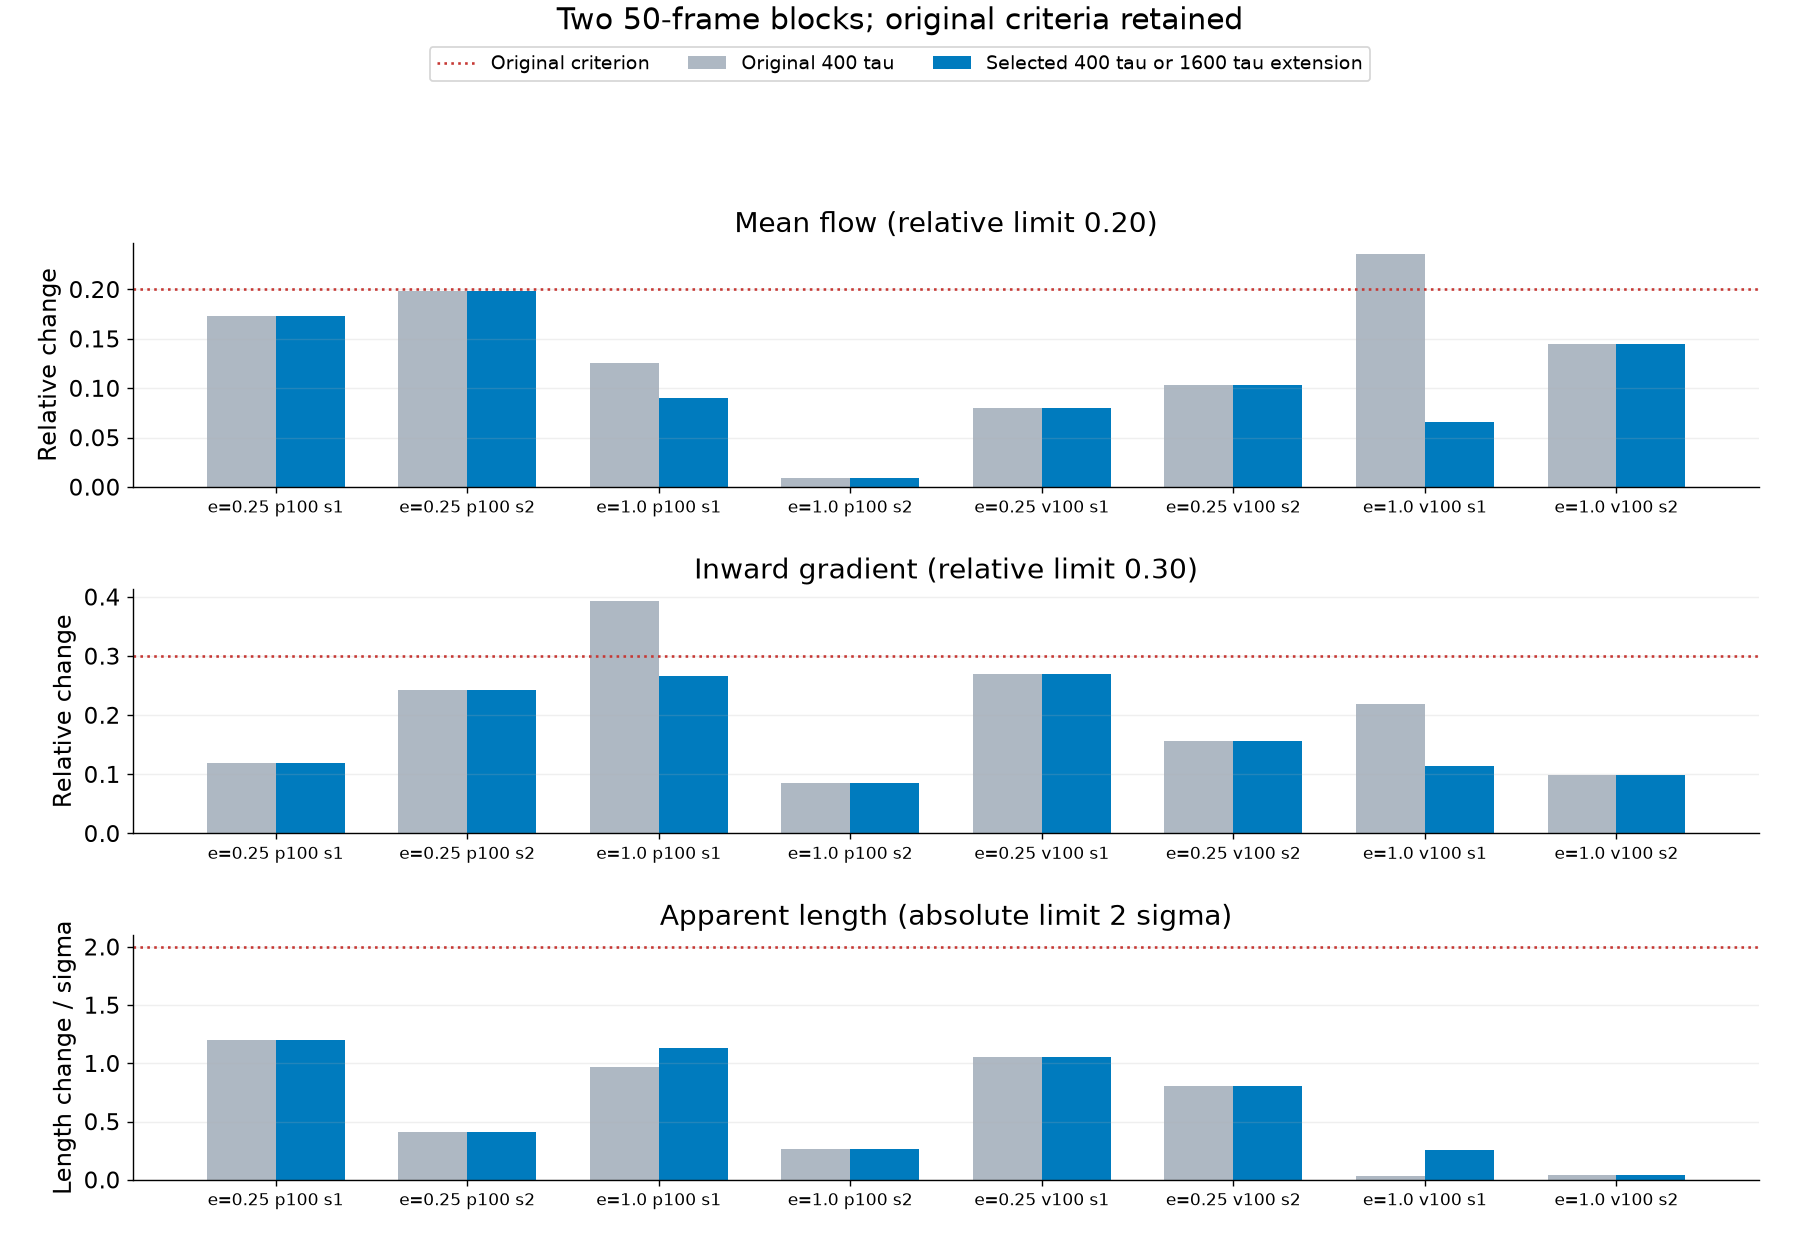
灰色为原 400τ,蓝色为最终采用的阶段,点线保持同一个比较标准。ε=1、seed58001 的两个实际例子为:
| 后端与阶段 | 流速相对变化 | 最大近壁梯度相对变化 | 最大表观长度差 /σ |
|---|---|---|---|
| P100,400τ | 0.125618 | 0.393944 | 0.966053 |
| P100,追加1600τ | 0.090543 | 0.266444 | 1.136015 |
| V100 16G,400τ | 0.235734 | 0.219783 | 0.036548 |
| V100 16G,追加1600τ | 0.065620 | 0.114026 | 0.252618 |
P100 原先主要是梯度变化较大,V100 原先主要是均流变化较大;延长后两者满足本例三个比较标准。不是每一列都会随时长增加而单调变小,不能只挑最好看的一个数。
head -n 6 tables/p100-wall1.0-force0.04-seed58001-profile.csv
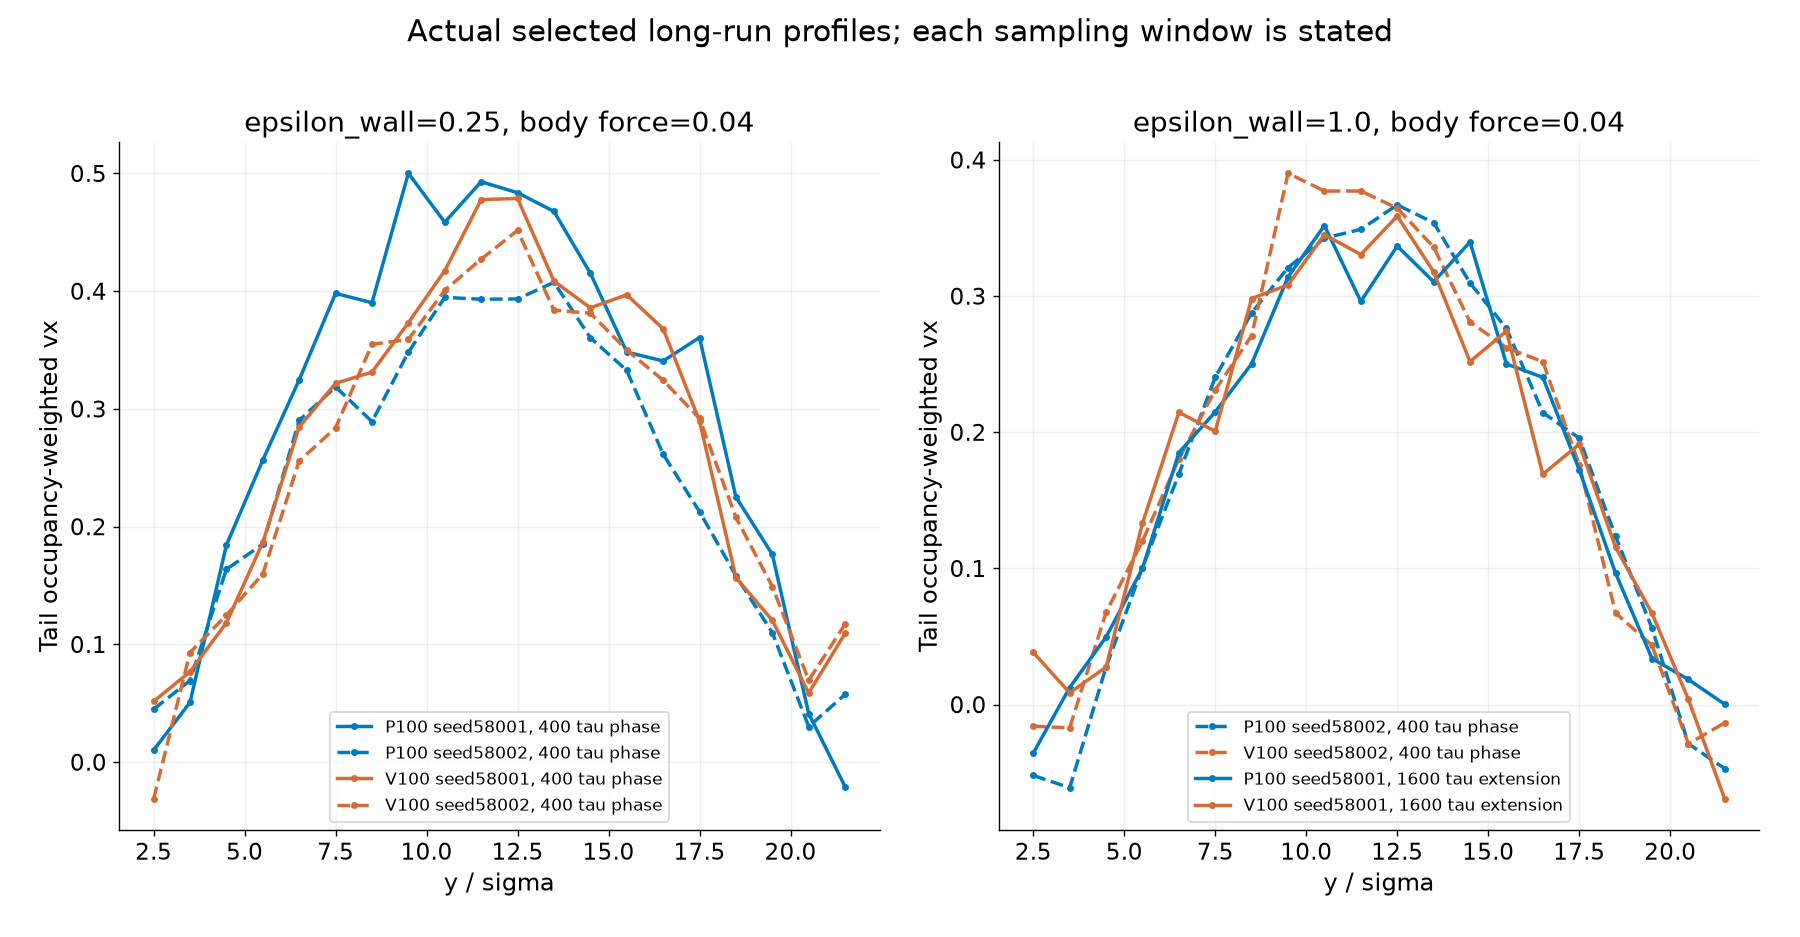
图例明确标注 400τ 阶段或追加 1600τ 阶段。曲线仍会有近壁振荡与种子差异;固定原子壁面的微观层化不是光滑连续介质边界。较稳定的剖面也不能自动证明尺寸、驱动力、液相状态或真实三维黏度收敛。
4. 自己运行一对400τ示范#
bash run-long.sh
这会在 new-work/ 中,从相同的配套短程末态建立两个新计算:壁面 ε=0.25、外力 0.04、seed58002,分别用 P100 与 V100 16G。每个任务 1 张 GPU、2 个申请的 CPU 核心、1 MPI、1 OpenMP 线程,经普通账号 Slurm 提交;自动排除 TC 分区成员及 V100 32G。
脚本等待完成,再输出新的物理数据和分块报告。新随机轨迹无需逐帧等于参考轨迹,新的分块比较也可能仍提示需要更多采样。不要为了“通过”而随意放宽比较标准。
head -n 20 new-work/STATISTICAL-VALIDATION.json
原始八个条件的数据始终在 reference/,新算例在 new-work/,互不覆盖。中断后先检查 new-work/SUBMISSIONS.json 和 squeue;再次完整运行需用新解压目录,避免重复作业。
5. 查看完整续算输入#
cat new-work/p100-wall0.25-force0.04-seed58002/in.lmp
本例的 400τ 输入为:
units lj
dimension 2
atom_style atomic
boundary p f p
read_data ../sources/p100-wall0.25-force0.04-seed58002/source.data
group wall type 2
group fluid type 1
pair_style lj/cut 2.5
pair_coeff 1 1 1.0 1.0 2.5
pair_coeff 2 2 1.0 1.0 2.5
pair_coeff 1 2 0.25 1.0 2.5
pair_modify shift yes
neighbor 0.3 bin
neigh_modify every 1 delay 0 check yes
velocity wall set 0 0 0
fix raw all store/force
fix hold wall setforce 0 0 0
compute Ty fluid temp/partial 0 1 0
compute_modify Ty extra/dof 0
fix integrate fluid nve
fix bath fluid langevin 1.0 1.0 1.0 58302 zero yes
fix_modify bath temp Ty
fix planar all enforce2d
timestep 0.002
thermo 1000
thermo_style custom step atoms c_Ty pe ke etotal
thermo_modify norm no format float %.16g
unfix planar
reset_timestep 0
fix drive fluid addforce 0.04 0 0
fix planar all enforce2d
compute atomE all pe/atom
compute meanv fluid reduce ave vx
variable Nf equal count(fluid)
variable Nw equal count(wall)
compute bins fluid chunk/atom bin/1d y lower 1.0 units box
fix profile fluid ave/chunk 1000 1 1000 bins vx norm sample ave one file flow.profile format " %.16g"
thermo_style custom step atoms c_Ty pe ke etotal c_meanv v_Nf v_Nw lx ly lz
thermo_modify norm no format float %.16g
dump tr all custom 1000 flow.dump id type x y z vx vy vz fx fy fz f_raw[1] f_raw[2] f_raw[3] c_atomE
dump_modify tr sort id format float %.16g
print BEGIN_CHANNEL_FLOW
run 200000
write_data final.data nocoeff
重点是 read_data ../sources/案例/source.data;其中已经有质量、盒子、原子和速度,不再调用 create_atoms 或 velocity create。仍需重新定义势、组、温控、积分器、外力和输出。reset_timestep 0 只把本阶段计数归零,不改变检查点几何。
对应的 P100 提交脚本为:
#!/bin/bash
#SBATCH --job-name=channel400tau-p100
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=2
#SBATCH --gres=gpu:p100-16g:1
#SBATCH --mem=4G
#SBATCH --time=00:30:00
set -e
source /etc/profile
set -u
module purge
module load lammps/30Sep2026-p100-kokkos
export OMP_NUM_THREADS=1 MKL_NUM_THREADS=1 OPENBLAS_NUM_THREADS=1 OMP_PROC_BIND=false
ulimit -s unlimited
/public/toolkit/miniconda3/envs/ase-3.29.0/bin/python -B "$SLURM_SUBMIT_DIR/new-work/worker.py" p100-wall0.25-force0.04-seed58002
两种后端均为 LAMMPS 30Sep2026,GCC 13.3、CUDA 12.8、OpenMPI 5.0.10、Kokkos 5.2.1。分析使用既有 ASE 3.29.0 环境的 NumPy、Matplotlib。继续使用 temp/partial 0 1 0 和明确的 extra/dof 0,避免把 x 流动动能当作横向热运动温控。
6. 数据在哪里#
| 路径 | 内容 |
|---|---|
reference/phase400/ |
原八个 400τ 条件的完整轨迹、原生输出与两块统计 |
reference/phase1600/ |
两个追加阶段的完整轨迹和统计 |
SELECTION.json |
每个条件采用哪个阶段,保留选择规则 |
tables/selected-statistics.csv |
八个条件的平均流速与分块变化 |
tables/*-profile.csv |
实际采用的加权速度剖面 |
new-work/ |
使用 run-long.sh 后产生的新原生计算 |
figures/ |
两张实际数据图 |
bash plot.sh
这只重画随包提供的参考数据。下一步若要研究具体材料,应再检查通道宽度、相互作用模型、驱动力的线性响应、足够长的相关时间,以及壁面参考面定义;带符号的表观长度仍不能直接替代真实流体的材料滑移参数。