
DeePMD驱动LAMMPS、ASE和GPUMD
一条短命令通过Slurm运行同一H2势模型的三种原生动力学程序,并读取轨迹与能量力结果。
阅读本篇目录
先按输入与单位篇解压实例包,之后始终在同一个 H2-MD 目录操作。
1 确认目录#
pwd
目录中应有 run.sh、models/、reference/ 和 gpumd-source/。参考轨迹与新计算分别保存,方便对照。
2 提交六个短程任务#
bash run.sh
默认申请P100分区1GPU、2个CPU核额度,在同一个Slurm作业内依次运行LAMMPS、ASE和GPUMD的两种步长,共六次真实MD。V10016G用户可使用 bash run.sh v100。程序先在自己的工作目录编译GPUMD的DeePMD可选接口,再执行计算和独立模型预测,最后输出结果表;不在登录节点运行MD。
公共GPUMD模块未启用DeePMD接口。 本例带有匹配5.9.1的源文件和原始许可证,作业内使用GCC13.3、CUDA12.9、C++17及 USE_DEEPMD,链接现有DeePMD3.2.0 C++库,生成个人目录专用程序。这份程序仅启用DP,不包含公共GPUMD中的PLUMED或NetCDF功能;需要那些功能时继续选用相应公共模块。
加载的源编译环境为 lammps/22Jul2025_update6-deepmd-3.2.0-source-p100-gpu 或V100对应模块,包含OpenMPI5.0.10rc2与DeePMD3.2.0;Python后端为PyTorch2.12.0,ASE3.29.0,NumPy与Matplotlib用于整理数据和绘图。三套程序读取同一硬件对应的冻结模型;本例不重新训练势模型。
cat new-work/SUBMISSIONS.json
提交号保存在这个文件中。脚本会等待已有作业完成,排队时不要反复运行。需重算时另建一个解压目录,保留原轨迹。作业日志是 new-work/native-作业号.out,各程序完整输出在相应子目录的 native.out。
head -n 8 tables-new/your-native-MD-results.csv
完成后得到六行新结果,包含步长、实际帧数、键长范围、总能变化以及与模型原生接口的能量/力差异。不是只对参考数据重新画图。
3 作业内执行什么#
LAMMPS使用单MPI进程:mpirun -np 1 --bind-to none lmp -in in.lmp。ASE由 code/ase_md.py 中的 VelocityVerlet 直接驱动,核心操作如下:
atoms.set_velocities(v_Aps / (1000 * units.fs))
atoms.calc = DP(model=model_path)
dynamics = VelocityVerlet(atoms, dt_fs * units.fs)
dynamics.run(number_of_steps)
GPUMD直接运行工作目录内编译的程序,读取 model.xyz、dp.txt 与 run.in。这些命令在脚本申请到的GPU作业内执行,日常操作使用上面的短命令即可。
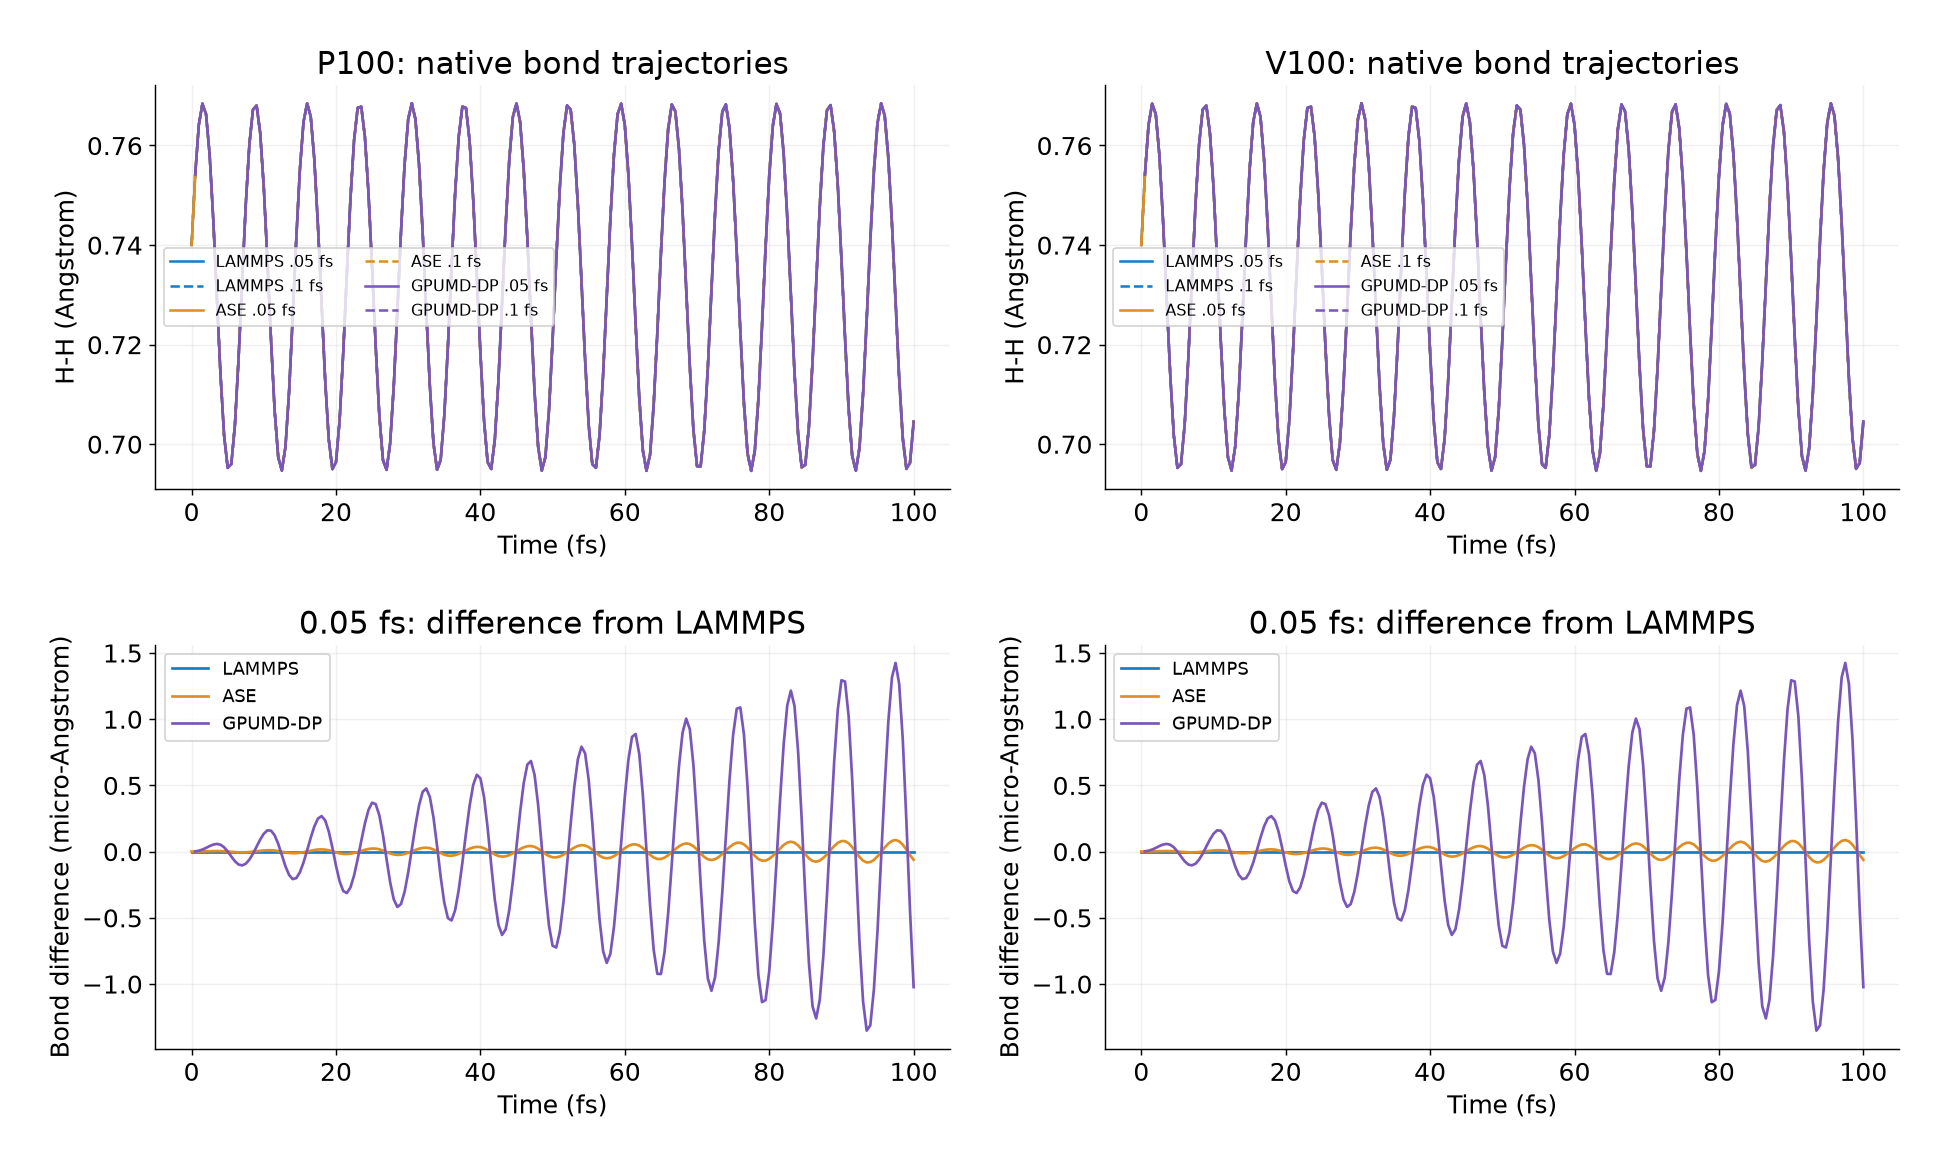
三套程序给出几乎重合的键长轨迹。下面将0.05 fs轨迹相对LAMMPS的差异放大到微Å量级;GPUMD、ASE与LAMMPS内部单位常数的精度略有差异,因此不要求逐位相同。
4 独立核对能量与力#
脚本把每个实际保存结构重新送入DeePMD原生 DeepPot.eval,比较返回的能量与力。两套模型分别在自己的P100/V100轨迹上核对,避免把不同权重的差异误认为接口差异。
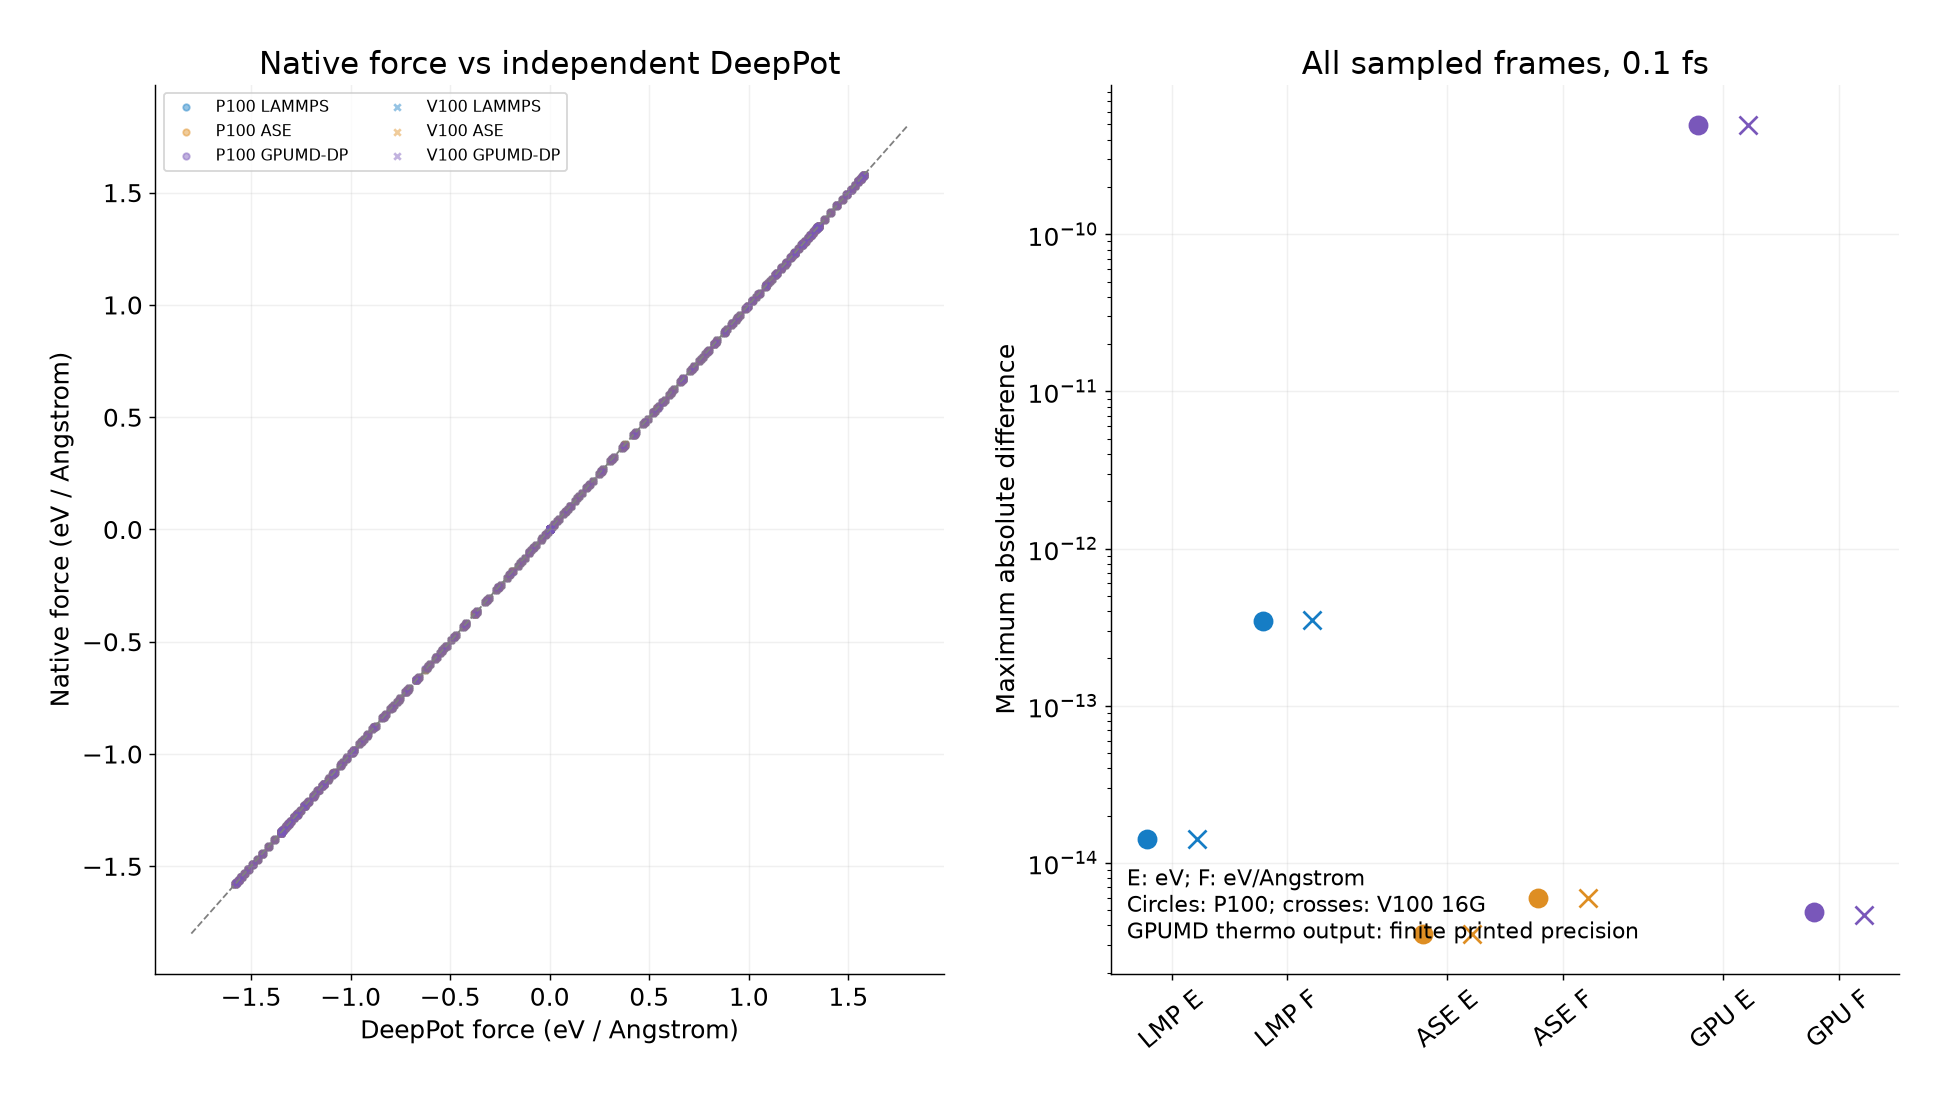
LAMMPS/ASE能量差约10⁻¹⁴ eV,GPUMD约5×10⁻¹⁰ eV,后者主要受 thermo.out 打印位数限制;力差分别在10⁻¹³和10⁻¹⁵ eV/Å量级。它们反映接口数值一致性,不等于势模型相对量化计算的误差。模型精度仍需独立量化测试。接口用法参阅DeePMD的ASE文档,继续检查时间步长与能量。