
DeePMD多输出性质与结果分析
读取原生property测试文件,比较直接拟合轨道能差和两个能级之差,核对标量不变性与CPU/GPU一致性。
阅读本篇目录
完成通用性质训练后,检查每个输出及其物理含义。全部参考数据与作图程序见实例包。
1 画出实际结果#
bash plot.sh
六张参考图写入 figures/,覆盖真实结构与量化标签、数组形状、训练曲线、独立预测、单/双输出比较和数值不变性。
head -n 10 tables/property-results.csv
这是提供的原始参考训练表;自己新训练的结果在 tables-new/property-results.csv。
2 读取原生逐帧结果#
cat new-work/p100-edges/heldout.property.out.0
本版本原生命令为每个测试帧写一个文件,从 .out.0 到 .out.11。双输出文件有两行,依次HOMO和LUMO;两列依次为真实标签、模型预测。单输出对应目录为 new-work/p100-gap/,每帧文件只有一行。选择V100时目录前缀改为 v100-。
同一原始结构的三个刚体姿态共用相同标量标签,这12帧来自4个原始测试几何;不要把姿态数量当成独立样本数。脚本另外读取冻结模型的原生API核对测试RMSE,与CLI逐帧输出相互对照。
cat new-work/SUBMISSIONS.json
通过此作业号和 new-work/native-作业号.out 可定位自己的本轮运行。原生训练日志、冻结日志与测试日志保存在各模型目录。
3 直接拟合能差,还是先拟合两个能级#
一个模型直接学习 εL−εH;另一个同时学习[εH, εL],推断后再计算两者差。两种目标相互关联,拟合后的预测不要求完全相同。
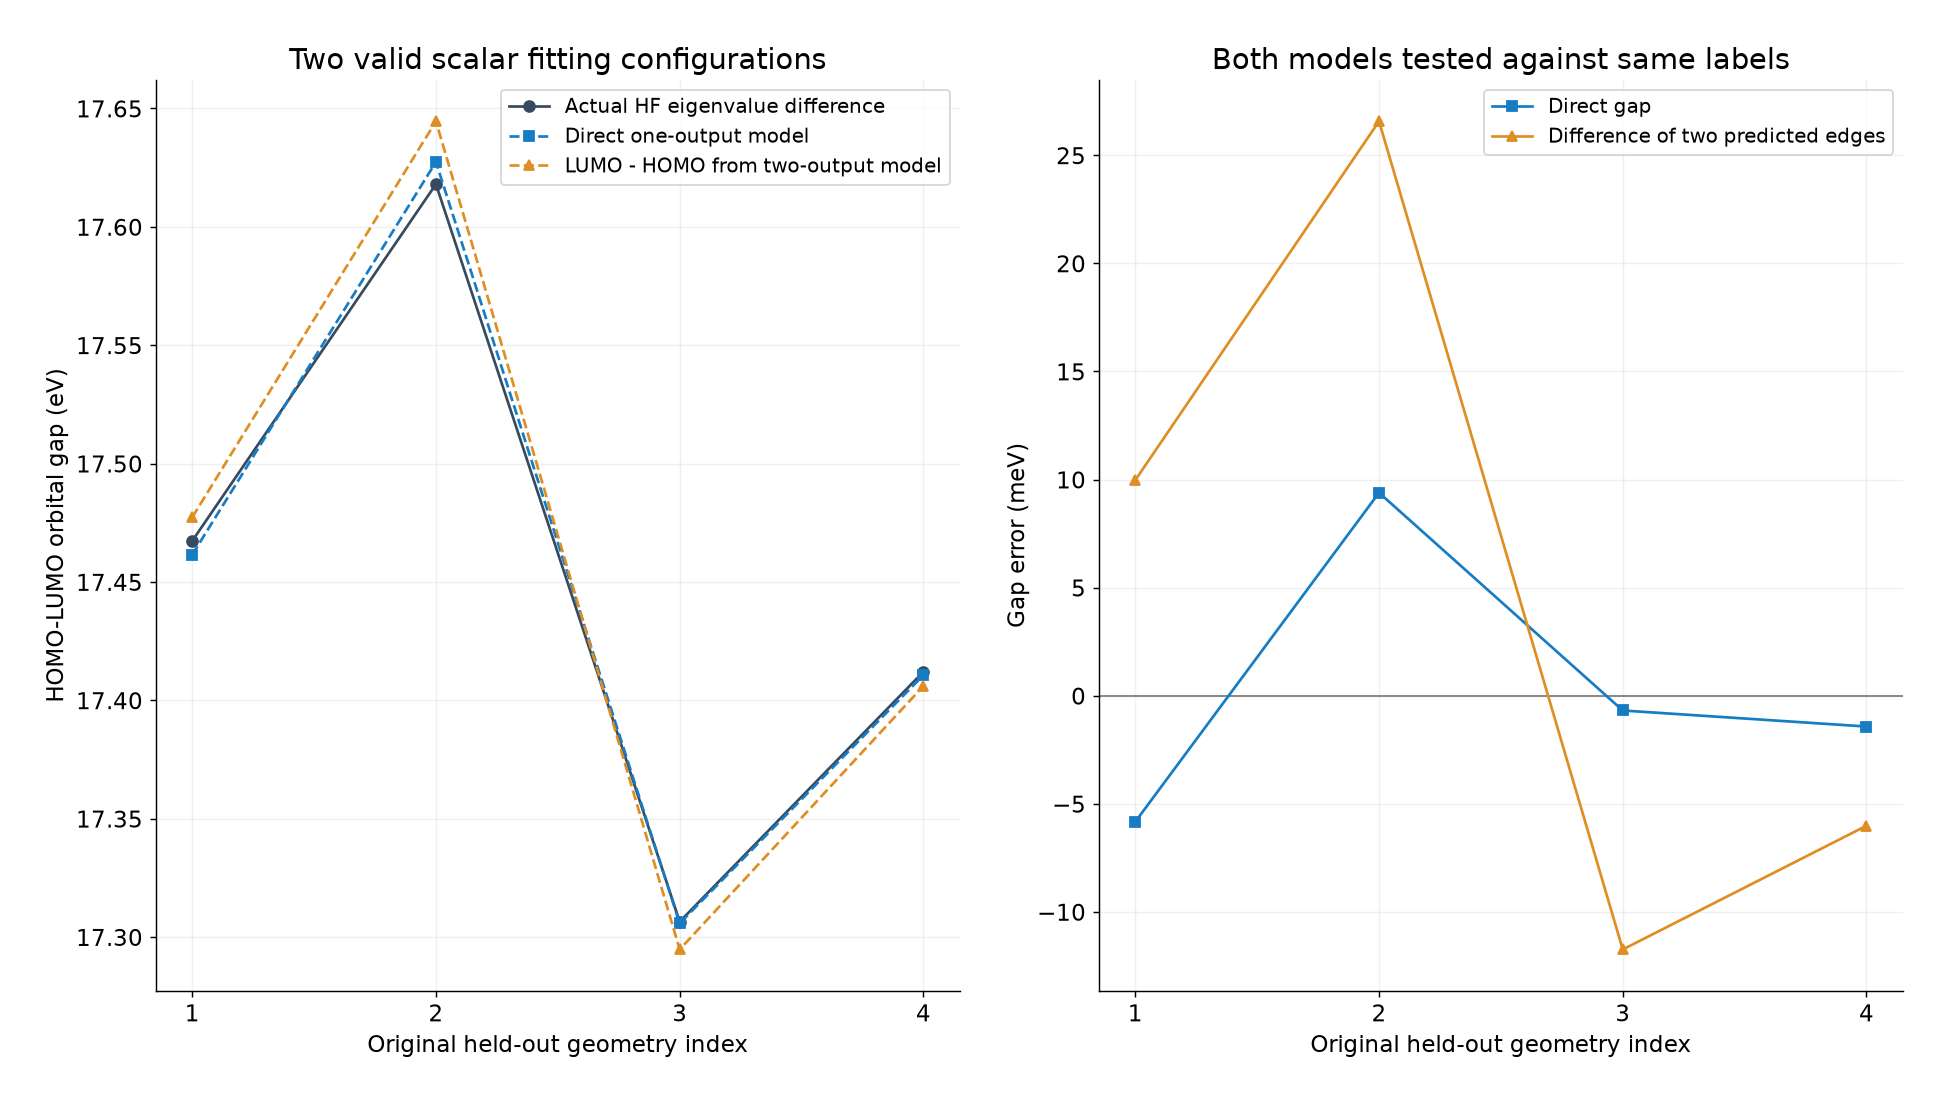
本例四个原始测试结构中,直接拟合轨道能差的最大误差约9.39 meV;分别拟合两个能级再相减,误差还受两个输出误差相关性的影响。哪种方式更适合,应结合实际目标、输出数量、数据范围和独立测试结果选择,不能从这个小例子推出普遍优劣。
4 用原生API读取#
作业内的 api_worker.py 使用:
from deepmd.infer.deep_property import DeepProperty
model = DeepProperty("frozen_model.pth")
global_property, atomic_latent = model.eval(
    coordinates, None, [0, 1, 1, 1], atomic=True
)
coordinates 每帧12个坐标分量,None 表示本例非周期模型。单输出 global_property 为(帧数,1),双输出为(帧数,2);atomic_latent 为(帧数,4,输出数)。本例 intensive=true,对中间项在原子维取平均应回到全局预测。这里返回中间项只是核对模型归约,不把它解释为原子轨道能级。
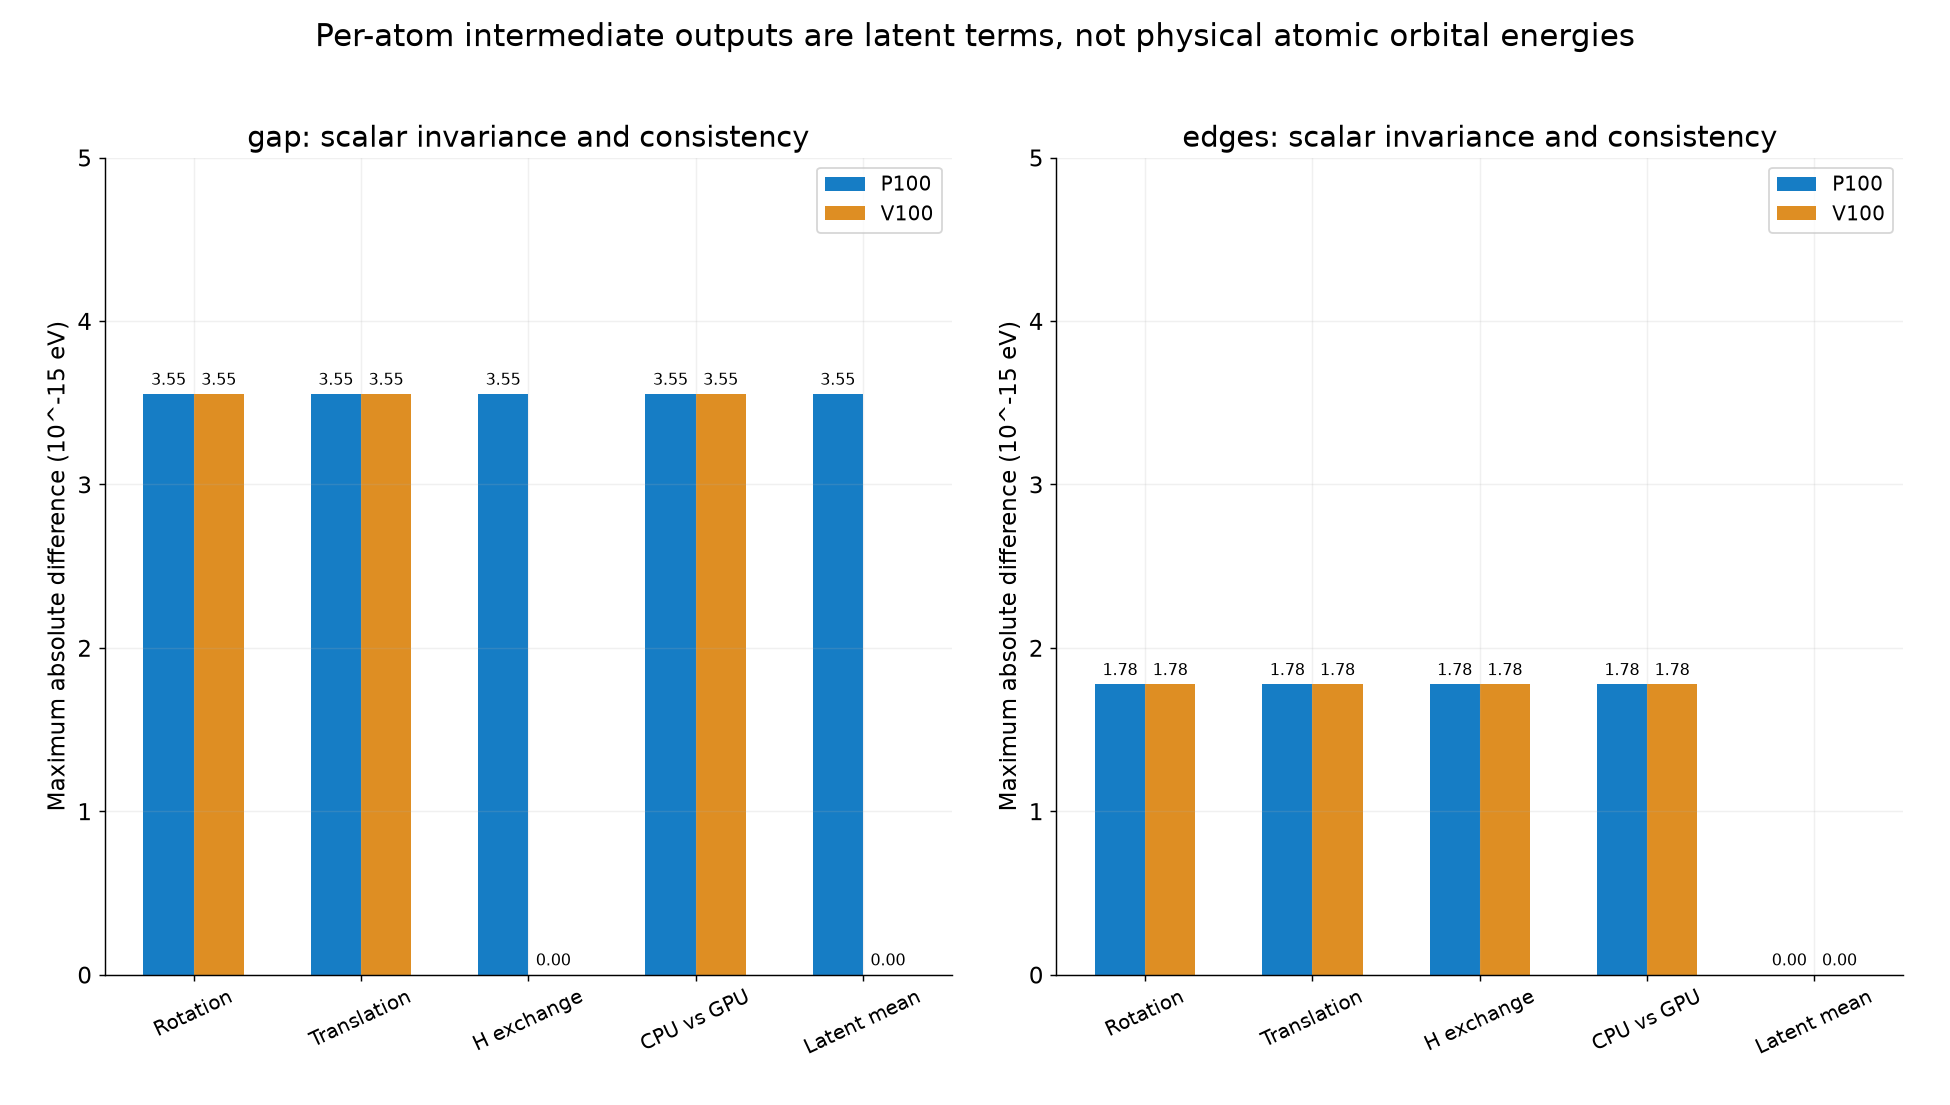
对同一冻结权重,旋转、平移、等价H原子交换和GPU/CPU推断的最大差异处于约10⁻¹⁵ eV数值精度量级;图中零值仍按零显示。它验证当前标量接口的数值性质,不等同于模型的量化预测精度。
5 用于自己的标量性质#
先明确目标是整个体系的标量还是随原子数求和的量,再统一标签方法、单位、列顺序与数据文件名。按原始结构划分训练、验证、测试,再做姿态扩增;保留独立量化测试。
当前示例是NH₃小范围几何的HF轨道性质拟合,不输出能量/原子力,也不是用于LAMMPS或GPUMD的MD势。它没有证明化学反应、其他元素、更大分子或其他电子态的可迁移性;光学激发能等性质需要合适的电子结构方法与相应真实标签。参数说明见官方通用性质拟合文档。