
DeePMD闭壳层电子布居训练
用短命令提交原生population训练,说明RHF对称起点、完整输入和学习曲线的含义。
阅读本篇目录
完成标签篇的解压后,在同一个 NH3-population 目录操作。完整实例包中已有数据和起始模型。
1 整理参考结果#
bash analyze.sh
生成 labels-rebuilt/ 与 tables/population-results.csv。表中包含P100、V10016G各自模型在GPU和CPU上的原生输出比较。
2 提交自己的训练#
bash run.sh
默认申请核时P100分区1GPU、2个CPU核额度,在Slurm作业内从提供的RHF对称起点执行额外3000步原生训练,冻结模型,再读取逐原子布居并与真实标签比较。V10016G用户可用 bash run.sh v100。
起始权重已有训练基础,这3000步是新的微调,不是从随机参数开始。 使用原生 --init-model 读取权重,重新建立优化器并将本轮步数从0计数;不要把它改成继续累计旧步数的 --restart。本例新学习曲线的1–3000是额外优化步数。
head -n 6 tables-new/population-results.csv
新结果在 tables-new/,训练、冻结及推断文件在 new-work/,与原始参考数据分开。脚本会等待当前作业完成;排队时不要重复运行,重算请另建解压目录。
cat new-work/SUBMISSIONS.json
这个文件保存本轮Slurm作业号,日志为 new-work/native-作业号.out。CPU推断也在该GPU作业分配的计算节点内运行并隐藏CUDA设备,仅作数值对照,不代表CPU节点性能。
3 为什么使用RHF对称起点#
本例的量化标签明确满足nα=nβ。初始化时,将原模型每个布居输出头的两列权重与两个偏置分别取平均,让两通道从相同状态开始;这只处理起始模型参数,没有在推断后改写结果。
该操作保持当时的逐原子总布居不变,并使闭壳层两通道一致。后续使用相同的α/β标签和对称的原生损失训练,保持本例的闭壳层条件。数据中的Mulliken电荷和坐标没有改动。
包内已提供相应起点,普通使用只需上面的短命令。这个起点专用于当前闭壳层RHF例子,不能将两通道相等的条件直接用于开壳层或磁性体系。 它也不会自动让分子总电子数精确等于10,应用时仍要检查电子数与总电荷。
4 完整训练输入#
{
  "model": {
    "type_map": [
      "N",
      "H"
    ],
    "descriptor": {
      "type": "se_e2_a",
      "sel": [
        4,
        8
      ],
      "rcut": 3.0,
      "rcut_smth": 2.5,
      "neuron": [
        8,
        16
      ],
      "axis_neuron": 4,
      "precision": "float64",
      "seed": 584001
    },
    "fitting_net": {
      "type": "population",
      "neuron": [
        16,
        16
      ],
      "precision": "float64",
      "seed": 584002
    }
  },
  "learning_rate": {
    "type": "exp",
    "start_lr": 0.0003,
    "stop_lr": 1e-06,
    "decay_steps": 300
  },
  "loss": {
    "type": "population",
    "loss_func": "smooth_mae"
  },
  "training": {
    "training_data": {
      "systems": [
        "../data/train"
      ],
      "batch_size": 4
    },
    "validation_data": {
      "systems": [
        "../data/validation"
      ],
      "batch_size": 4,
      "numb_btch": 3
    },
    "numb_steps": 3000,
    "seed": 584003,
    "disp_file": "lcurve.out",
    "disp_freq": 100,
    "save_freq": 1000,
    "save_ckpt": "model"
  }
}
拟合类型与损失均为 population,标签文件是 atomic_population.npy,而不是分子级的两个属性。使用 se_e2_a、3 Å截止、双精度、[8,16]嵌入网络和[16,16]拟合网络,批量4帧。
loss_func=smooth_mae 同时关注逐原子布居、α−β布居差、分子总自旋布居,以及α和β电子总数。相关原生权重包括 start_pref_pop、start_pref_spin、start_pref_spin_total、start_pref_pop_alpha_total 和 start_pref_pop_beta_total,以及相应 limit_pref_...;当前配置使用这些项的默认权重1。
作业内执行 dp --pt train input.json --init-model ../initializers/p100.pt,之后 dp --pt freeze -c model.pt -o frozen_model.pth。V100目录使用对应的起始文件。当前版本的 dp test 没有这类模型的测试器,资料包直接用原生 DeepPopulation 读取并比较实际输出,不需要制造能量/力标签。
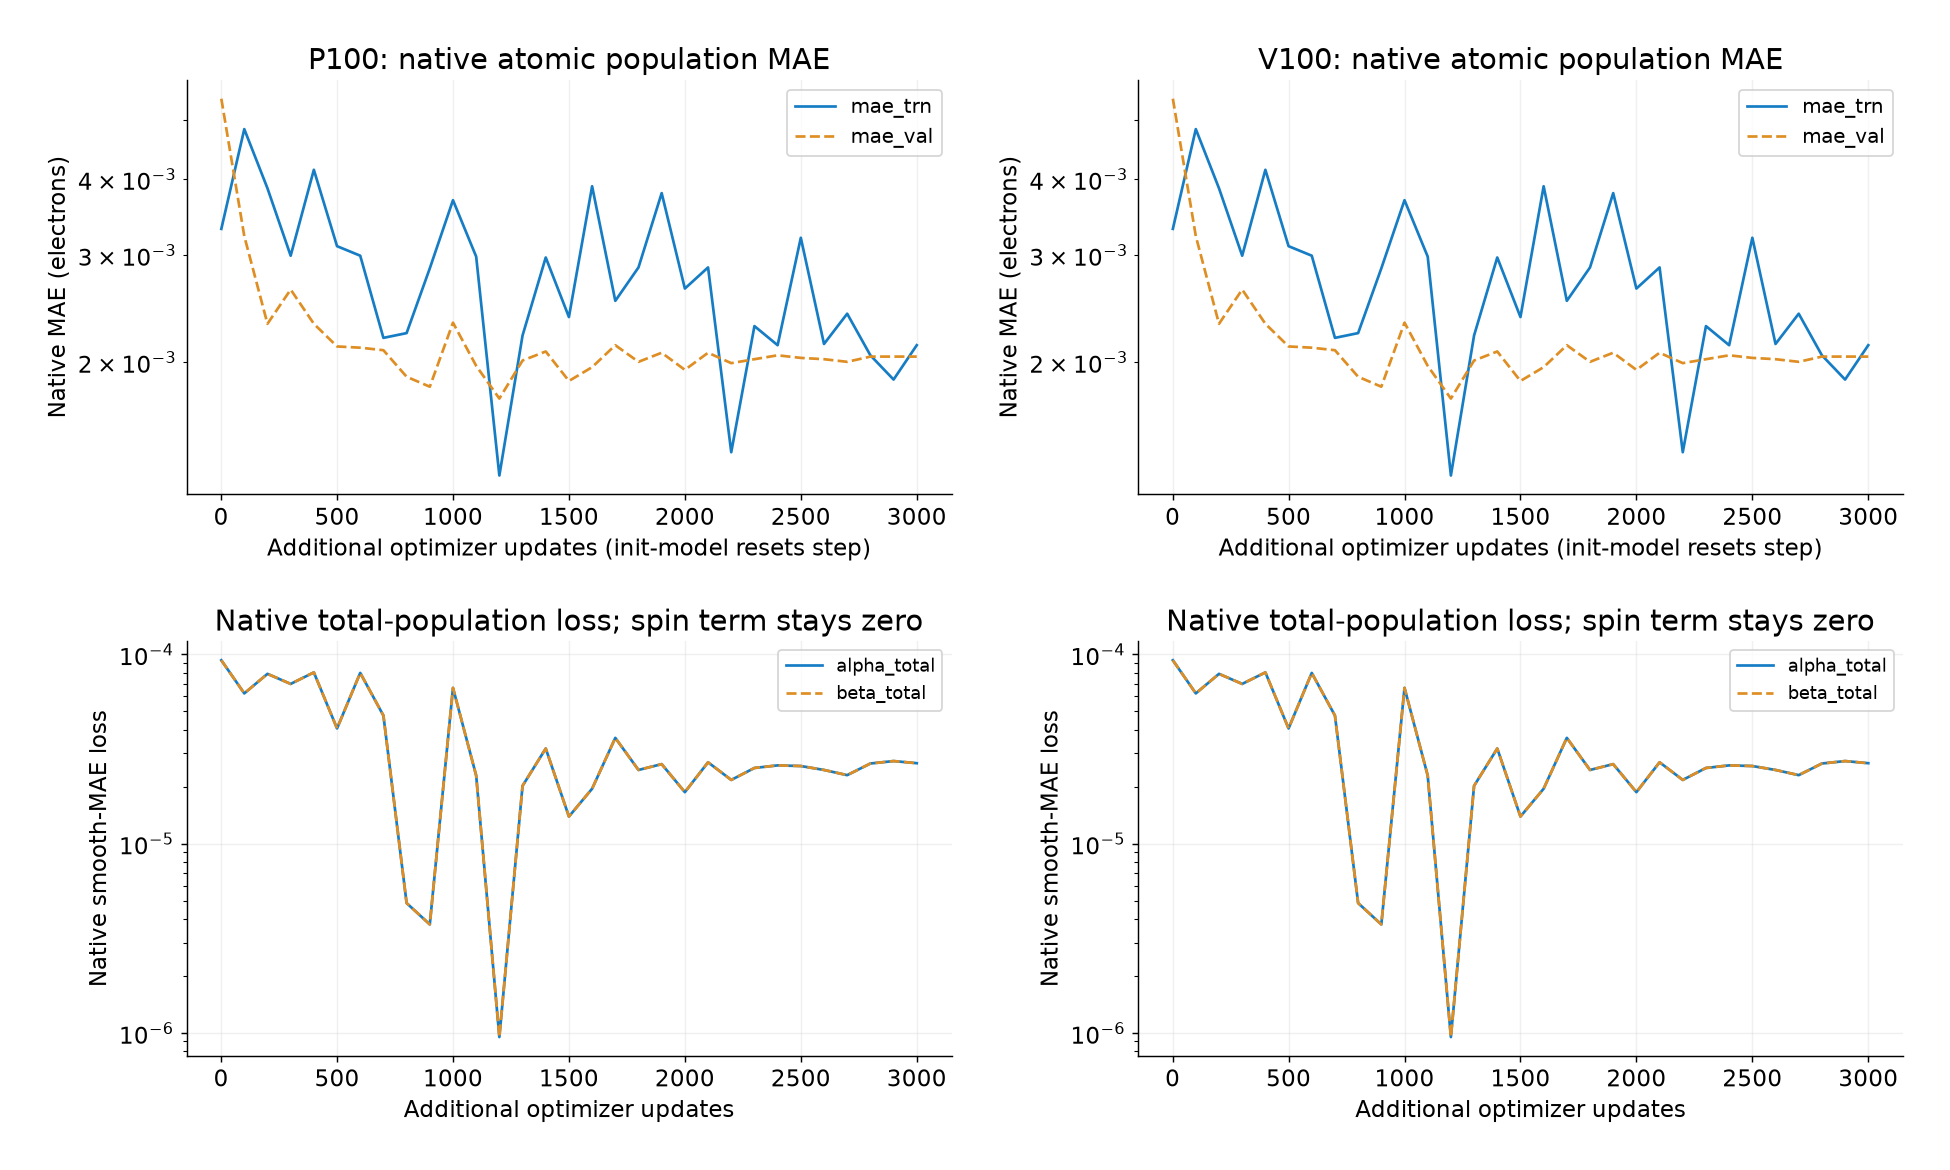
学习曲线直接来自 lcurve.out。上面是逐原子布居原生MAE;下面是α、β总布居损失,两条重叠。闭壳层自旋项保持为零,没有用人为小数替代零值在对数轴上作图。
环境为DeePMD-kit3.2.0、PyTorch2.12.0、GCC13.3、CUDA12.9,加载 deepmd-kit/3.2.0;NumPy与Matplotlib使用ASE3.29.0环境。量化数据来自此前真实Gaussian16 C.01 AVX计算。继续电荷和自旋布居分析。
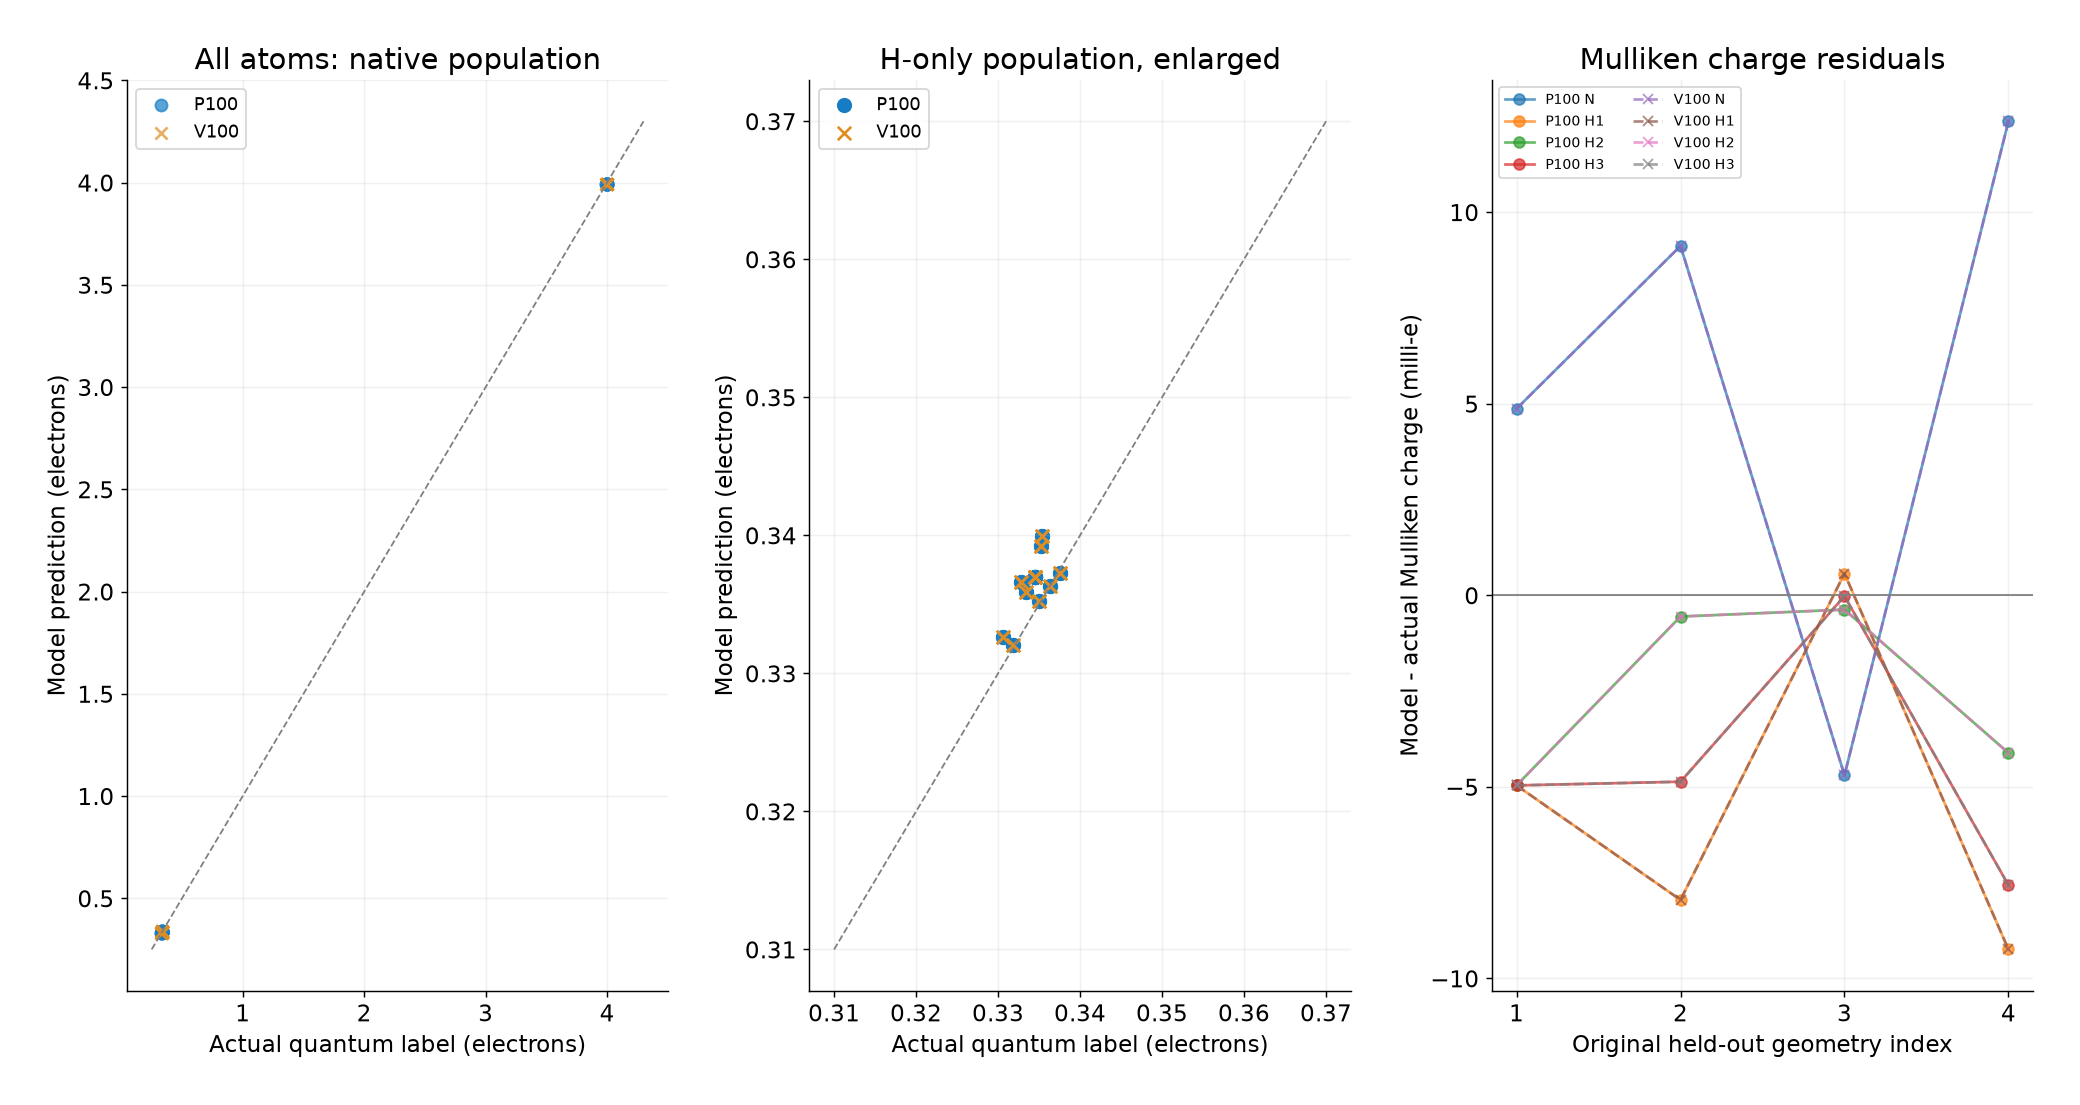
本次逐原子两通道布居RMSE约0.00307个电子,换算的Mulliken电荷RMSE约0.00614 e。测试帧来自4个原始几何的三种姿态,图中每个原始结构只取一种姿态,避免把姿态重复当成更多独立数据。