
DeePMD后端CPU与GPU实操
按P100和V10016G实际运行路径提交单卡作业,理解设备导出、结果表和兼容边界。
阅读本篇目录
本篇说明同权重示例的GPU入口、目标设备导出和格式兼容事项。下载完整示例包。
1 单卡作业怎样选择设备#
完成前两篇的新计算后,查看实际提交脚本:
sed -n '1,28p' new-work/job.slurm
P100默认使用 gpu-8p100-hs 和 gpu:p100-16g:1;V10016G入口使用 gpu-8v100-16g-hs 和 gpu:v100-16g:1。脚本只申请一张卡,CPU参考部分在同一个作业内临时隐藏GPU,GPU部分保留Slurm分配的可见设备。不要手动把 CUDA_VISIBLE_DEVICES 改成节点上任意卡号。
本例已在P100和V10016G上实际执行PyTorch、TensorFlow1、TensorFlow2、PyTorch Export和JAX。NumPy走CPU能量参考;Paddle本包安装的是3.3.0 CPU版,使用原生检查点CPU推断,不能据此宣称已提供Paddle GPU环境。
2 比较CPU与GPU结果#
head -n 13 tables-new/cpu-gpu-errors.csv
每行给出相同结构在两个设备间的差值和单位对应的比较尺度:能量按原子数归一,力逐分量比较,virial逐矩阵分量比较。CSV共比较五个后端、四个结构及三种物理量。判断自己的结果时先检查量纲和原子对应关系,再区分浮点末位变化与物理量明显改变。
JAX示例采用CUDA12组件和cuDNN9.10.2.21,并明确选择CUDA平台;不使用CPU回退掩盖GPU不可用。平台要求可查JAX官方安装说明和NVIDIA该版cuDNN支持表。
3 不要只改后缀或检查文件能不能读#
sha256sum source/model.pth
这个SHA256应与第一篇的原始模型一致。不同后端的文件内容不同,不应要求它们的文件哈希相同;应要求转换后的能量、力与virial代表相同的函数。
本例特别处理了三种实际遇到的情况:
- 单元素描述符组织。 原模型只有一种Si元素和一个嵌入网络;导出程序将等价的网络索引表示整理成单侧类型形式,同时保持所有数值数组不变。四个结构整理前后均进行原生求值比较。不要把这个仅针对单元素模型的操作套到多元素模型上。
- TensorFlow1能量统计量。 这里PyTorch能量头对输出加上
out_bias,而TF1路径还会乘out_std。直接转换可能得到“文件能读、结果不同”的模型。包内专用导出程序只针对这个能量模型把导出统计量的std设为1,保留网络权重与能量偏置,再比较四个结构。不是对预测结果事后平移或拟合,也不是所有张量模型的通用转换配方。 - 目标设备导出。 本例在CPU导出的
.pte不能直接假定可移到CUDA;GPU阶段针对Slurm分配设备重新导出。JAX.hlo也按CPU或CUDA平台分别生成。复制这些格式到其他平台前应重新检查或导出。
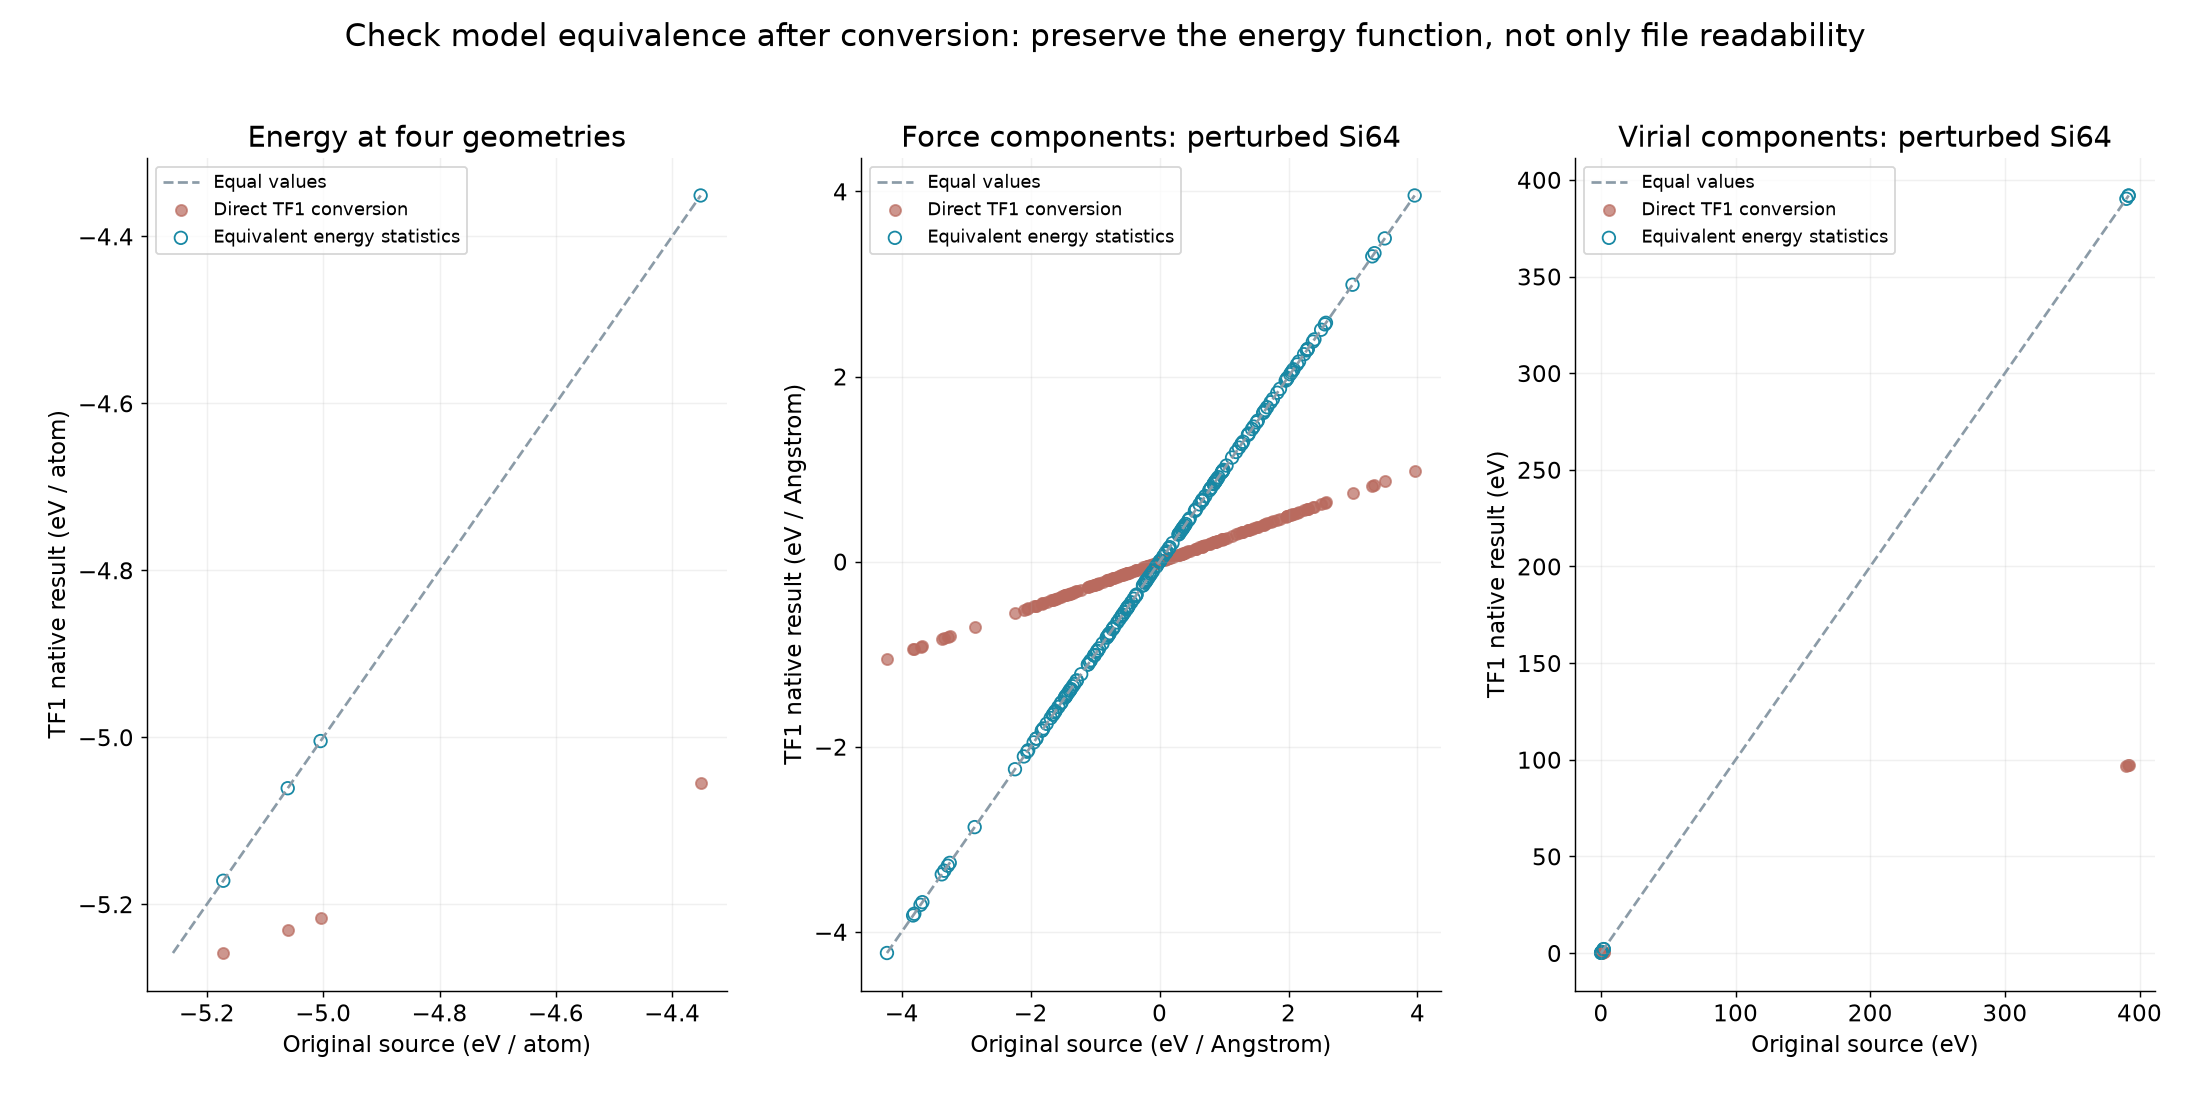
图中保留直接TF1转换的实际偏差作操作提示,等价导出后的点回到原始模型对角线上。遇到这种量级的变化应先检查模型表示,不能解释成GPU浮点误差。
Paddle示例使用 .pd 原生检查点与 DeepPot 接口。当前依赖组合下,直接导出的静态JSON模型读取遇到接口不匹配,因此本包没有把JSON静态路径列为可用示例。JAX训练检查点 .jax 也不要直接改名成推断文件;本例使用原生导出的 .hlo。
4 最后得到哪些文件#
ls figures/*.png
figures 是六张附带参考图;tables-new/backend-results.csv 和 tables-new/cpu-gpu-errors.csv 是这次作业的新结果;new-work 保存你的新格式模型、原生求值数组、日志和实际Slurm输入。保留这一整个目录,之后换模型或换结构时复制一份新目录再改输入,避免混淆两次结果。
本例只讨论一个 se_e2_a 单元素能量模型的多后端接口;张量训练、分子动力学和生产精度评估分别看相应专题,不把后端文件转换当成这些工作的替代。