
DeePMD同权重能量力对照
从一个原始模型导出各后端表示,实际比较能量、原子力、virial及结构变换后的结果。
阅读本篇目录
本篇接着后端与输入准备,把同一模型依次交给七种CPU后端和五种GPU后端,检查转换前后的物理量是否一致。下载完整示例包。
1 用一个命令提交新计算#
在已解压并完成 bash setup.sh 的 Si64-backends 目录中:
bash run.sh
默认提交一个P100单卡Slurm作业,2个CPU核、8GB内存。V10016G用户在一份新的解压目录中使用 bash run.sh v100。命令会显示作业号并等待完成;排队时可以在另一终端查看作业,不要重复提交。若已有 new-work,程序会提醒保留结果并换新目录,防止覆盖旧数据。
实际流程如下:
- 从
source/model.pth复制原始模型和四个坐标,建立new-work。 - 在隐藏GPU的子进程中整理单元素描述符表示,核对整理前后的四个结构;不训练、不改变网络数值权重。
- 分别导出七个CPU后端表示,读取能量、力和virial,检查平移、旋转、原子换序与单个原子的晶格平移。
- 用两档坐标位移和两档晶胞微应变做能量差分,再与相应原生导数比较。
- 对PyTorch、TensorFlow1、TensorFlow2、PyTorch Export和JAX逐个执行GPU推断;Export和JAX针对当前设备重新导出。
- 比较CPU与GPU结果,生成自己的CSV和检查摘要。所有原生求值均在这个Slurm作业中执行。
这里没有调用训练命令。更换后端时应先确认相同模型的能量、力等结果一致,再开展MD或其他生产工作。
2 查看自己的能量、力和virial表#
head -n 15 tables-new/backend-results.csv
表中每行对应一个设备、后端和结构,字段为:device、backend、geometry、energy_eV_peratom、max_force_eVA 和 virial_trace_eV。CPU下有七个后端,GPU下有五个,每个都使用相同的四个结构。NumPy原生导数位置保留 NaN。
能量单位为eV/原子;表中力是全部原子、全部方向中的最大绝对分量,单位eV/Å;最后一列是3×3 virial矩阵的迹,单位eV。virial不是压力,没有除以体积;原生九分量和逐原子三分量受力保存在各后端的 native-comparisons.npz。
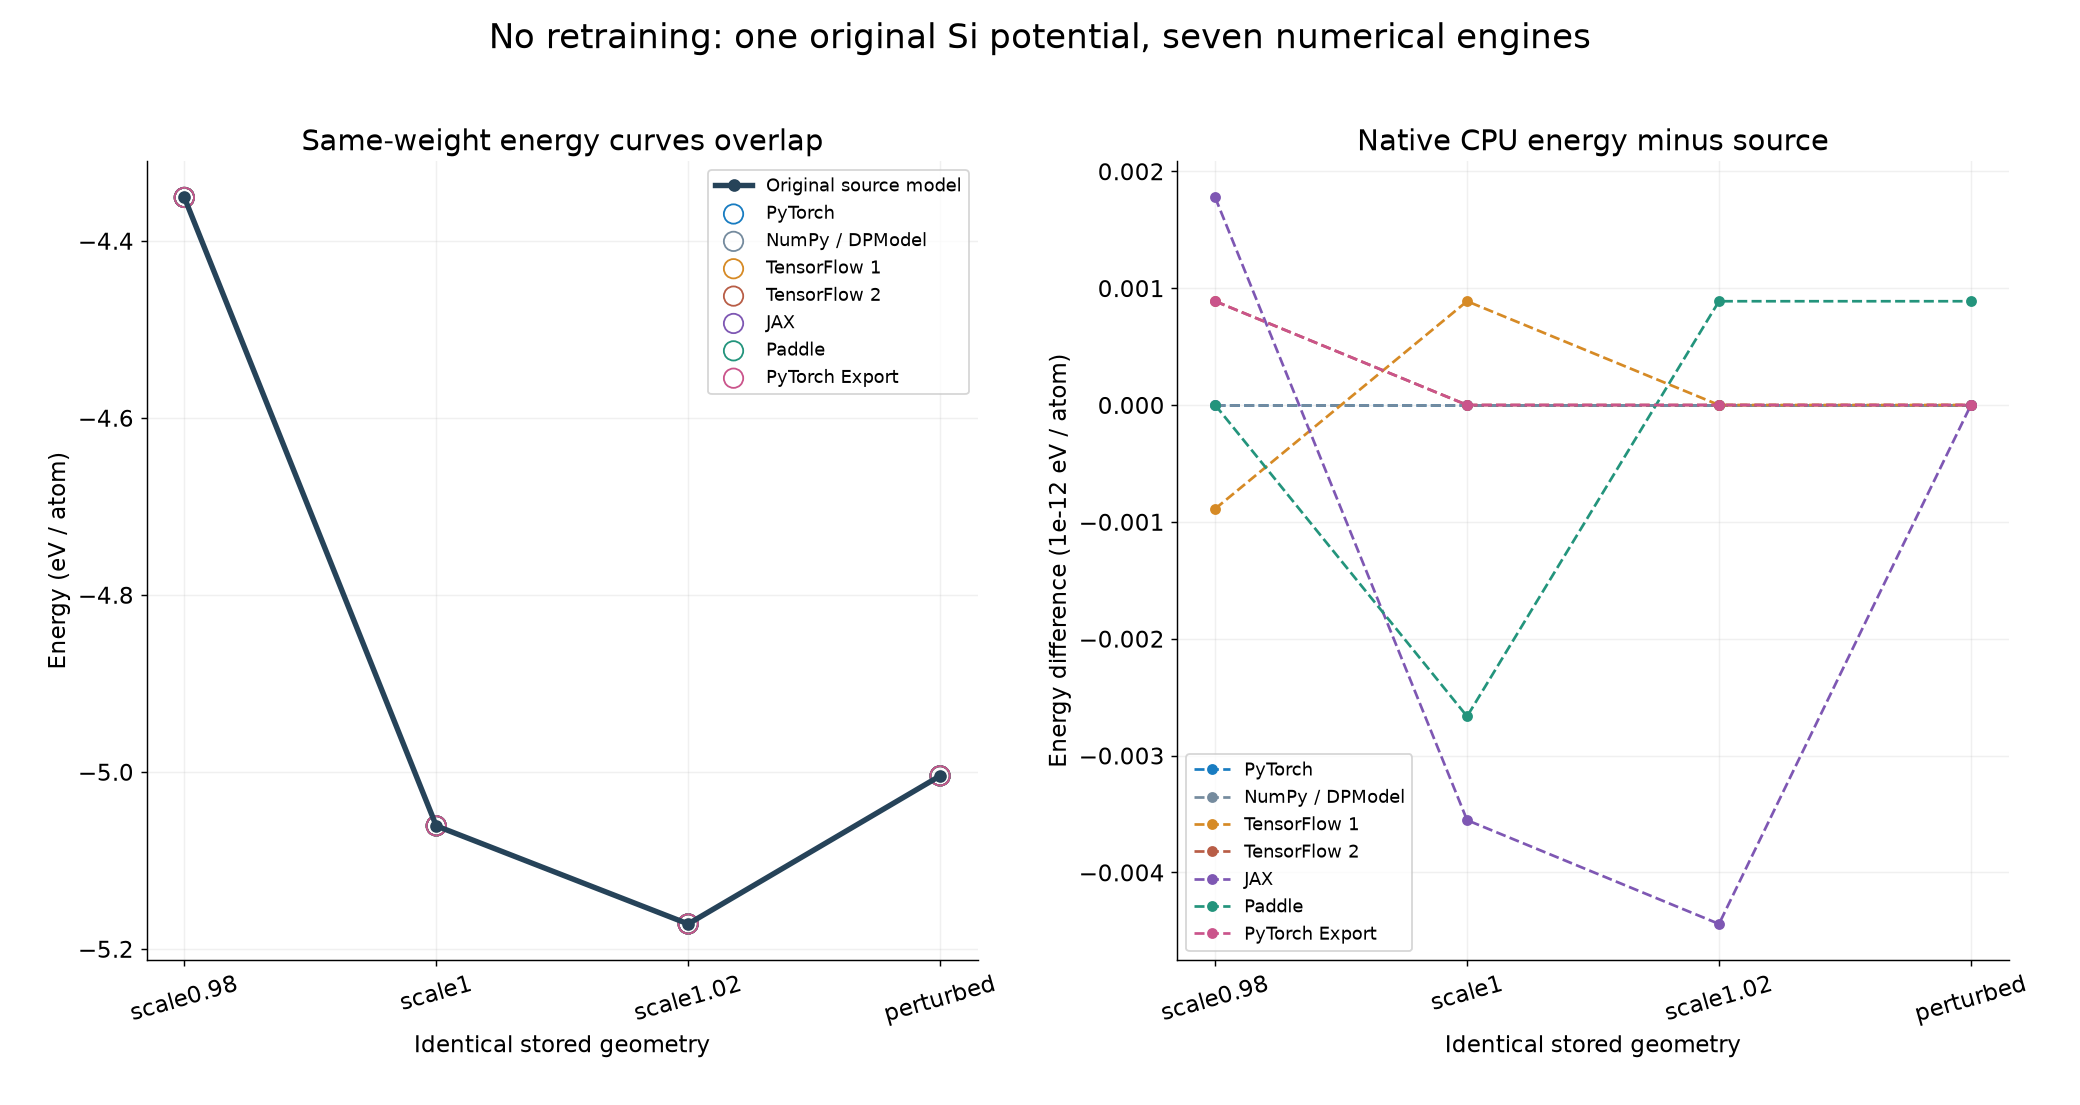
图左的七个后端能量几乎完全重合;右图把极小差值放大显示。这里的差值是相同模型的数值差别,不是与DFT参考之间的训练误差。
3 看原子力,以及为什么还要做变换和差分#
python3 code/summary.py
摘要会列出设备、新增训练次数、新增量化计算次数和求值次数。本例两项新增计算次数都为0,实际执行的是已有模型的转换与原生推断。
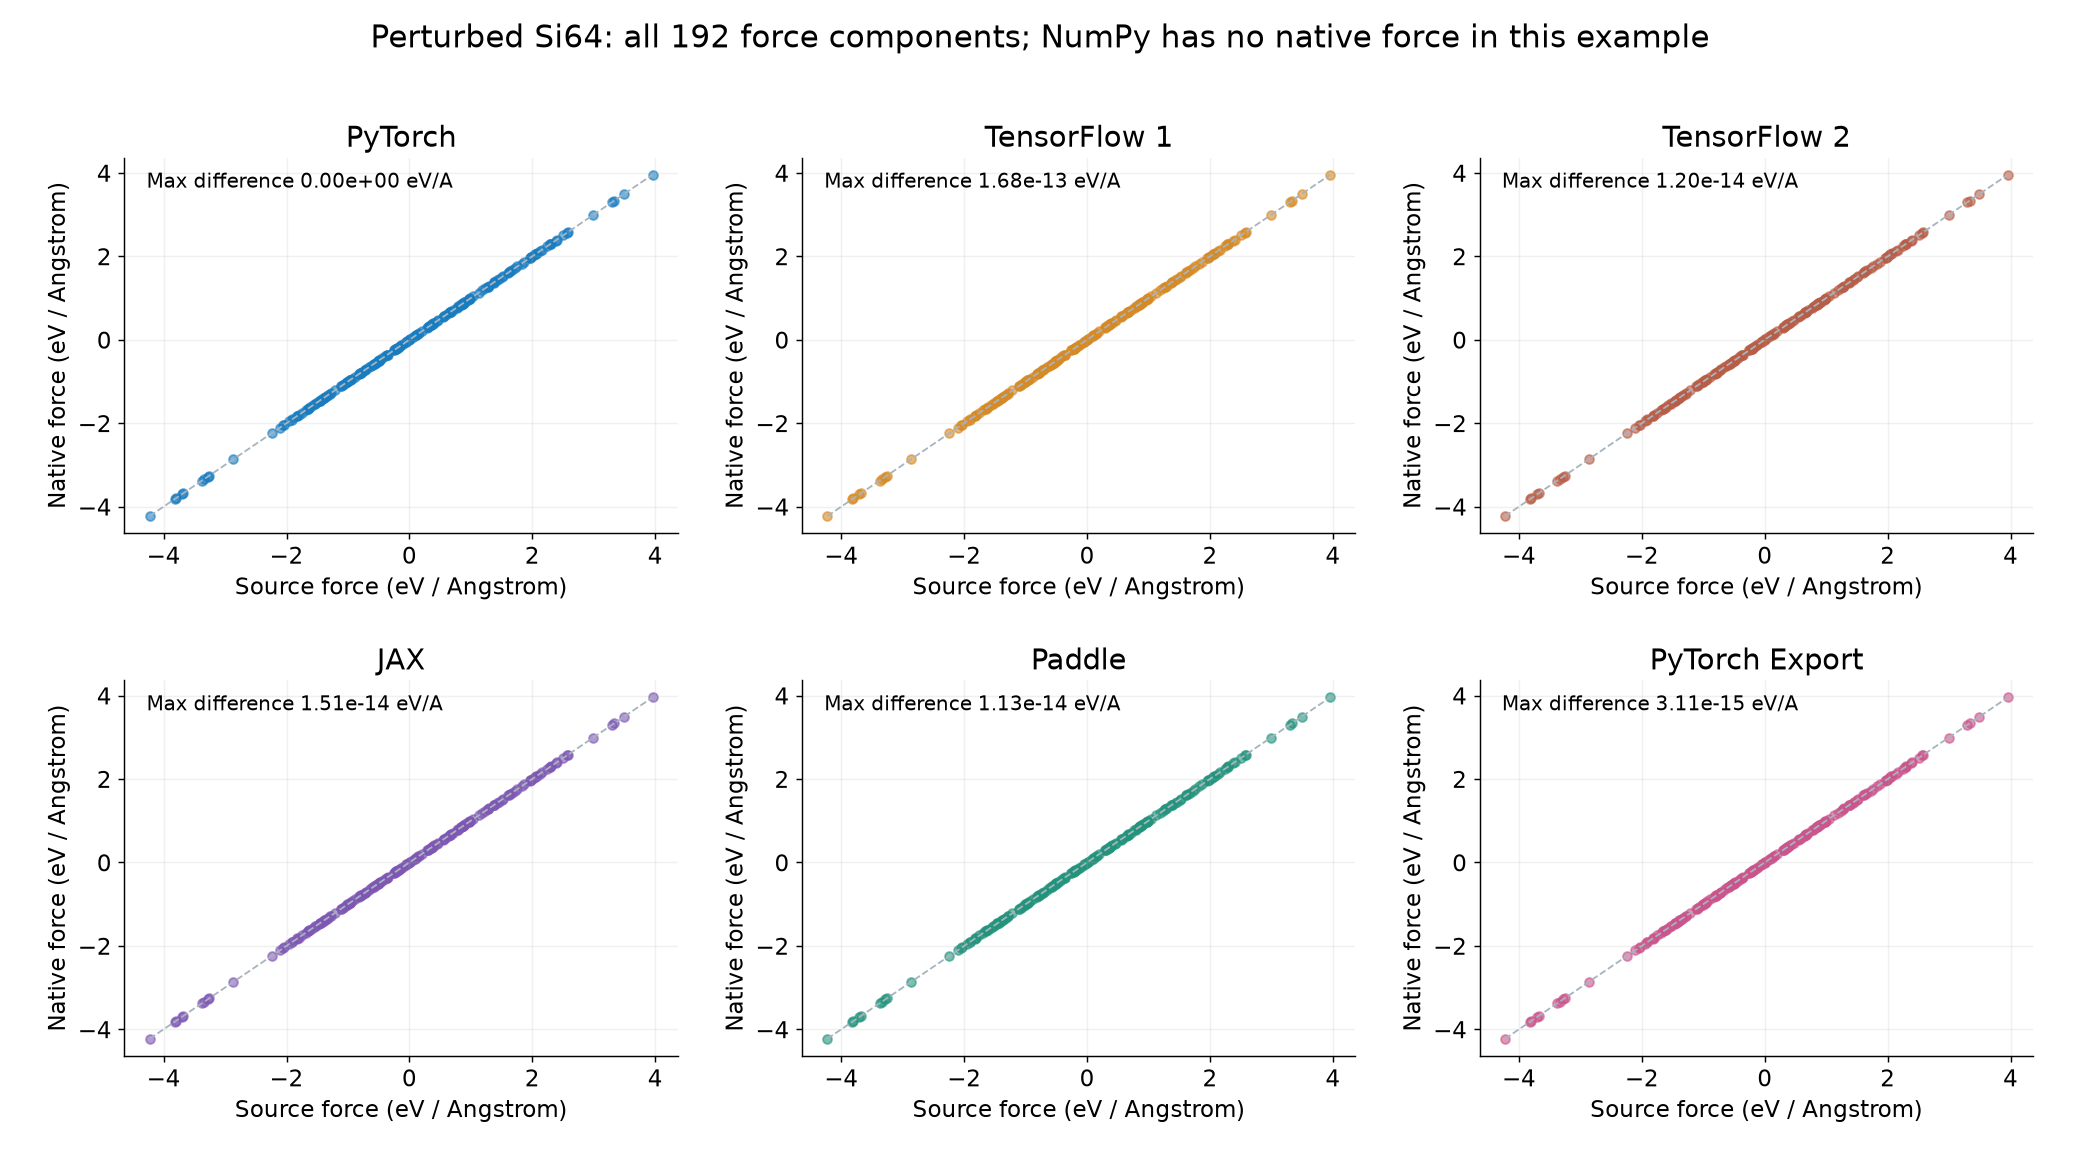
扰动结构有192个力分量。更换原子顺序后,受力要按相同置换对应;刚体旋转后,力矢量和virial张量也要旋转。只比较总能量容易漏掉原子顺序或张量变换问题。
坐标差分取 1E-5 和 3E-6 Å,按 F=-dE/dx 检查六个选定分量。晶胞差分对晶胞与坐标施加同一形变,用两档微应变检查六个矩阵分量;这里使用右乘形变矩阵,因此对应 W_ab=-dE/dε_ab。NumPy只用它提供的能量做外部差分,这不等于NumPy原生返回了力或virial。
4 画图#
bash plot.sh
这个命令根据包内的 reference 数据重画六张参考图,写入 figures,便于对照本教程。它不会提交新计算,也不会把参考曲线冒称为你刚刚生成的新结果。自己的新结果在 tables-new 与 new-work 中保留。
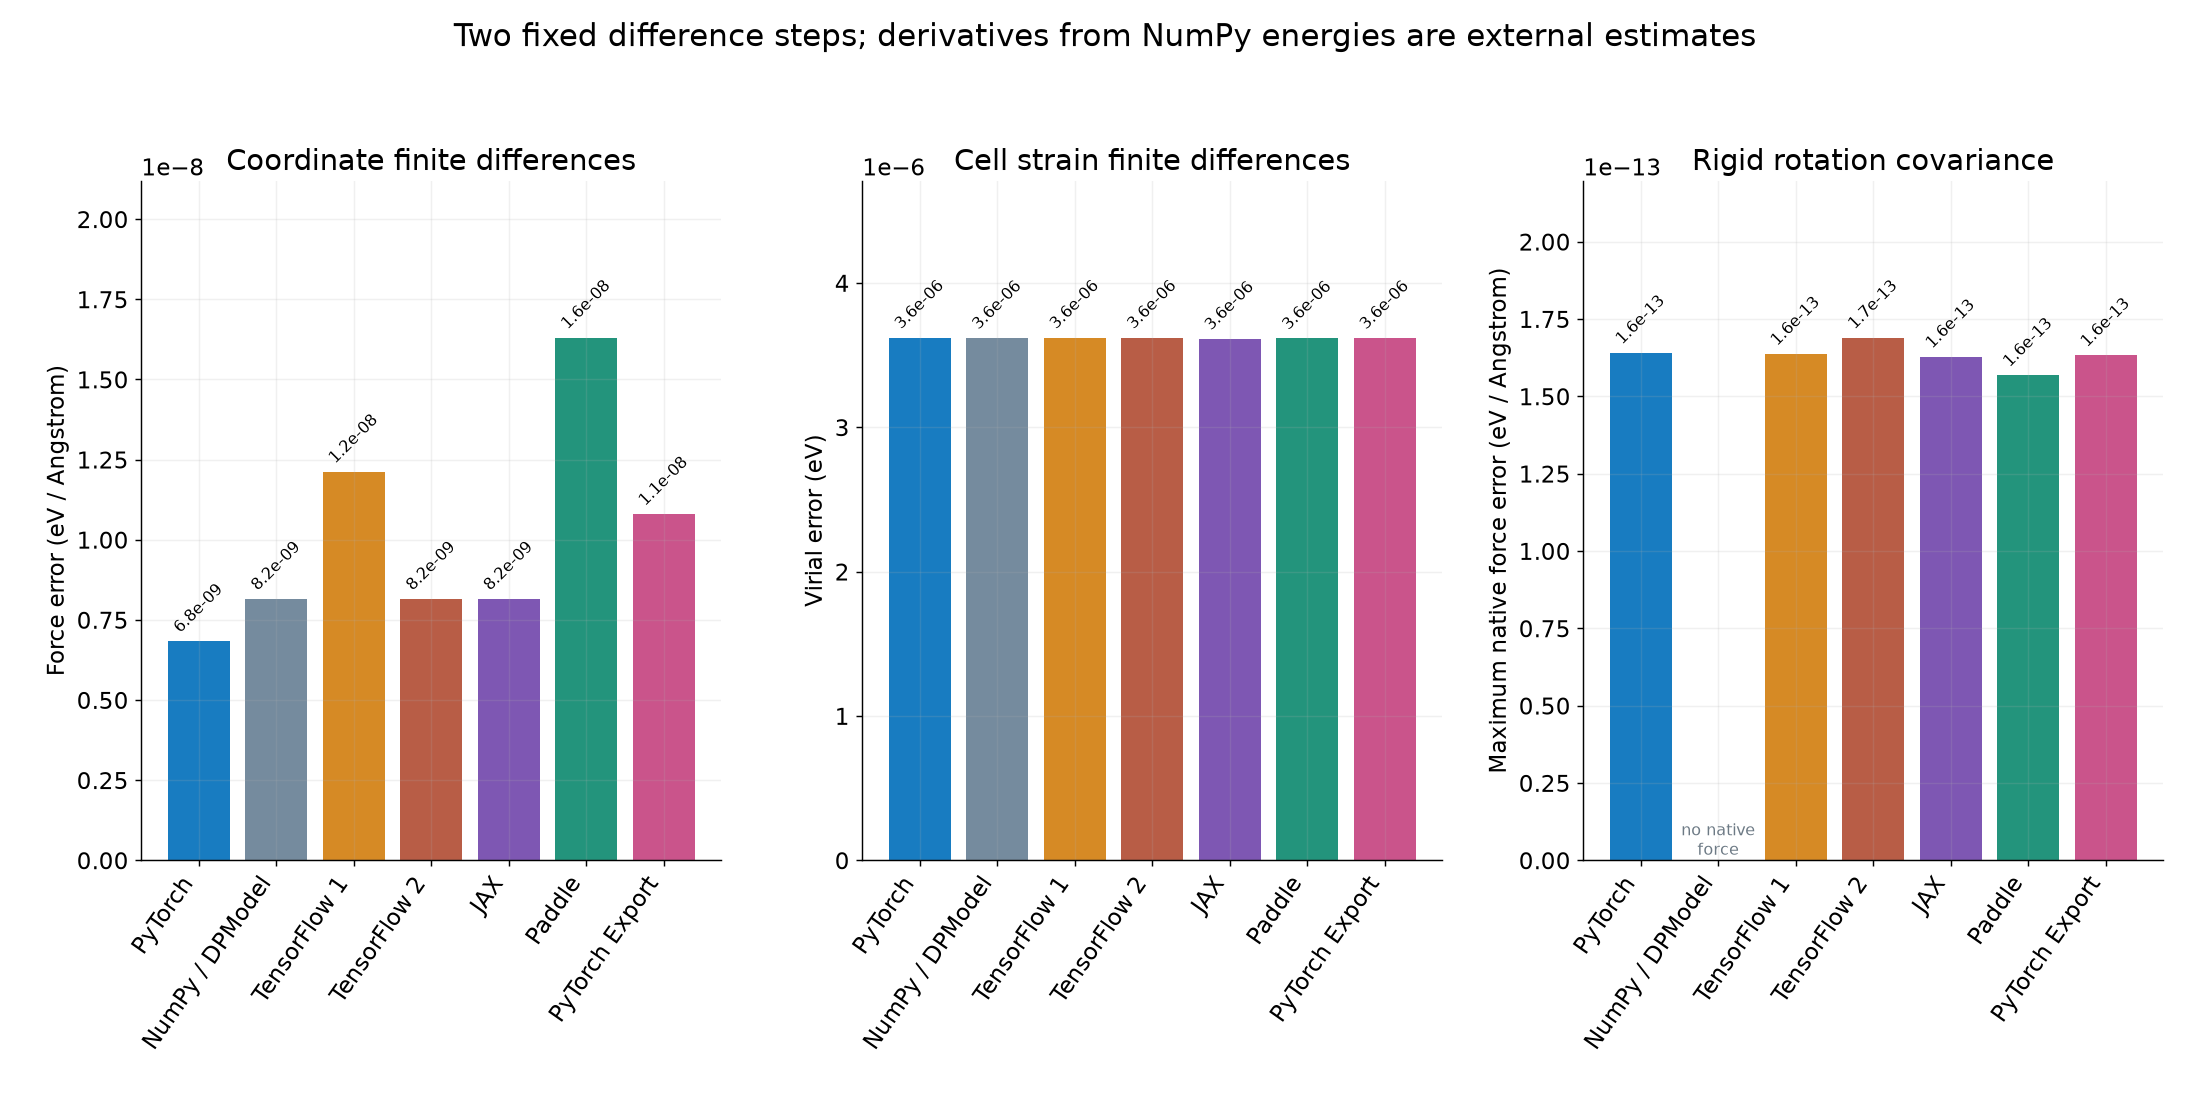
这是一组固定模型和小结构的操作示范。生产任务还需要针对实际训练集、体系组成、温压和构型范围检查物理精度,不能把后端一致性当成势函数已具备迁移能力。