
DeePMD旧类型嵌入se_a_ebd_v2实操
读取完整旧类型嵌入输入,比较真实测试集误差,查看原生学习曲线与新作业结果。
阅读本篇目录
本篇介绍TensorFlow旧式类型嵌入描述符se_a_ebd_v2。先按局部坐标系教程完成下载、环境检查和一次bash run.sh,再在同一目录查看本模型。下载三个实例的完整资料包。
1 打开完整输入#
cat inputs/se_a_ebd_v2.json
实际模型部分如下;文件中同时提供学习率、损失及训练/验证数据路径:
{
  "type": "standard",
  "type_map": [
    "N",
    "H"
  ],
  "descriptor": {
    "type": "se_a_ebd_v2",
    "rcut": 3.0,
    "rcut_smth": 2.5,
    "sel": [
      4,
      8
    ],
    "neuron": [
      8,
      16
    ],
    "axis_neuron": 4,
    "resnet_dt": false,
    "precision": "float64",
    "seed": 600001
  },
  "fitting_net": {
    "type": "ener",
    "neuron": [
      32,
      32
    ],
    "resnet_dt": false,
    "precision": "float64",
    "seed": 600002
  }
}
type_map=[N,H]必须与数据的类型编号一致;rcut=3、rcut_smth=2.5单位Å。neuron=[8,16]是嵌入网络,axis_neuron=4控制描述符中的轴矩阵维数,后面的fitting_net=[32,32]拟合总能量。原子力由总能量对坐标求导,不是另建一个任意预测力的网络。
本例训练12000步,batch 4,起始学习率0.002、终值0.00001;能量与力损失权重均为1,virial权重为0。原始构型先分组,再做姿态扩展;测试集不参与优化。se_a_ebd_v2与se_e3_tebd是不同入口,不能只改名字就假定参数相同。
2 查看自己的测试结果#
head -n 4 tables-new/model-results.csv
三行分别对应三个模型。energy_RMSE_per_real_atom_eV按每个氨分子4个真实原子归一;force_RMSE_real_eVA只统计真实原子的三个方向。P100这次实算的旧类型嵌入能量RMSE约0.0001308eV/原子、力RMSE约0.01414eV/Å;V10016G独立训练得到约0.0004185eV/原子、0.005712eV/Å。不同设备重新训练的优化轨迹可能不同,这不等于同一个权重在两块设备上给出不同预测。
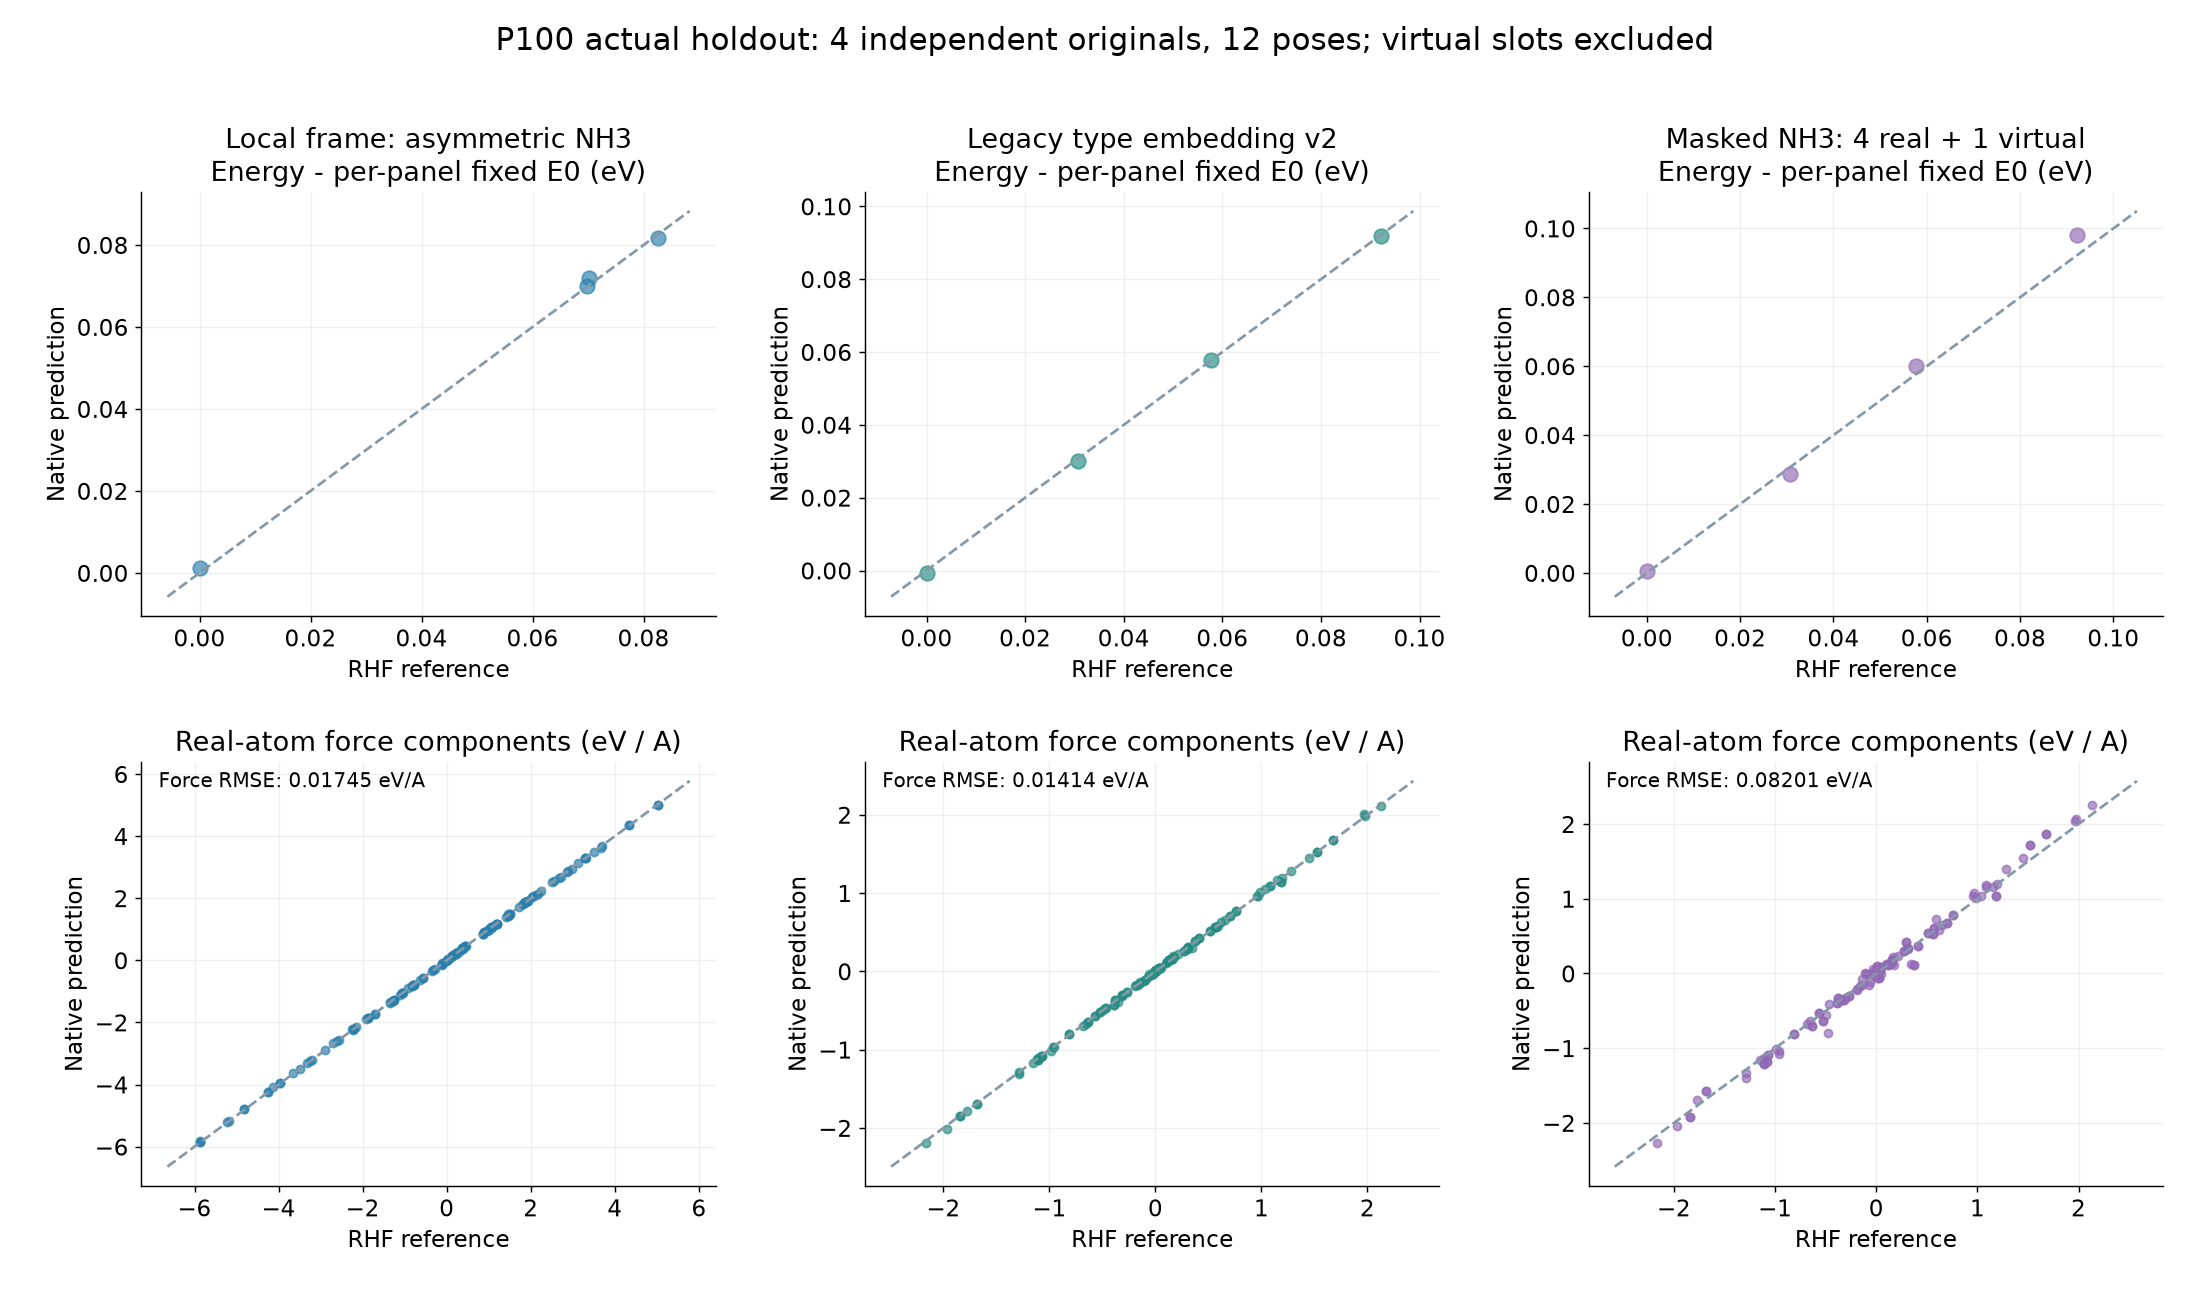
局部坐标系用了另一组不等长键构型,掩码模型的训练步数也不同,因此不能用这三行直接作通用描述符排名。四个独立测试构型对应12个姿态,不应当成12个完全独立化学样本。
3 看学习过程#
head -n 6 new-work/p100-se_a_ebd_v2/lcurve.out
V100运行时将目录前缀换成v100-。日志分别给出训练和验证误差,frozen_model.pb用于原生测试和推断。原始TensorFlow检查点留在同一模型目录中;训练续算与冻结模型推断是两种操作,不要拿.pb代替优化器检查点。
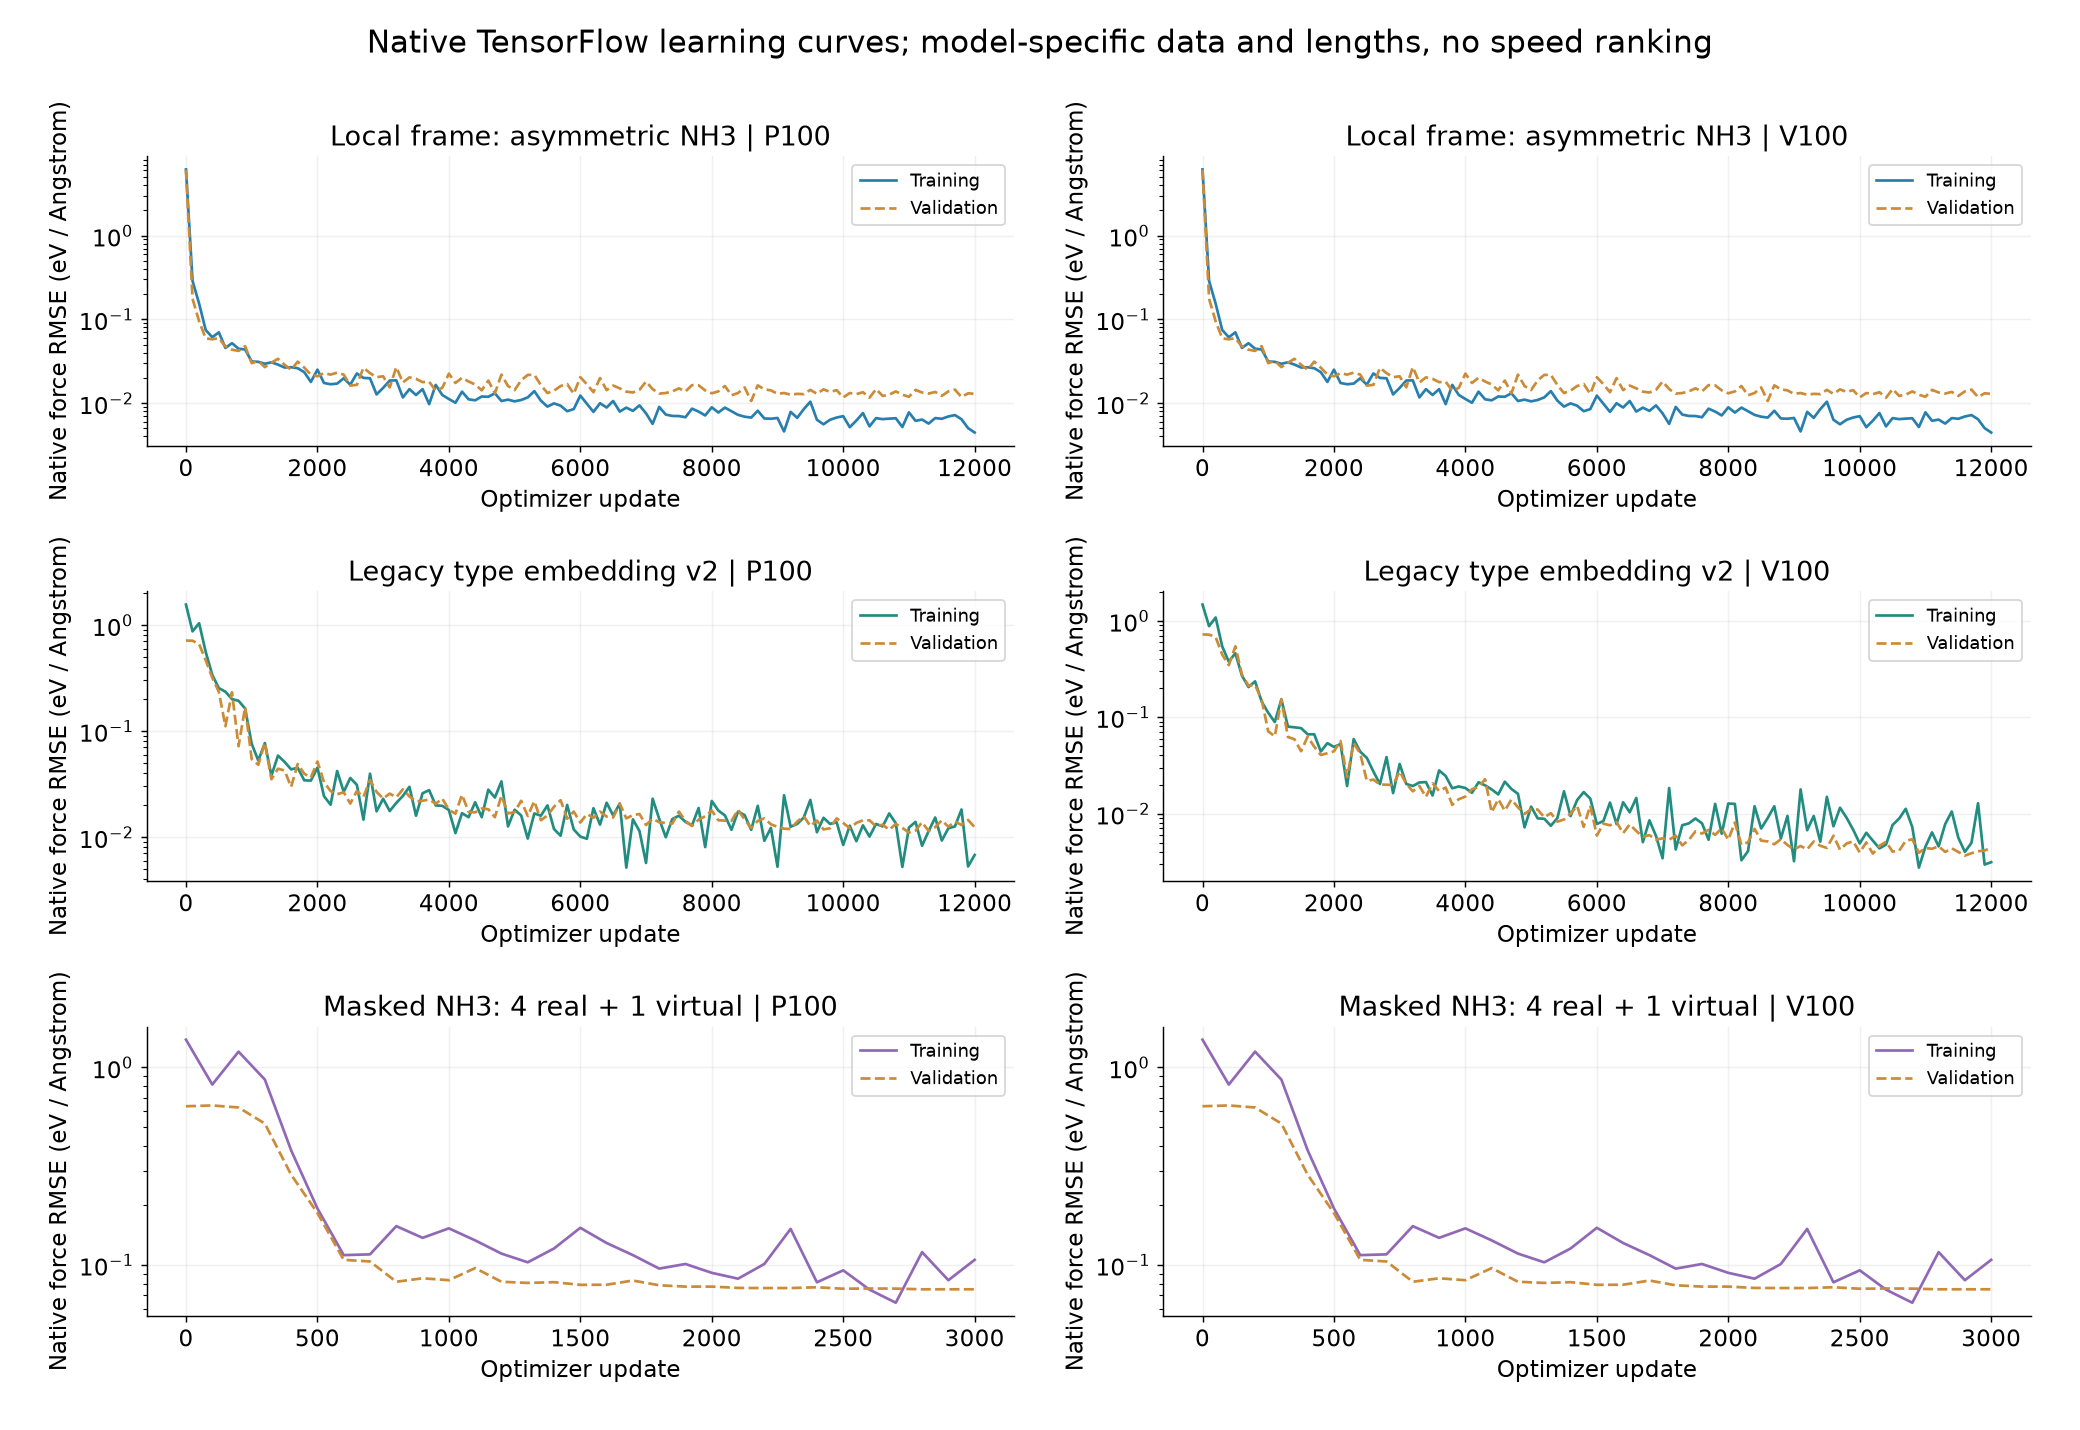
上图是实际原生日志。掩码模型的原生日志按输入容量槽记录误差;下一篇解释其与真实原子误差表的区别。
4 查看新作业摘要#
python3 code/summary.py
应看到3个新模型、27000次优化更新、新结果检查摘要以及0次新量子化学调用。自己的预测在new-work/API-*,所附参考在reference。这份数据没有覆盖解离、反应和其他氮氢配比;延长这个小数据集的训练并不会自动补足这些构型。