
DP-GEN自动生成结构分组与参数骨架
从32个已有Si实算构型生成sys_configs和温压任务描述,解释默认分组数量、目录扫描与完整参数需要补充的内容。
阅读本篇目录
auto_gen_param帮助整理结构路径和生成一组默认探索任务描述。它的输出是参数骨架,不是自动完成训练、模拟与第一性原理标注的完整任务。本篇用32个已有Si实算构型演示,生成阶段不提交任何计算。
1 下载与目录#
下载DP-GEN数据工具实例包,保存为dpgen-data-tools.zip。
python3 -m zipfile -e dpgen-data-tools.zip .
cd dpgen-data-tools
附件使用DP-GEN0.14.0、Python3.12及其现有dpdata依赖,run.sh自动加载模块。收集和统计只读已有结果;本包不训练模型,不运行LAMMPS或VASP,不需要GPU。较大数据处理可使用1CPU批作业,例如sbatch job.slurm collect。
auto/
  generation.json
  structures/Si/
    Si2-000/POSCAR ... Si2-015/POSCAR
    Si8-000/POSCAR ... Si8-015/POSCAR
32个结构来自此前真实VASP标签所对应的初始构型,各16个Si2和Si8。它们都是Si元素体系;这里放在同一个扫描组,演示分组与路径生成,不把不同原子数拼成同一个标签数组。
2 查看温度尺度输入#
cat auto/generation.json
{
  "melt_point": 1687
}
1687 K在这里是给生成器的温度尺度输入,不是本例计算出的熔点。温度扫描还需要根据研究目标与势函数适用范围调整,不能把默认列表当成任何材料的通用方案。
3 生成参数#
bash run.sh generate
原生命令为:
module load dpgen/0.14.0
cd auto
dpgen auto_gen_param generation.json
输出auto/param_basic.json。当前0.14.0命令行入口从JSON读取melt_point,其他高级扫描/分组参数由底层函数控制;不能在这个小JSON随意添加键,就假定命令行一定会采用。
4 默认20个结构如何变成8组#
默认每个扫描组按1,1,2,2,2,4,4,4取文件,总计20个,生成8个sys_configs组。本例提供32个实际结构,默认选其中20个;余下12个不会自动被补入分组。
当前实现的扫描筛选门槛与后续默认分组数量不同:只准备16份结构虽然可能进入分组阶段,后续仍会因缺少第17–20份而越界。使用默认命令时,每个扫描组至少准备20份有效POSCAR;本例32份已经满足。
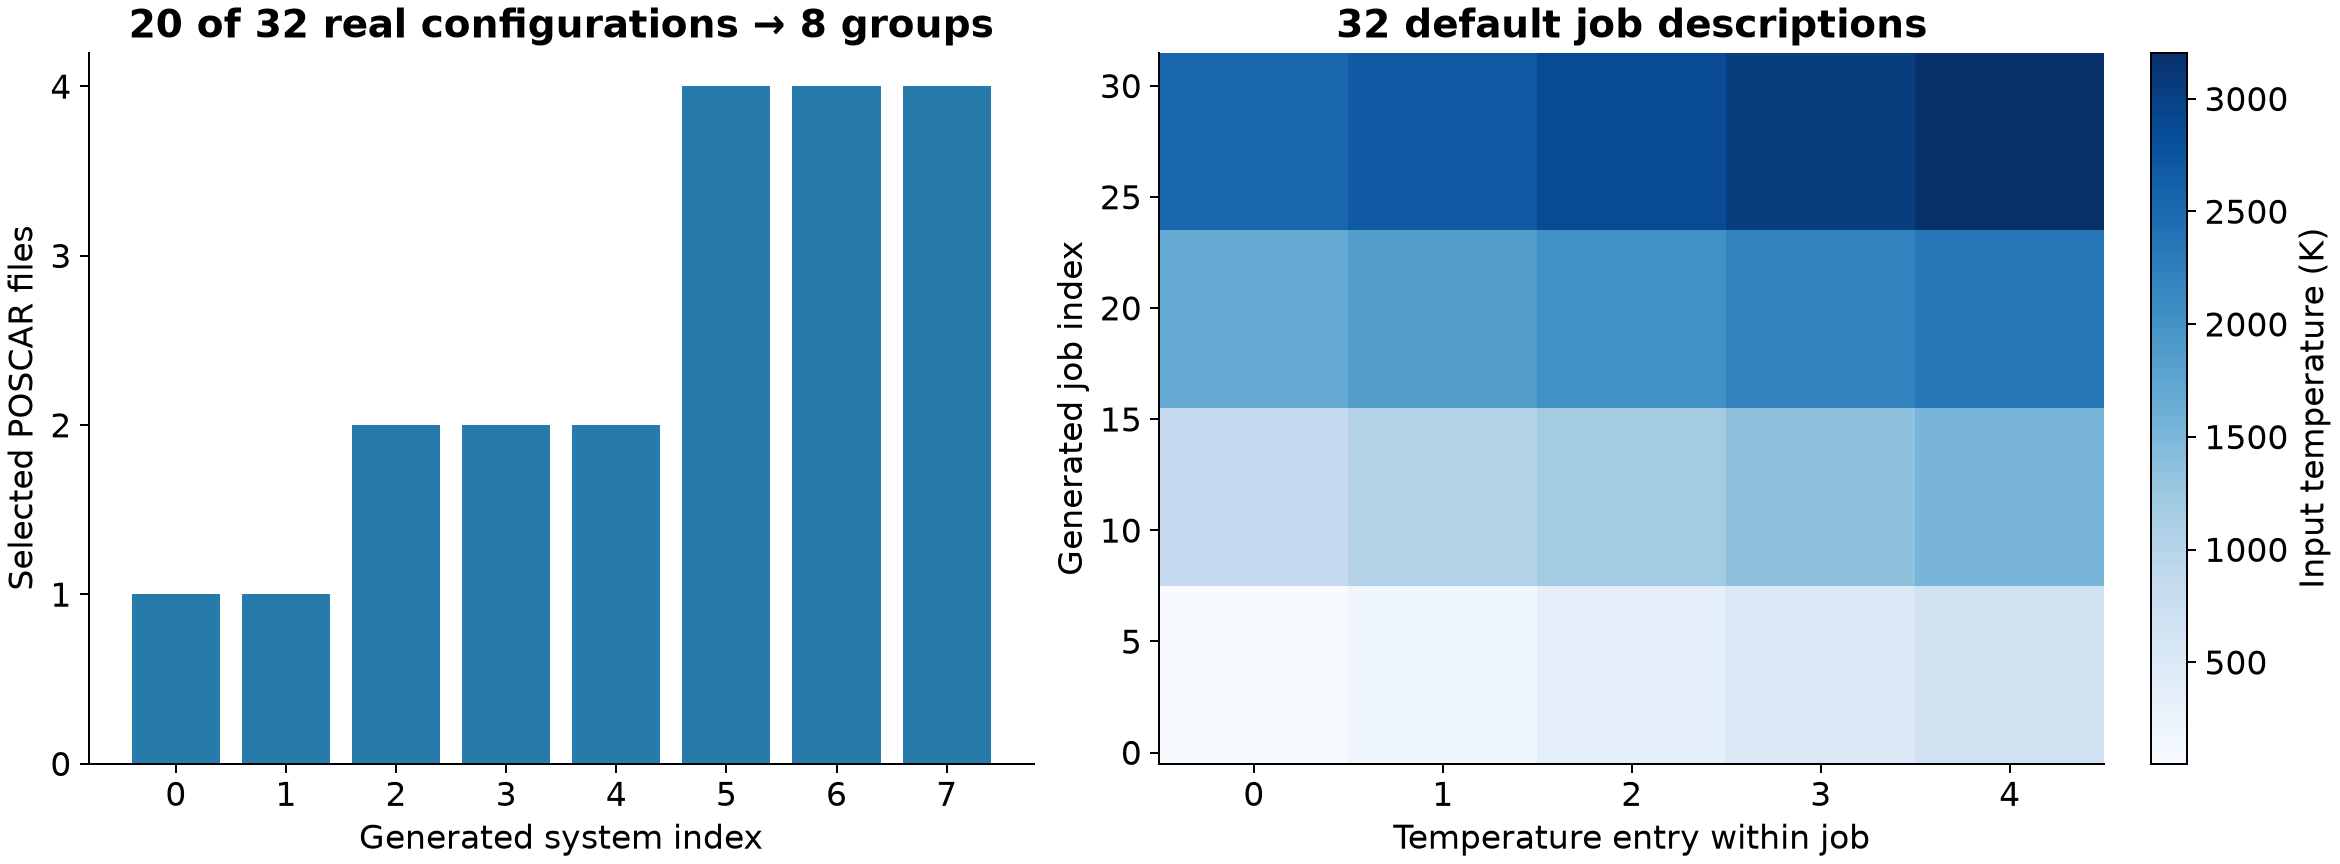
右图表示生成的32条任务描述中的输入温度,并不表示已经完成32个温压条件计算;每条还含多个温度、压力、步数等设置,完整探索的实际作业数可能更多。
5 打开结果,检查路径和条件#
python - <<'PYCODE'
import json
p = json.load(open('auto/param_basic.json'))
print('结构组数:', len(p['sys_configs']))
print('每组结构数:', [len(x) for x in p['sys_configs']])
print('任务描述数:', len(p['model_devi_jobs']))
print('第一条任务:', p['model_devi_jobs'][0])
PYCODE
本例结构组数8、每组[1,1,2,2,2,4,4,4]、任务描述数32。目录扫描并不保证与你手工设想的结构顺序一致,生成后逐项检查路径与组分,不把文件编号当成固定物理分组。
6 补齐完整主动学习参数后再提交#
骨架主要包括init_data_sys、sys_configs和model_devi_jobs。本例只扫描结构,init_data_sys为空;不会自动把其他目录的训练标签搜进来,也没有准备模型委员会、训练输入、候选阈值、第一性原理赝势/参数和machine.json。
保留原始param_basic.json作为参考,按DP-GEN训练、探索与再训练组织完整参数,确认工作目录、资源、预算与数据单位后再启动主控。已经有完整参数的任务不应被这个骨架覆盖。
图表数据与重新绘图#
bash plot.sh
图件保存在plots/,原数值另存于附件reference-data/。直接下载:Initial-Si2.csv、Initial-Si8.csv、New-Si8-labels.csv、generated-job-temperatures.csv、generated-system-groups.csv。