
DP-GEN已有标签数据筛选实操
用32帧真实Si DFT数据运行原生simplify,说明四模型训练、筛选、标签复用与最后的输出。
阅读本篇目录
dpgen simplify用于筛选已经积累的构型数据。本例使用鸢算科技已有的32帧Si DFT能量、力、维里标签,包含Si2、Si8两种尺寸,每种16帧。设置labeled=true后直接复用标签,不再运行VASP;另8帧只用于训练过程的验证。
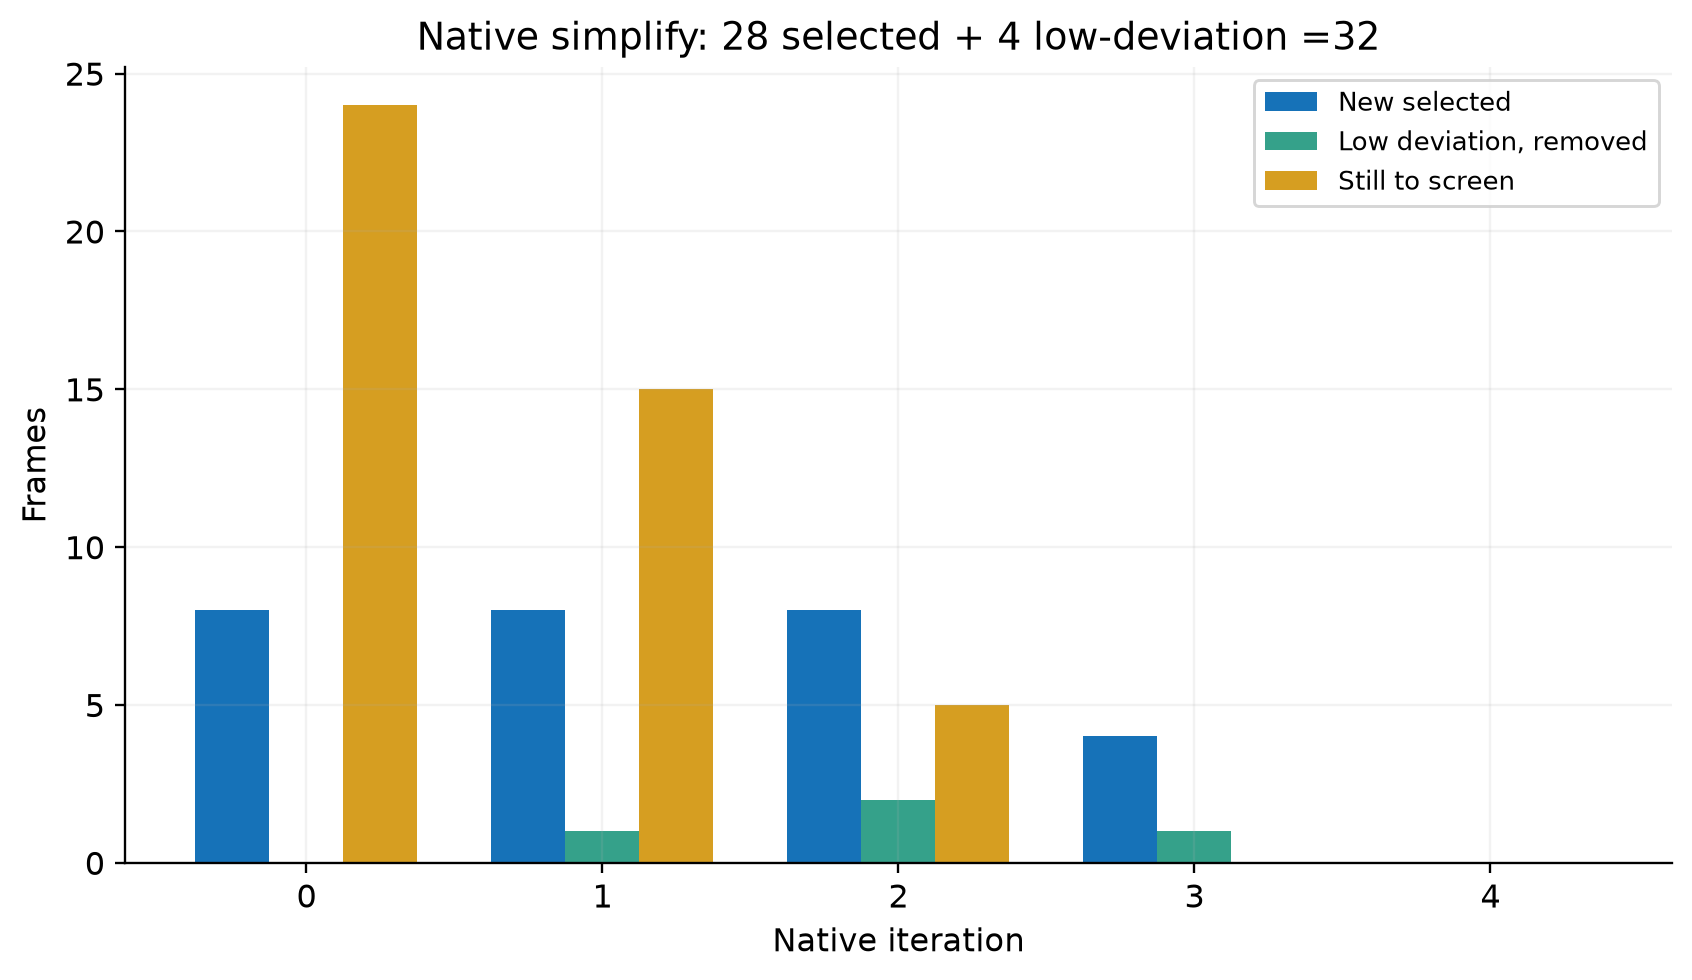
本例实际完成4轮四模型训练,每模型300步、3轮剩余数据分歧计算,最终选入28帧,另4帧归为低分歧。小规模短训练用于展示筛选步骤,不能据此认定28帧已足够训练生产势。
1 下载并先读参考数据#
下载数据简化实例包,保存为simplify.zip。
python3 -m zipfile -e simplify.zip .
cd dpgen-simplify
bash results.sh
bash plot.sh
2 参数怎么写#
cat templates/param.json
cat reference-structures/Si8.POSCAR
python prepare.py
核心参数如下,完整描述符、损失权重及数据路径都在附件:
{
  "type_map": ["Si"],
  "mass_map": [28.085],
  "labeled": true,
  "pick_data": "data/pool",
  "init_pick_number": 8,
  "iter_pick_number": 8,
  "numb_models": 4,
  "train_backend": "tensorflow",
  "model_format": "pb",
  "model_devi_f_trust_lo": 0.1,
  "model_devi_f_trust_hi": 2.0,
  "fp_style": "none",
  "fp_task_min": 1,
  "fp_task_max": 8,
  "sys_batch_size": ["auto"]
}
pick_data会递归查找DeepMD数据目录。init_pick_number=8是初始选样总数;iter_pick_number=8是每轮候选最多新增数,候选不足8时全部选取。四模型随机初始化不同,初始选样的NumPy种子在启动脚本中固定为654。
labeled=true与fp_style=none使原生流程直接连接已有标签。当前版本训练路径也读取fp_task_min等公共参数,因此这些值保留在完整配置中。sys_batch_size、init_batch_size用列表,不写成单个字符串。
3 启动和过程目录#
cat machine.json
bash workflow.sh
轻量主控在登录节点运行,训练通过普通账号Slurm提交P100-HS,分歧计算提交V10016G-HS;每个任务申请1CPU、1GPU。DP-GEN0.14.0、Python3.12与DeePMD-kit3.2.0 TensorFlow后端搭配使用。无需为此修改自己的公共数据或重跑DFT。
bash status.sh
tail -n 12 record.dpgen
ls iter.000001
ls iter.000001/01.model_devi
00.train/保存四模型,01.model_devi/保存分歧和选择结果,02.fp/在本例只是已有标签的数据连接。自己计算产生的data.picked、data.accurate、data.rest分别表示新增选样、低分歧移出样本、仍待后续筛选的样本;data.rest.old是本轮筛选前的数据。
4 实际迭代结果#
| 迭代 | 本轮选入 | 低分歧移出 | 剩余 |
|---|---|---|---|
| 0 | 8 | 0 | 24 |
| 1 | 8 | 1 | 15 |
| 2 | 8 | 2 | 5 |
| 3 | 4 | 1 | 0 |
| 4 | 0 | 0 | 0 |
迭代0先随机选8帧;迭代1至3训练并筛选剩余数据。迭代4只用最终已选择的数据完成最后一轮训练,没有新的剩余数据可筛选,所以表中三个计数为0。总计28帧选入、4帧低分歧,32帧都能追溯到原始真实标签。
cat reference-data/Si-simplify-rounds.csv
head -n 8 reference-data/Si-selected-frames.csv
ls reference-models
附件reference-models/是最后一轮四个实际冻结模型;reference-data/保留参考计数和数值。原始池在data/pool/,没有因筛选而删除。继续阅读分歧与真实误差,再决定自己的阈值和训练规模。
功能与参数参见DP-GEN官方simplify教程。