
FourPhonon:三声子迭代与四声子RTA
用同一真实Si力常数实际运行混合求解,区分RTA、三声子迭代和完整四声子迭代。
阅读本篇目录
convergence和four_phonon_iteration控制不同层次的BTE求解。本篇实际执行三声子迭代、四声子仍用RTA的混合方法;它不同于两者全RTA,也不同于完整四声子迭代。
unzip fourphonon-solvers-wave669-*.zip
cd fourphonon-solvers
bash results.sh
bash plot.sh
以上只读参考表并绘图,不启动DFT。新的原生计算以普通账号sbatch job.slurm提交,脚本自动准备干净目录、计算并提取结果;reference-data/是已完成参考,results/才是新执行的提取结果。CPU申请cpu-8173m独占整节点1任务×56核,本小例内部1MPI×1线程,计费仍按整节点。程序为FourPhonon1.3-fix20260924 CPU版,oneAPI2024.2、Intel MPI2021.13与顺序MKL,适用AVX512 CPU;本例不报告CPU节点性能对照。
1. 同一模型,改变求解层次#
使用相空间例相同的Si晶胞、质量、3³网格和300 K,同时提供真实二、三、四阶力常数。输入目录为inputs/cases/mixed-iteration/:
¶meters
T=300, scalebroad=1
maxiter=200, eps=1e-6
num_sample_process_3ph=-1
num_sample_process_3ph_phase_space=-1
num_sample_process_4ph=-1
num_sample_process_4ph_phase_space=-1
&end
&flags
onlyharmonic=.false.
four_phonon=.true.
convergence=.true.
four_phonon_iteration=.false.
isotopes=.false., autoisotopes=.false.
nonanalytic=.false., espresso=.false., tdep=.false.
nanowires=.false.
&end
| 开关组合 | 含义 |
|---|---|
| convergence=false,four_phonon=true | 三、四声子均RTA |
| convergence=true,four_phonon_iteration=false | 本例:三声子迭代,四声子RTA |
| convergence=true,four_phonon_iteration=true | 完整三、四声子迭代,另见求解选项 |
不同方法的比较必须匹配质量、同位素、力常数、网格和展宽。其他篇中质量28.085 u的表不能直接当成本文28.0855099896 u条件的严格逐值对照。
2. 提交与读取迭代#
sbatch job.slurm
tail -n 18 cases/mixed-iteration/native.log
cat cases/mixed-iteration/T300K/BTE.kappa_tensor
本包的一次提交也运行三个很短的相空间目录;它们与本目录输出分别保存。要单独学习混合求解,在自己的干净目录复制这个CONTROL及三份力常数,再使用相同CPU批处理资源设置运行。
head results/mixed-iteration.csv
原生张量文件首列为迭代序号,后9列为完整3×3张量的Fortran列优先顺序。不要只按每行前3个数字就称它们是xx、yy、zz;对角分量位于张量展开后的第1、5、9项。
3. 实际结果#
本例RTA初始κxx=24.05554822 W/(m·K),第9次迭代为18.97520617 W/(m·K),最后原生相对变化9.88064×10⁻⁸,低于设置的1E-6,且没有达到maxiter=200上限。完整初始张量及基础三、四声子散射率与同一模型已有RTA数据对应。
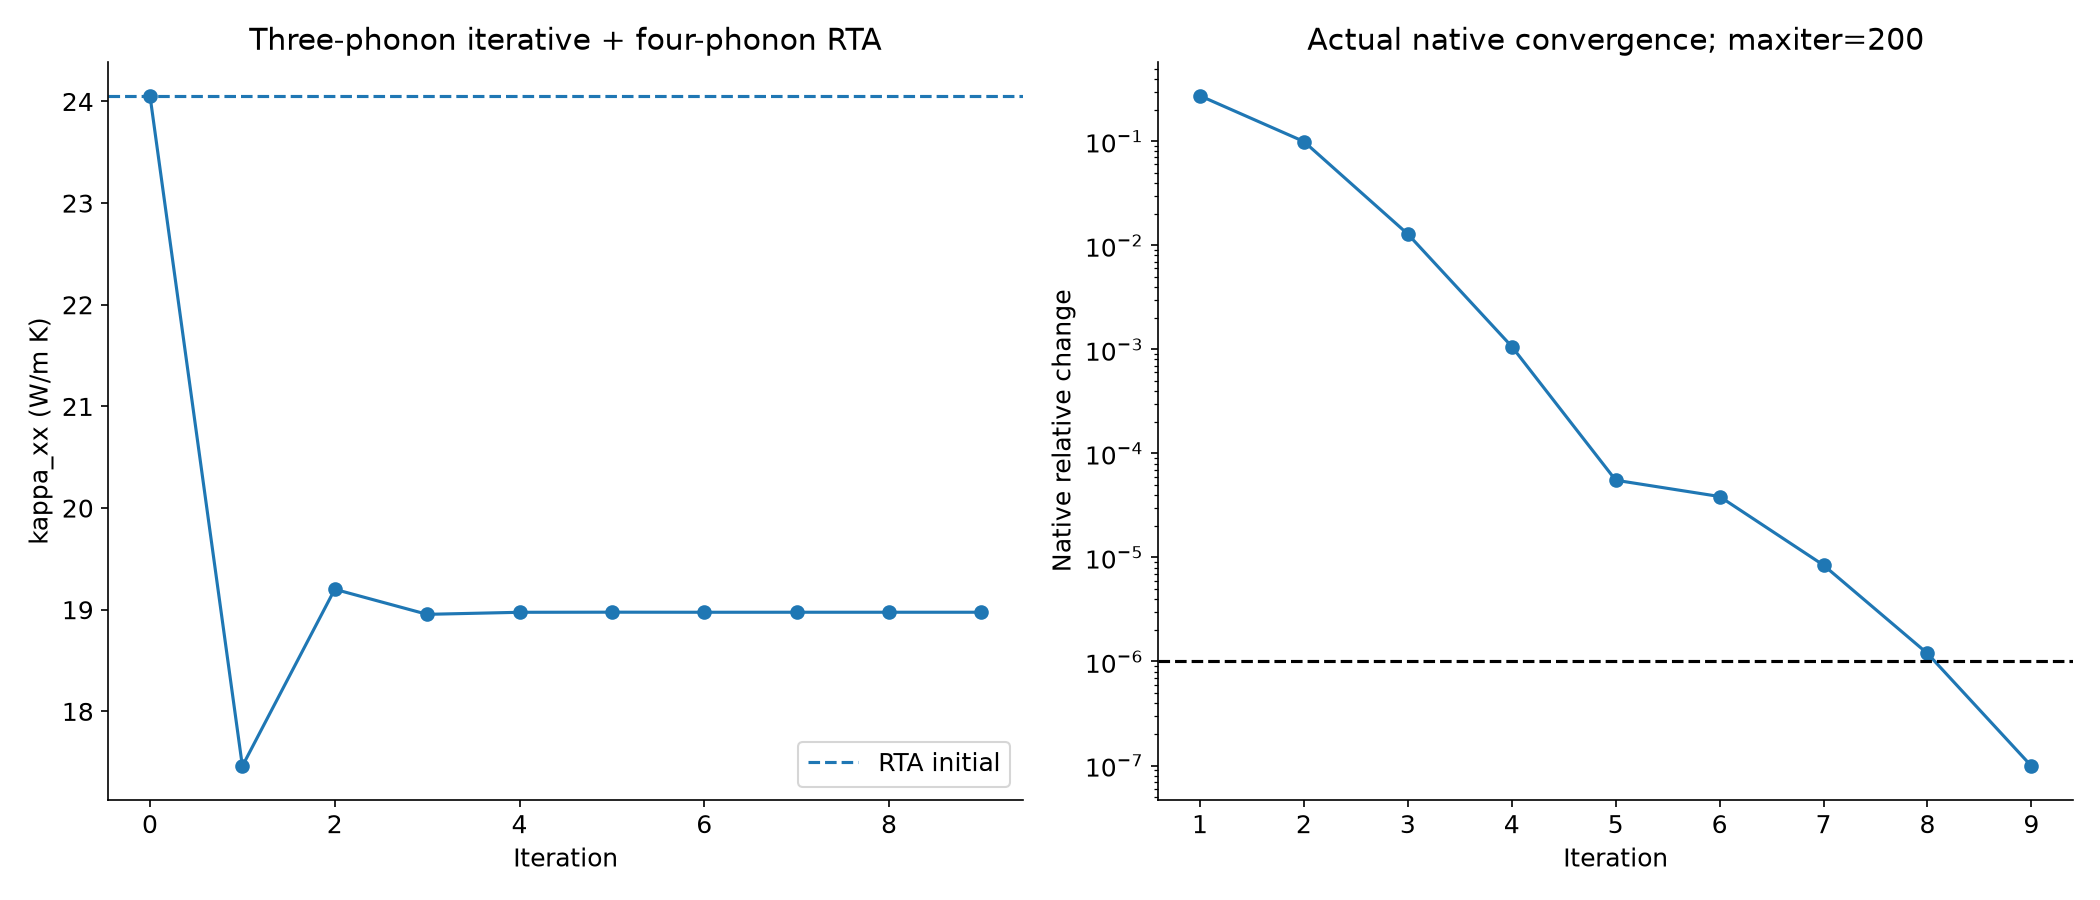
这里的变化来自求解方法,不能写成简单“四声子使热导降低多少”而忽略迭代近似。3³网格只用于快速学习;q网格、力常数与展宽收敛分别检查。
4. 抽样与迭代不要混配#
当前安装版对迭代所需的散射矩阵要求完整过程计数:三声子迭代时,num_sample_process_3ph及num_sample_process_3ph_phase_space保持−1;完整四声子迭代时,相应四声子两项也保持−1。不要为通过输入检查而把不匹配的条件隐藏在旧输出目录里。
本例采用CPU原生求解;已有GPU接口的逐模定量差异仍需按GPU与工具适用范围处理,不能用这里的CPU结果替代GPU科学结果。