
DP-GEN结果归档与数据库JSON
将三条实际Si2轨迹的15帧存成Entry对象,读取能量、力、维里和实际晶胞,并规范赝势元数据。
阅读本篇目录
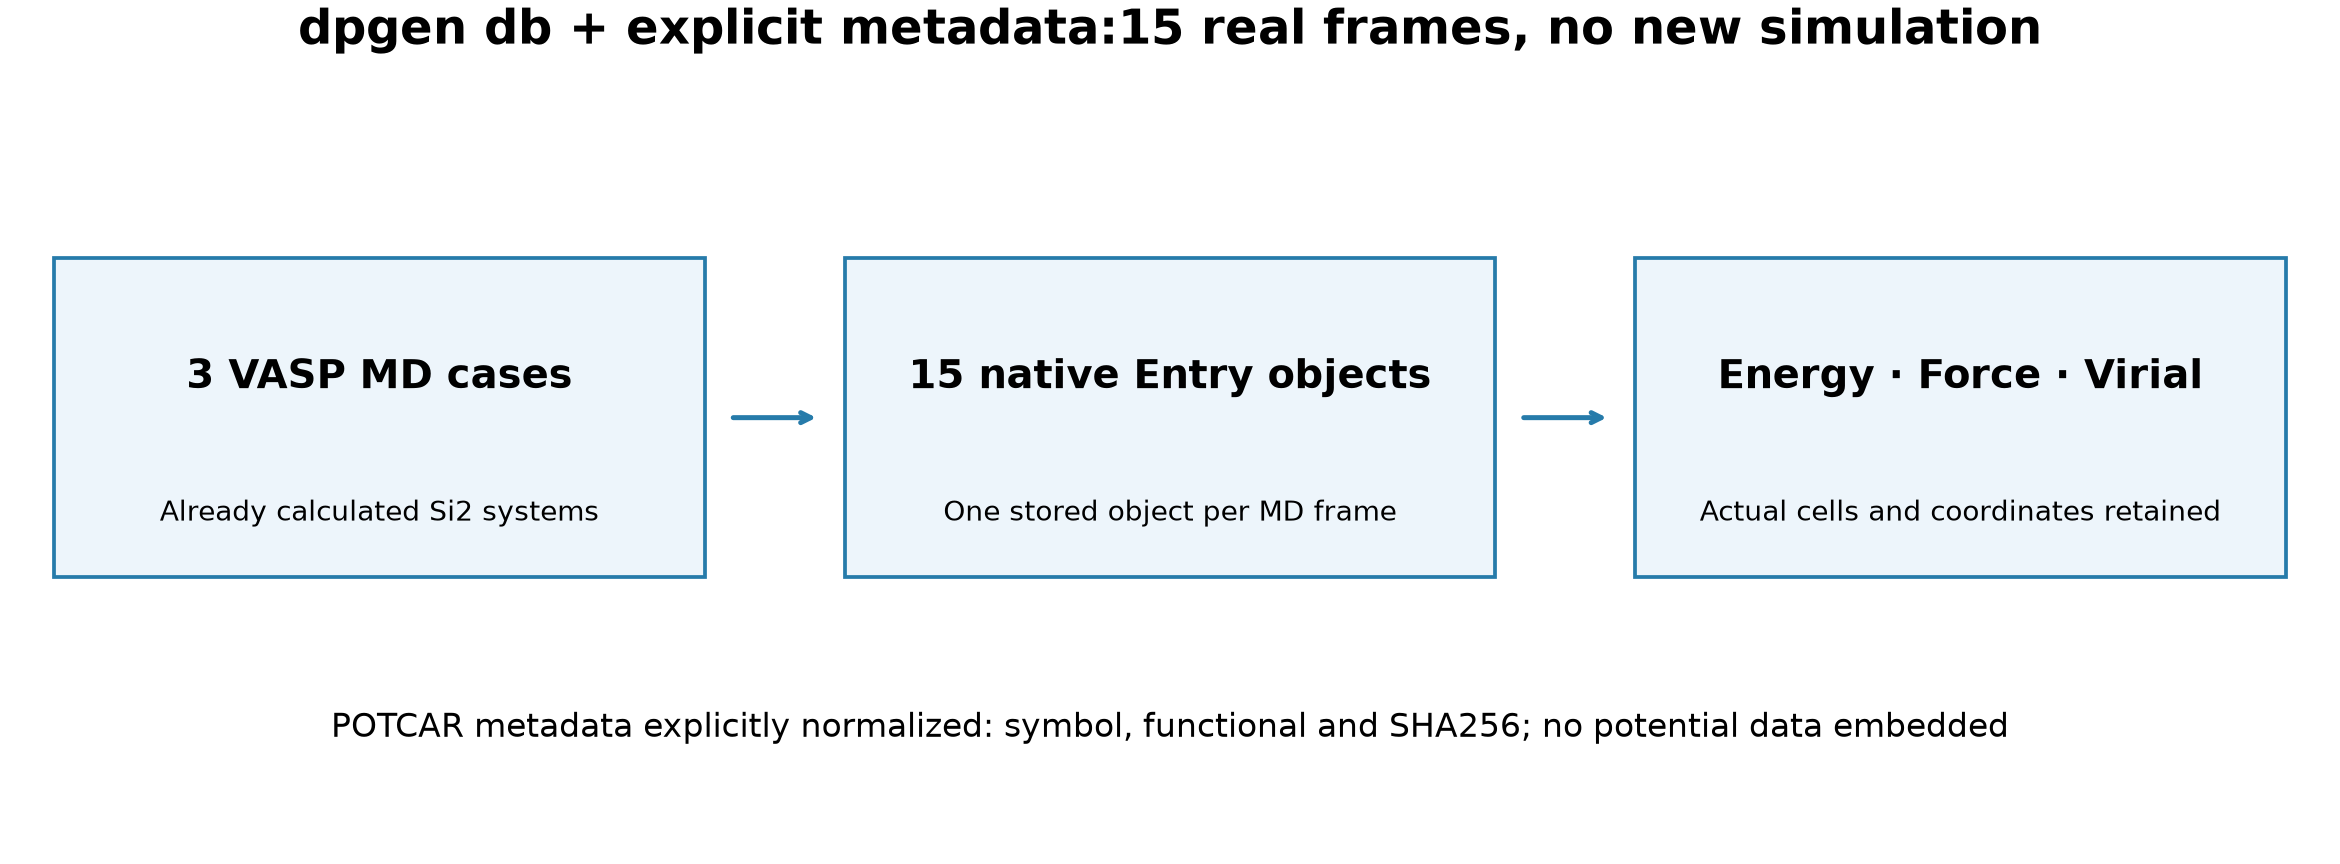
计算结束后,如果希望把参数、结构组成和逐帧标签一起归档,可以使用dpgen db。本篇从鸢算科技已经完成的3条Si₂短AIMD中提取15个Entry对象,整个归档过程不重新运行VASP或训练模型。
1 下载并直接读取参考结果#
下载数据库实例包,保存为dpgen-database.zip。
python3 -m zipfile -e dpgen-database.zip .
cd dpgen-database
bash read.sh
参考JSON在reference/,read.sh无需POTCAR即可查看15条数据。使用DP-GEN0.14.0、Python3.12、现有dpdata与Monty依赖;纯Python读取和归档只需CPU。
2 看清输入与输出路径#
cat database.json
{
  "calculator": "vasp",
  "path": "job",
  "output": "Si2-database.json",
  "config_info_dict": {"Si": [0]},
  "id_prefix": "YS-Si2",
  "skip_init": false
}
本例读取job/init/Si-init/02.md/sys-0002/scale-1.000/下的3套MD输出,每套5帧。skip_init=false包含初始数据;id_prefix用于生成唯一Entry编号。收集多个项目时应使用不同前缀,不能只靠同名文件判断数据唯一性。原生命令按目录遍历顺序编号,换目录重新归档后,顺序及编号与具体帧的对应关系可能变化;匹配样本时应同时核对来源、坐标和标签,不只按行号。附件CSV与reference/中的参考JSON对应。
3 从原始结果重新归档#
bash run.sh
这一步在自己的目录准备匹配的授权Si POTCAR,然后执行:
module load dpgen/0.14.0
dpgen db database.json
原生输出保留为Si2-database.json,再由明确的元数据整理脚本另存Si2-database-normalized.json。两份JSON的15个Entry编号、结构组成、晶胞、坐标、能量、原子力与维里完全保持;只规范本例赝势的说明字段。
4 为什么要单独检查赝势元数据#
本次版本组合的原生DPPotcar读取路径,会把某些合法POTCAR第二行的价电子数字误当作symbols,并留下空的旧式hashs字段。因此不要直接用这个字段判断元素或恢复赝势。
附件normalize_metadata.py针对本例Si₂,从真实授权POTCAR的TITEL、实际结构组成与完整文件SHA256记录Si、PBE和来源。原JSON保留,规范后的attribute.potcar_provenance保存实际SHA256与原生字段说明;没有用SHA256冒充另一种header hash,也不改动任何科学标签。
自己的多元素计算应分别核对真实元素、赝势顺序和文件版本,不能直接把本例Si专用整理脚本复制到其他体系。数据库JSON只保存赝势说明,不包含完整授权POTCAR;不能靠JSON恢复许可文件。
5 在终端读取一帧#
source ./env.sh
python - <<'PYCODE'
import json
from monty.json import MontyDecoder
rows = json.load(open('reference/Si2-database-normalized.json'))
r = rows[0]
s = MontyDecoder().process_decoded(r['data'])
print(r['entry_id'], r['composition'])
print('总势能eV:', s['energies'][0])
print('力eV/Å:', s['forces'][0])
print('维里eV:', s['virials'][0])
print('本帧晶胞Å:', s['cells'][0])
PYCODE
实际有15条记录,每条含2个Si原子。data里的能量是总量,需比较每原子能量时再除以2;力单位eV/Å,维里eV,维里不是GPa压力。
6 输入结构与逐帧结构要分开看#
Entry的inputs.POSCAR表示这条MD任务的起始输入;同一条MD的五帧会共享这份起始参数。当前帧的坐标和晶胞在data里,不能拿固定起始晶胞替代每帧实际晶胞,也不能把第1帧的原子力配给第5帧结构。
这份归档的数据源是体相初始化实算,15帧仅为短流程示例,不是充分覆盖材料构型空间的生产训练集。
7 当前可用后端与后续处理#
当前0.14.0数据库命令实际使用VASP收集路径;源码中PWSCF与Gaussian数据库分支尚未实现。需要读取这两类输出时,使用dpdata电子结构输出或分子量化输出,再按自己的数据格式保存。
需要直接训练的数据目录时,另看DP-GEN数据收集与统计;JSON归档不会自动去重、重新划分训练/测试集或重新进行模型训练。
数值下载#
entries.csv。这些数值来自上述实际计算或逐帧归档,不额外启动计算。