
DP-GEN筛选阈值与真实误差
分清四模型分歧、DFT标签误差与训练验证误差,查看44次原生筛选评估和实际结构、学习曲线。
阅读本篇目录
本篇使用同一套Si数据筛选实例包。先按筛选实操解压并进入dpgen-simplify。模型彼此接近,不等于模型已经接近DFT。 选择阈值之前,应同时查看分歧和独立标签误差。
1 分歧筛选规则#
本例启用力分歧,单位eV/Å:
原生max_devi_f |
本例分类 | 后续处理 |
|---|---|---|
| 小于0.1 | accurate | 从本轮剩余池移出 |
| 大于等于0.1、小于2.0 | candidate | 随机选择最多8帧加入训练 |
| 大于等于2.0 | failed | 保留到剩余池,需要另查覆盖范围 |
能量和真实误差阈值在本例维持默认大值,不参与正常尺度下的选择;true_error文件仍保留原生计算结果用于比较。accurate是程序的阈值分类名称,不是材料计算精度的证明。
source env.sh
head -n 12 reference-data/Si-simplify-deviation.csv
自己新计算完成时可以直接查看原生文件:
head -n 12 iter.000001/01.model_devi/details
head -n 12 iter.000001/01.model_devi/true_error
本例3轮分别评估24、15、5个剩余样本,共44次评估;其中部分样本会进入多轮,不是44个不同DFT构型。
2 两个指标分别表示什么#
details中的力分歧先对四模型各力分量求标准差,再组成每原子的向量范数,最后取一帧中最大的原子值。true_error则把每个模型与真实DFT力相减,对模型维度求平方平均后开方,再取向量范数和帧内最大值。它不是四模型平均力误差,也不是整数据集力RMSE。
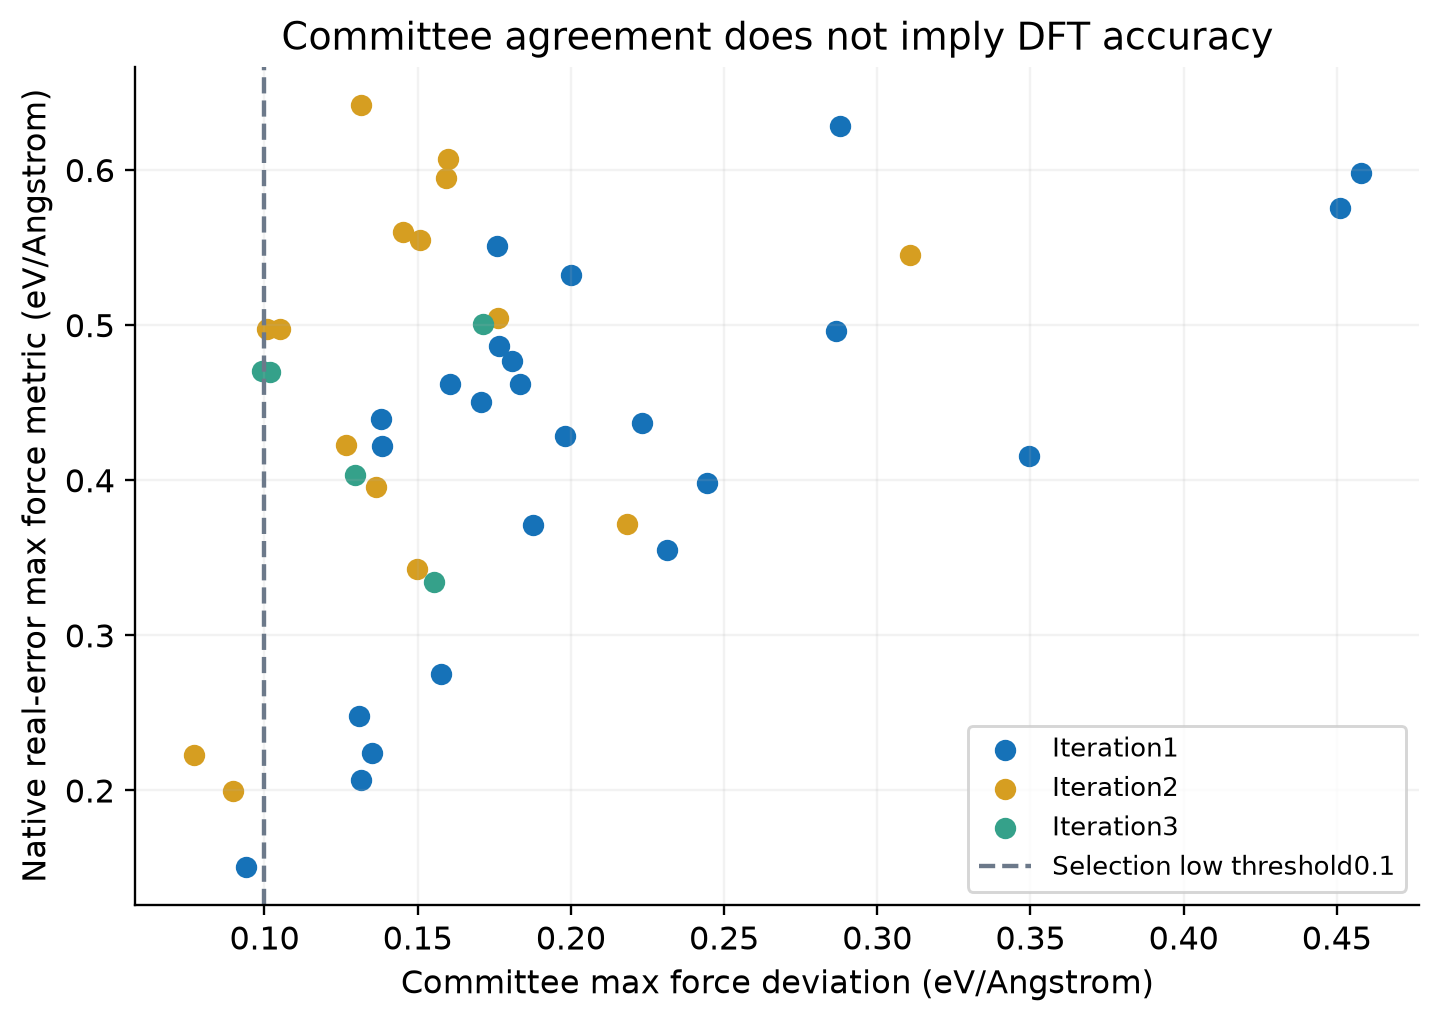
图中可看到低分歧仍可能对应可观的DFT误差。因此不能只降低筛选阈值,也不能仅看一条学习曲线就宣布训练完成。应结合验证集、测试集、结构覆盖、能量力精度和目标模拟稳定性。
3 结构与训练结果怎么读#
cat reference-structures/Si8.POSCAR
head -n 8 reference-data/lcurve-model0.out
cat reference-data/Si-simplify-rounds.csv
bash plot.sh
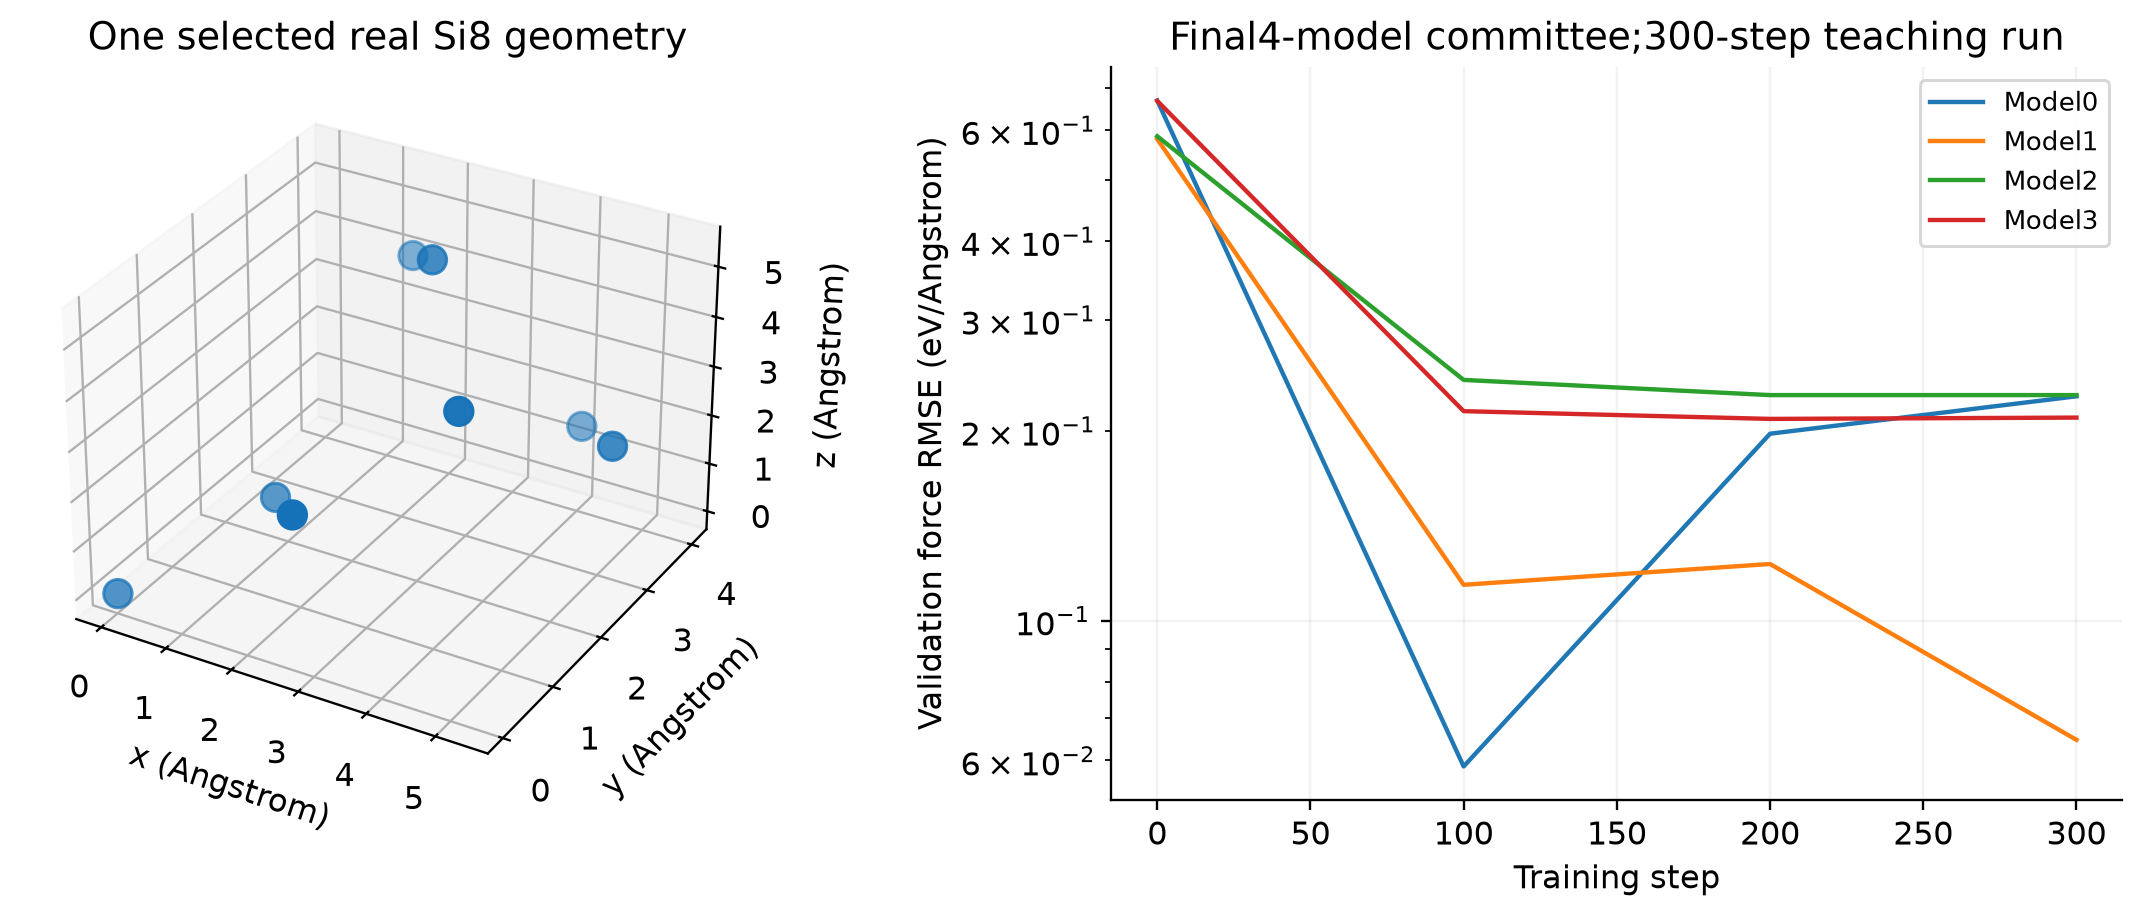
每个模型只训练300步,验证集8帧,主要展示命令和文件。图中的验证误差与用于选择的委员会分歧是两个量;验证数据没有进入待筛选32帧池。若改为自己的数据,应按原始结构来源划分训练/验证/测试,避免相同构型通过不同格式或重复导出混进各集合。
本包最终28帧不是Si全部温度、压力、缺陷和表面的完整训练库。需要进一步增加训练和覆盖时,按新的物理设置计算相应标签,再开展完整主动学习循环。
可下载逐轮分歧和误差CSV及已选构型索引CSV。指标定义参见DeePMD-kit官方模型分歧实现。