
DP-GEN数据收集与迭代统计
用32帧初始数据和4个真实VASP新标签,实操collect与run/report,核对组成、帧数和候选结构统计。
阅读本篇目录
完成一轮DP-GEN后,常见操作是收集可用于下一次训练的数据,并查看标注来自哪些系统与温压条件。收集不是重新计算,也不会自动去重或重新划分测试集。 本篇使用鸢算科技已完成的Si主动学习流程,直接操作真实数据和阶段输出。
1 下载实例#
下载DP-GEN数据工具实例包,保存为dpgen-data-tools.zip。
python3 -m zipfile -e dpgen-data-tools.zip .
cd dpgen-data-tools
附件使用DP-GEN0.14.0、Python3.12及其现有dpdata依赖,run.sh自动加载模块。收集和统计只读已有结果;本包不训练模型,不运行LAMMPS或VASP,不需要GPU。较大数据处理可使用1CPU批作业,例如sbatch job.slurm collect。
2 先看要收集的目录#
job/
  initial/Si2/                  16帧,2原子
  initial/Si8/                  16帧,8原子
  iter.000000/02.fp/data.000/Si8/ 4帧新VASP标签
  param.json
每组DeepMD数据保留type.raw、type_map.raw与set.000/*.npy,包括晶胞、坐标、能量、力与维里。param.json在本包中仅保留收集/统计需要的字段,不是完整主动学习输入。
{
  "type_map": ["Si"],
  "init_data_prefix": "initial",
  "init_data_sys": ["Si2", "Si8"],
  "sys_configs_prefix": ".",
  "sys_configs": [["Si8.POSCAR"]]
}
迭代目录的数量还由完整附件中的model_devi_jobs配置决定;不要把上面的阅读摘要直接覆盖原任务参数。
3 一条命令收集#
bash run.sh collect
实际调用的是:
module load dpgen/0.14.0
dpgen collect job collected -m -v
本例得到三组目录:
| 输出 | 原子数 | 帧数 | 来源 |
|---|---|---|---|
collected/init.000 |
2 | 16 | 初始Si2 |
collected/init.001 |
8 | 16 | 初始Si8 |
collected/sys.Si8 |
8 | 4 | 第0轮新增VASP标签 |
总计36帧,初始数据与新增标签分别保存。-m按化学式归并迭代数据,-v打印数量;它不会把不同原子数的Si2和Si8强行塞成同一个固定原子数数组,也不会将初始数据自动并入新增目录。
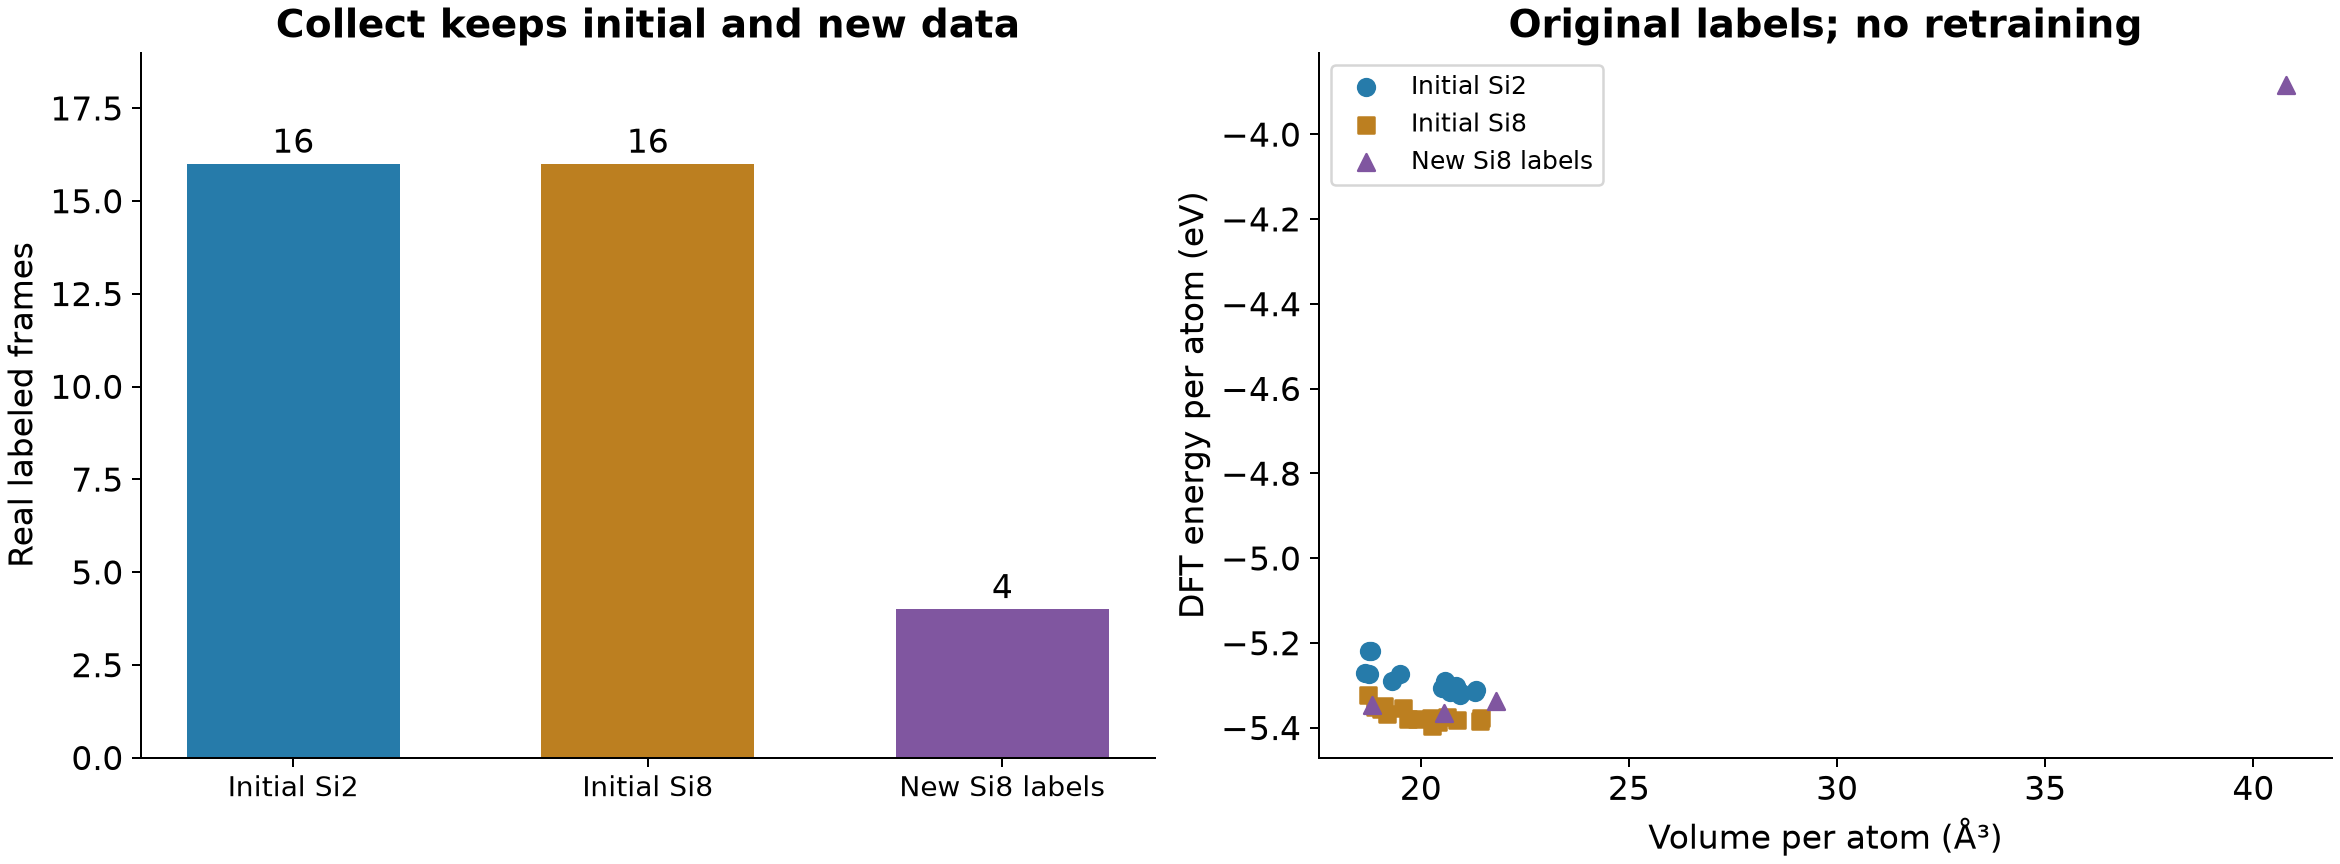
图中每原子能量与体积由原始总量除以原子数得到,仅展示本例数据分布,不是新做的状态方程拟合或模型误差测试。
4 检查能量、力和元素#
import dpdata
s = dpdata.LabeledSystem('collected/sys.Si8', fmt='deepmd/npy')
print(len(s), s.get_natoms(), s['atom_names'])
print(s['energies'].shape, s['forces'].shape, s['virials'].shape)
本例对应4帧、8原子,能量形状(4,)、力(4,8,3)、维里(4,3,3)。检查类型顺序与原单位,不因为文件合并成功就混入不同赝势、泛函或能量零点的数据。
不希望按化学式归并时,可执行dpgen collect job collected-separate。当前0.14.0对data.000/Si8这类多体系目录的非合并详细打印有类型索引限制;这条路径先不加-v,需要详细数量时优先使用上面的-m -v。
5 查看系统与迭代统计#
bash run.sh report
对应原生命令可分别使用:
dpgen run/report job -s -v
dpgen run/report job -i -v
-s按系统及探索温压条件统计已选择的标注任务;-i查看候选、准确、偏差过大及第一性原理输出等计数。本例来自300/600 K与0/10000 bar的四个短探索条件,完成4个新VASP标注。具体选中数量为300 K/0 bar 1个、300 K/10000 bar 1个、600 K/10000 bar 2个;600 K/0 bar本轮没有选中标注,不代表这个探索条件没有运行。
迭代统计实际为35个候选帧、9个偏差过大帧、0个准确帧,共44个受检轨迹帧;其中最终选出4个做VASP标注。短流程的委员会尚不成熟,这些分类不是材料势的泛化精度。
统计的是目录里的任务和输出,不是材料势的准确率。候选结构数量、最终成功标注数量和训练集帧数可以不同;尤其初始训练数据也在收集结果中时,不能把36帧解释成“本轮新算36次”。
6 保留任务关联,再整理数据#
原生统计会沿conf.dump关联到探索轨迹和input.lammps。附件setup.py在当前解压目录内恢复这些相对链接,run.sh自动调用;不要仅复制四个OUTCAR后期待系统/温压统计仍完整。
重复收集时使用新的输出目录,并独立保留测试数据。-s/--shuffle只是打乱数据顺序,不会去重,也不会保证按原始构型分组划分训练、验证和测试。
下一步参阅参数骨架生成或训练、探索与再训练。官方运行与参数说明可用于检查自己的完整配置。
图表数据与重新绘图#
bash plot.sh
图件保存在plots/,原数值另存于附件reference-data/。直接下载:Initial-Si2.csv、Initial-Si8.csv、New-Si8-labels.csv、generated-job-temperatures.csv、generated-system-groups.csv。