
ABACUS NEP:MPI进程与邻居缓冲设置
以同一64Si初态和速度对比1、2、4进程,给出当前beta版邻居缓冲的实际使用限制。
阅读本篇目录
MPI进程数改变的是并行分工,不应该改变同一初态的力和轨迹。本篇使用已经实际写出的64Si第0步结构及速度,运行1、2、4进程的短NVE。本文固定md_neighbor_skin 0,不推荐在这个固定beta版本中启用非零缓冲。
unzip abacus-NEP-parallel-wave676-*.zip
cd abacus-NEP-parallel
bash results.sh
bash plot.sh
以上两步读取本集群已完成的参考数据并重绘,不启动计算。inputs/存放完整输入,reference-data/是参考表,新计算写入work/,新提取表写入results/。每个资料包都附独立环境的编译脚本;已有本篇环境时可复用,无需反复编译。
运行前先按NEP独立环境编译本地工具链。若工具链已在相邻的abacus-beta10-NEP目录中:
bash use-toolchain.sh ../abacus-beta10-NEP/toolchain/install
sbatch job.slurm
第一套资料包本身使用自己的toolchain/install,无需再选择路径。脚本申请cpu-8173m的56核独占整节点;本例内部按需要使用1、2或4个MPI进程,仍按整节点计费。CPU资源暂不可用时可以先看参考数据,待可用后提交。本文结果不作为CPU节点性能测试。
本组统一使用固定ABACUS 3.11.0-beta10(源码提交40e7ce8c575abb2ae7fc0df1bd6ec4b48a695d2d)和NEP_CPU 629ec5d,oneAPI 2024.2的icx/icpx/ifx、Intel MPI 2021.13、顺序MKL 2024.2,面向AVX512 CPU。此独立构建启用PW和NEP_CPU,关闭LCAO、ELPA、LibRI、Libxc、MLALGO、CUDA和OpenMP;不是覆盖全部电子结构功能的通用构建。公共ABACUS 3.10.1模块不提供这里使用的新接口。
1. 使用相同结构和速度#
head -n 24 inputs/mpi1-skin0/STRU
cat inputs/mpi1-skin0/INPUT
完整INPUT为:
INPUT_PARAMETERS
suffix nep
calculation md
esolver_type nep
pot_file nep.txt
ntype 1
basis_type pw
cal_force 1
cal_stress 1
md_type nve
md_nstep 21
md_dt 0.5
init_vel 1
md_tfirst -1
md_tlast -1
md_dumpfreq 1
md_restartfreq 0
md_out_force 0
dump_force 1
dump_vel 1
md_neighbor_skin 0
这里是从带速度STRU启动一个短对照,不是读取完整MD检查点的续算。文件中v后的速度为ABACUS结构格式的原子单位;不要直接把轨迹中Å/fs数值未经转换粘进去。init_vel 1避免每个并行例重新生成随机速度。
2. 一次提交三个MPI例子#
sbatch job.slurm
cat results/MPI-consistency.csv
配套脚本在同一CPU分配内顺序调用mpirun -np 1、-np 2、-np 4,各生成21帧,编号0–20、最后10 fs。运行前各目录来自同一组初始文件;结果按全局原子编号排序后比较,避免把并行输出顺序误认成原子运动差异。
| 相对1进程 | 最大坐标差 / Å | 最大力差 / eV·Å⁻¹ | 最大应力差 / kbar |
|---|---|---|---|
| 2进程,skin=0 | 0 | 约1.00×10⁻¹² | 约1.00×10⁻¹² |
| 4进程,skin=0 | 0 | 约1.00×10⁻¹² | 约1.00×10⁻¹² |
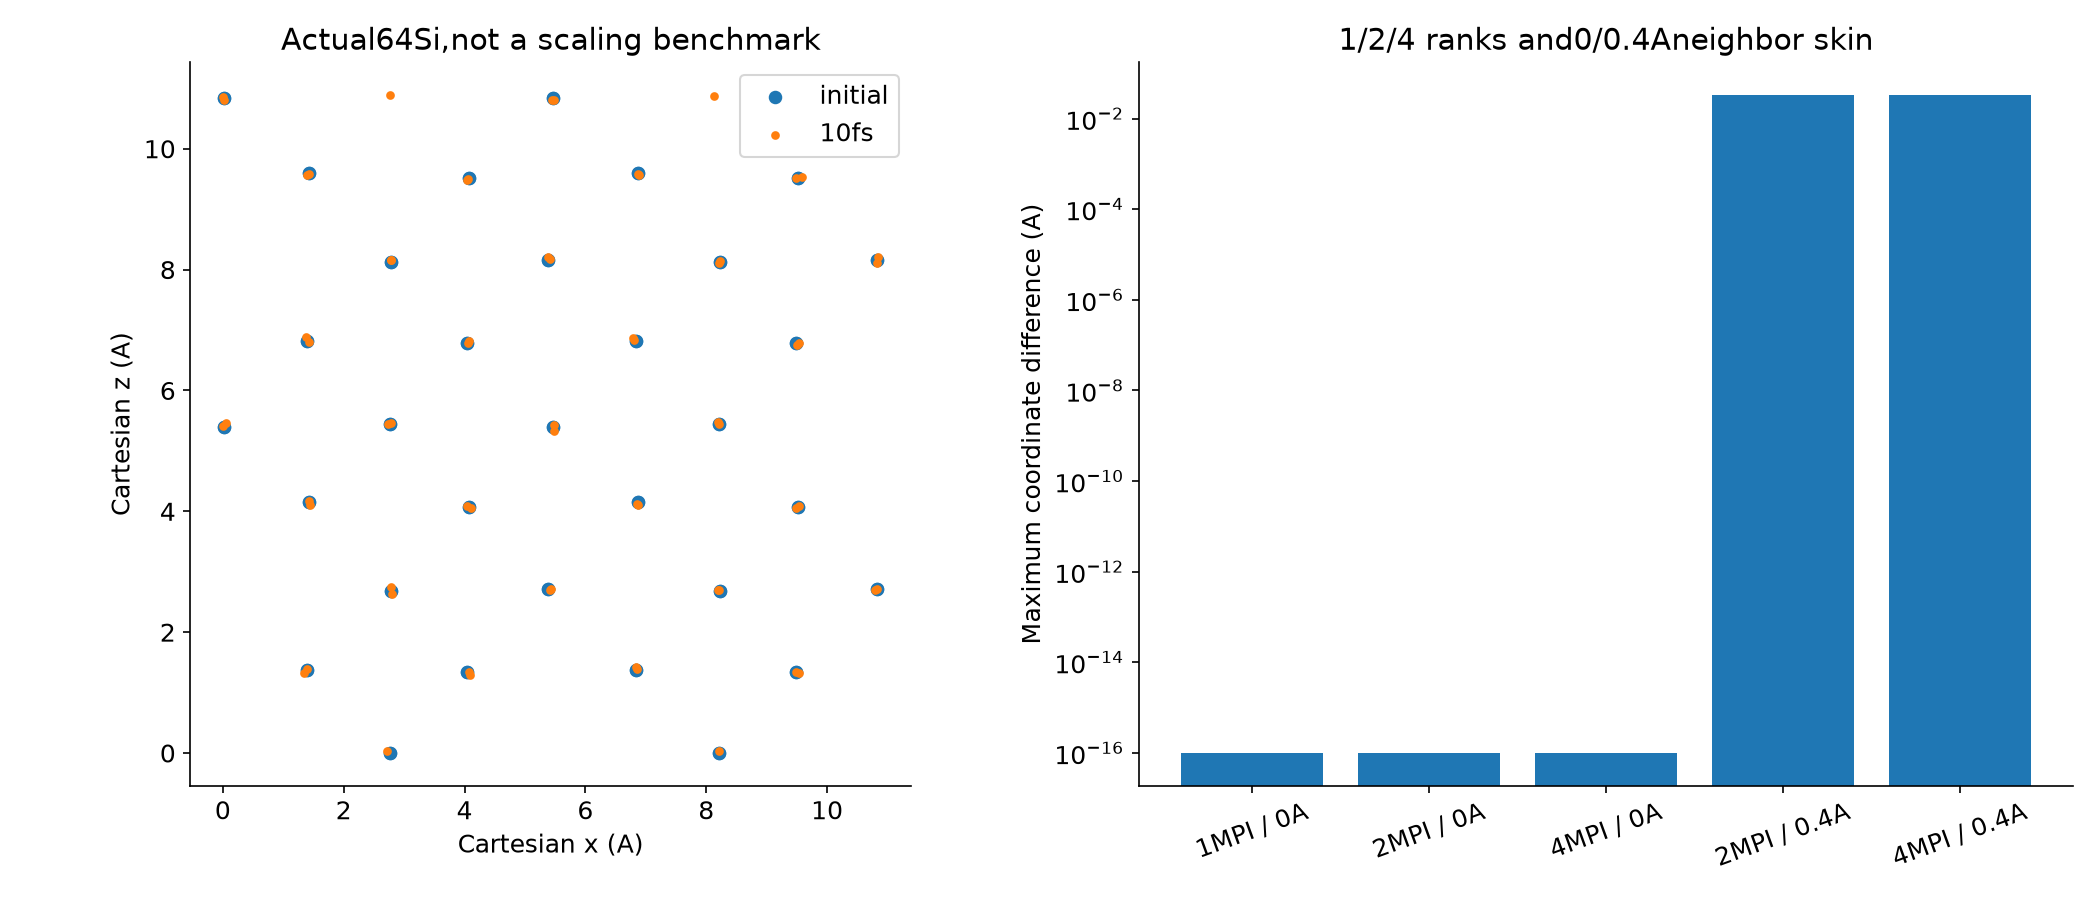
速度与输出势能也一致。体系很小、轨迹很短,这些数据不能用来判断增加进程能加速多少,也不能代替大体系并行效率测试。
3. 为什么这里坚持skin=0#
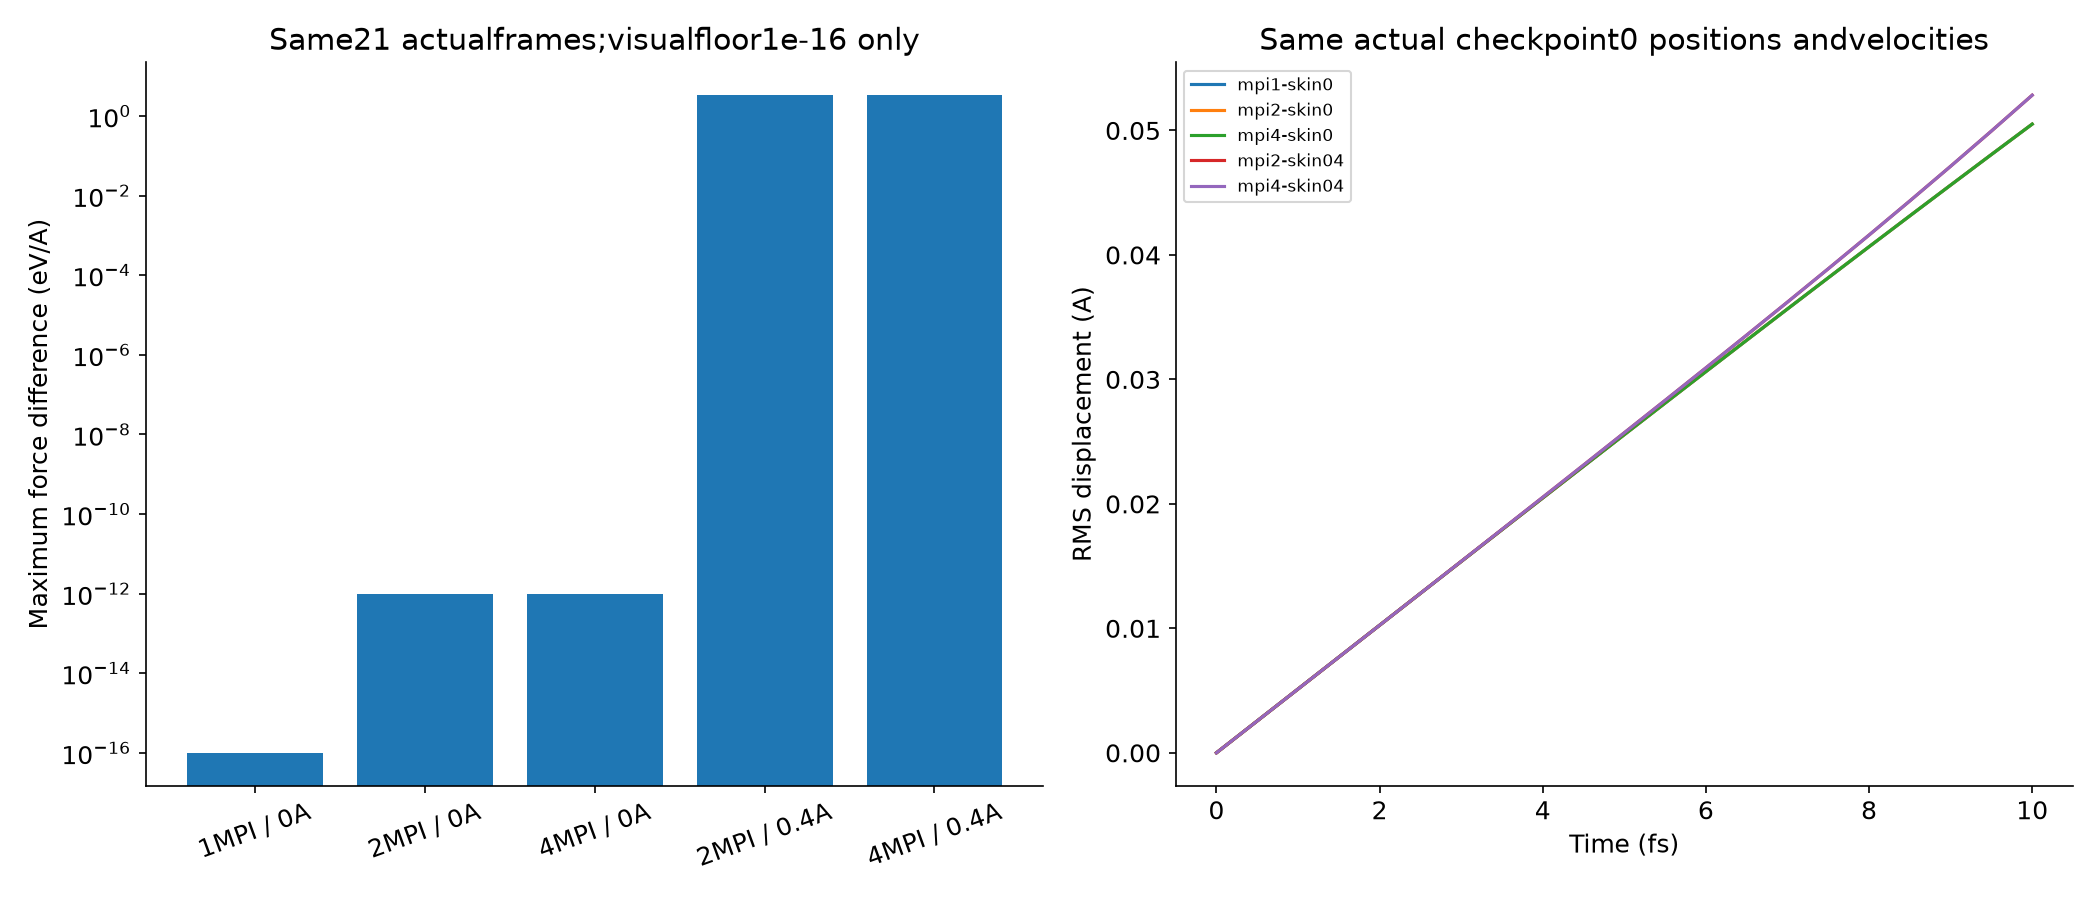
通常邻居缓冲只应影响重建频率,不应改变势函数结果。但在固定ABACUS beta10与NEP_CPU组合中,本组另外两个0.4 Å缓冲条件出现明显差异:相对无缓冲的最大力差约3.325 eV/Å,最大坐标差约0.03273 Å,最大应力差约37.20 kbar,最大势能差约0.6799 eV/atom。
这是同一输入在当前版本下的实测不一致,不应归结为正常浮点末位误差,也不是“加缓冲就更准”。资料包的新计算默认只包含通过对照的skin=0条件;参考表和图保留非零缓冲差异,供选择设置时了解限制。本文没有测量邻居重建次数,不据此宣称原因已完全定位。
cat reference-data/ABACUS-NEP-MPI-neighbor-consistency.csv
head reference-data/ABACUS-NEP-MPI-displacements.csv
换新版程序、更新NEP_CPU或调整邻居实现后,应先用同初态单点/短轨迹再检查,再考虑开启邻居缓冲。普通使用者当前照本文保持md_neighbor_skin 0即可,不需要修改公共源码来完成本组算例。