
ABACUS NEP:单点能量、力与GPUMD对照
用同一个Si NEP4模型计算四个结构,并与P100和V10016G上的GPUMD原生预测逐项对照。
阅读本篇目录
本篇解决“同一个nep.txt能否在ABACUS中直接使用,能量与力在哪里看”。实际对象是2个Si₂和2个Si₈构型,共20个原子;结构和模型来自本集群已有DFT训练实例。本次只做固定模型预测,没有新增DFT或重新训练,也不把两套程序一致理解为模型对真实材料已足够准确。
unzip abacus-beta10-NEP-wave674-*.zip
cd abacus-beta10-NEP
bash results.sh
bash plot.sh
以上两步读取本集群已完成的参考数据并重绘,不启动计算。inputs/存放完整输入,reference-data/是参考表,新计算写入work/,新提取表写入results/。每个资料包都附独立环境的编译脚本;已有本篇环境时可复用,无需反复编译。
运行前先按NEP独立环境编译本地工具链。若工具链已在相邻的abacus-beta10-NEP目录中:
bash use-toolchain.sh ../abacus-beta10-NEP/toolchain/install
sbatch job.slurm
第一套资料包本身使用自己的toolchain/install,无需再选择路径。脚本申请cpu-8173m的56核独占整节点;本例内部按需要使用1、2或4个MPI进程,仍按整节点计费。CPU资源暂不可用时可以先看参考数据,待可用后提交。本文结果不作为CPU节点性能测试。
本组统一使用固定ABACUS 3.11.0-beta10(源码提交40e7ce8c575abb2ae7fc0df1bd6ec4b48a695d2d)和NEP_CPU 629ec5d,oneAPI 2024.2的icx/icpx/ifx、Intel MPI 2021.13、顺序MKL 2024.2,面向AVX512 CPU。此独立构建启用PW和NEP_CPU,关闭LCAO、ELPA、LibRI、Libxc、MLALGO、CUDA和OpenMP;不是覆盖全部电子结构功能的通用构建。公共ABACUS 3.10.1模块不提供这里使用的新接口。
1. 先看完整INPUT与STRU#
cat inputs/abacus-static/Si8-case2/INPUT
head -n 8 inputs/abacus-static/Si8-case2/nep.txt
INPUT_PARAMETERS
suffix nep
calculation scf
esolver_type nep
pot_file nep.txt
ntype 1
basis_type pw
cal_force 1
cal_stress 1
symmetry -1
这里的calculation scf是单点入口名称,真正的求值器由esolver_type nep决定;日志即使出现通用自洽标题,也不代表在做Kohn–Sham迭代。这种NEP计算不需要KPOINTS、赝势UPF或NAO轨道文件。
Si₈的完整结构为:
ATOMIC_SPECIES
Si 28.085 Si.unused

LATTICE_CONSTANT
1.8897268777743552

LATTICE_VECTORS
5.444365970000000 0.000000000000000 0.000000000000000
0.000000000000000 5.444365970000000 0.000000000000000
0.000000000000000 0.000000000000000 5.444365970000000

ATOMIC_POSITIONS
Direct
Si
0
8
0.004707510505581 0.996712320571646 0.991658999367377 1 1 1
0.255380519542848 0.255503119677313 0.252242319411897 1 1 1
0.989199370445701 0.500246909375198 0.497347339418478 1 1 1
0.260402990506533 0.746196799110476 0.763255250087459 1 1 1
0.512183599590018 0.998030000176494 0.492284970328694 1 1 1
0.749118720613853 0.247150260914587 0.747941799364380 1 1 1
0.508055030694419 0.487309020851881 0.000631930332927 1 1 1
0.742291310369057 0.755523069658743 0.246487669527477 1 1 1
LATTICE_CONSTANT以Bohr计;这里设置成约1 Å对应的Bohr值,后面的晶格向量给出边长约5.444366 Å的立方胞。Direct下面是分数坐标,末尾1 1 1是位置自由度标记。Si.unused只是物种行占位名称,这个NEP入口不读取对应赝势文件,不能照搬到DFT计算。
2. 提交并提取#
sbatch job.slurm
cat results/singlepoint.csv
grep FINAL_ETOT_IS work/abacus-static/Si8-case2/OUT.nep/running_scf.log
grep -A12 TOTAL-FORCE work/abacus-static/Si8-case2/OUT.nep/running_scf.log
job.slurm完成后才会生成results/。Si₈ case2的总能量为 −42.7414665538863 eV,除以8得到 −5.34268331923579 eV/atom。力直接从TOTAL-FORCE (eV/Angstrom)读取,不能再次按原子数相除。
| 构型 | 原子数 | ABACUS能量 / eV·atom⁻¹ | GPUMD表中能量 / eV·atom⁻¹ |
|---|---|---|---|
| Si2-case0 | 2 | −5.35230094515113 | −5.35230 |
| Si2-case1 | 2 | −5.35246619001273 | −5.35247 |
| Si8-case2 | 8 | −5.34268331923579 | −5.34268 |
| Si8-case3 | 8 | −5.34648163942091 | −5.34648 |
3. 在GPUMD中只预测,不训练#
资料包的inputs/gpumd-prediction/含同一模型和四个构型,以及匹配架构的nep.in:
cat inputs/gpumd-prediction/nep.in
type 1 Si
version 4
cutoff 4.5 4.0
n_max 4 4
basis_size 4 4
l_max 4 2 0
neuron 20
prediction 1
不能只写prediction 1后让其余设置都取默认值;截断、基组和网络宽度应与模型一致。完整文件中的训练相关条目不使prediction 1变成重新训练。
可把以下脚本保存为predict.slurm,在资料包目录提交。这里示例选P100;换V10016G时同步改分区、GRES和模块后缀。
cat > predict.slurm <<'EOF'
#!/bin/bash
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=1
#SBATCH --gres=gpu:p100-16g:1
#SBATCH --time=00:10:00
#SBATCH --output=predict-%j.log
set -e
cd "$SLURM_SUBMIT_DIR"
source /etc/profile
source /public/slurm_scripts/.runtime/2026-10-14/module-reset.sh
module load gpumd/5.9.1-p100
export OMP_NUM_THREADS=1
 test ! -e prediction
cp -r inputs/gpumd-prediction prediction
cd prediction
nep
EOF
sbatch predict.slurm
GPUMD 5.9.1 GPU版编译环境为GCC 13.3、CUDA 12.9。原生nep直接运行,使用Slurm分配的一张GPU,不在命令前额外加mpirun。本篇已经在P100和V10016G上实际执行相同预测。
head prediction/energy_train.out
head prediction/force_train.out
head prediction/virial_train.out
energy_train.out前列是预测能量/原子,后列是原数据中的参考值;force_train.out前三列是预测xyz力,四个构型的原子依次排列;virial_train.out前六列是预测维里/原子,顺序为xx、yy、zz、xy、yz、zx。比较总维里时要乘对应原子数,详见单位与有限差分。
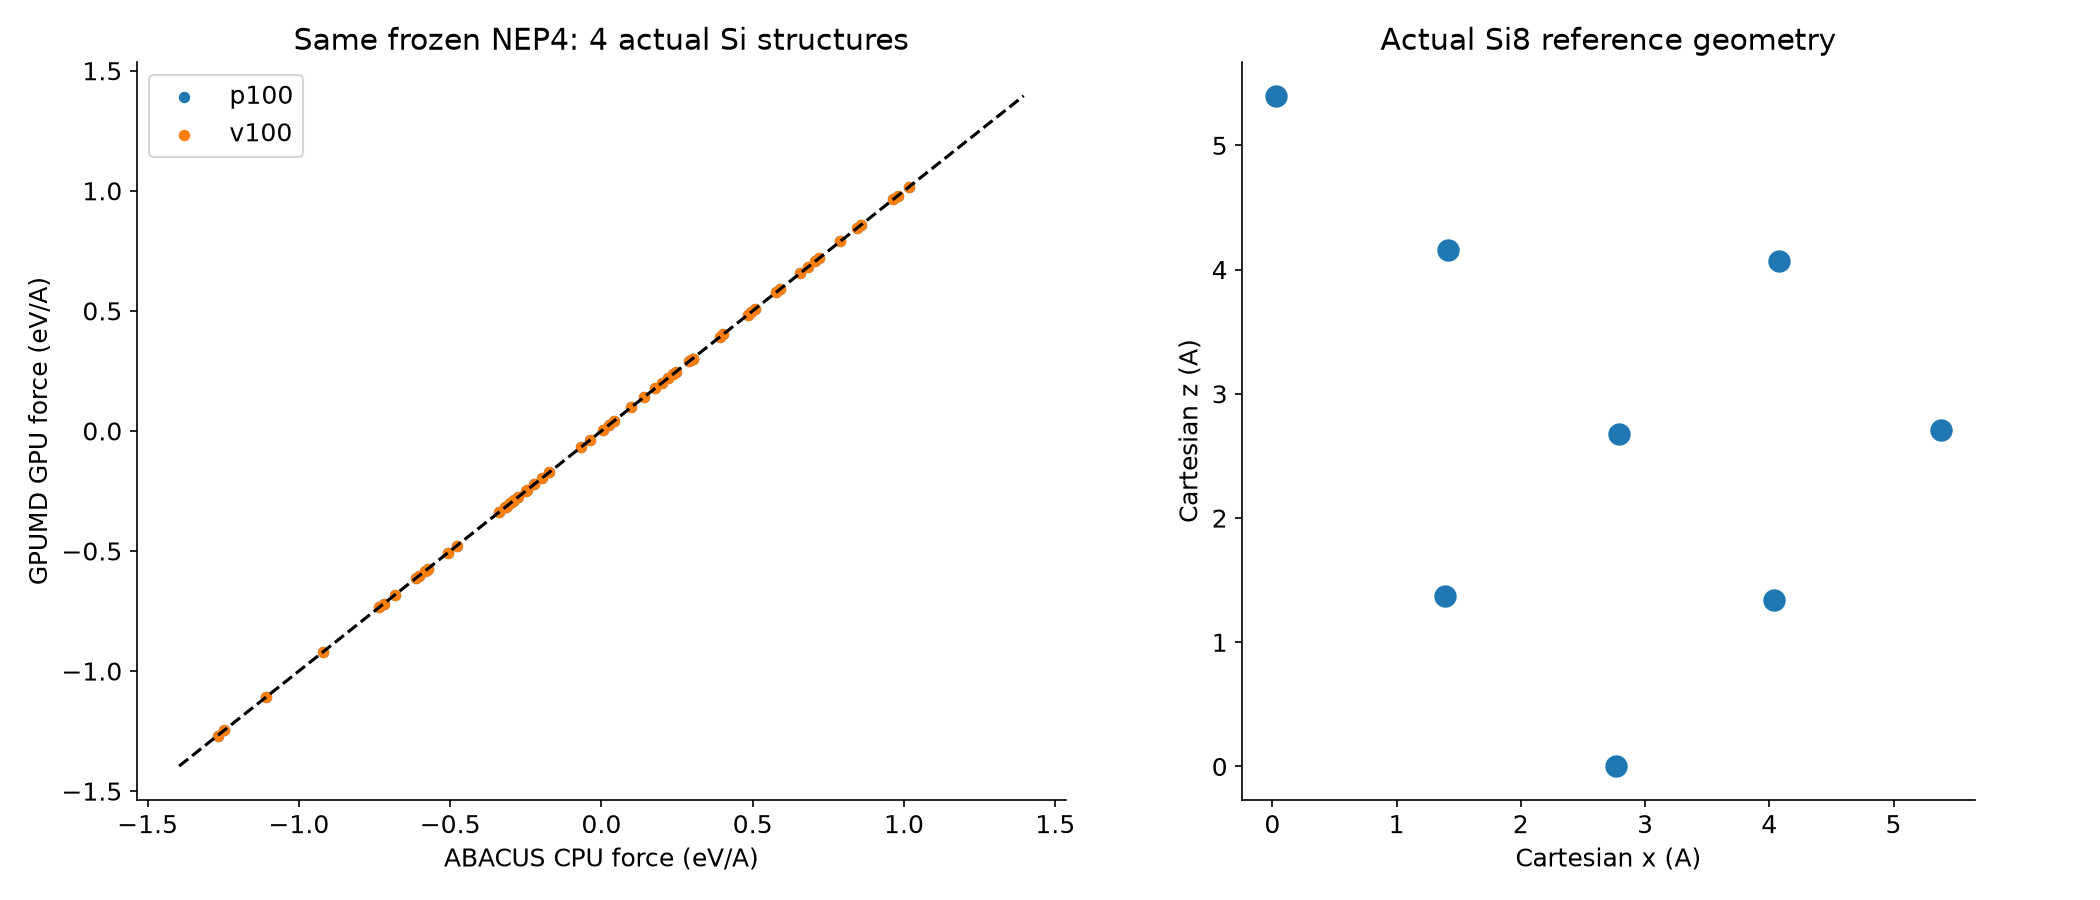
按已打印输出的精度比较,最大能量差为3.81×10⁻⁶ eV/atom,最大力差9.91×10⁻⁶ eV/Å,最大总维里差1.38×10⁻⁵ eV。有限打印位数及程序单位常数取值会造成末位差异;这是一致性示例,不是GPU速度排名或新的DFT精度证明。