
DeePKS:单卡训练与CPU模型导出
复用已有水分子标签,在P100或V100 16G训练DeePKS,并导出CPU ABACUS可读的TorchScript模型。
阅读本篇目录
DeePKS训练教程已经介绍描述符、能量单位和六训练/两留出构型。本篇复用同一组实际DFT标签,把原生训练放到单张GPU上,再导出CPU模型,不重新计算DFT。
GPU只负责此处神经网络训练。后续ABACUS修正SCF仍使用独立ML环境的CPU求解器;不能因为训练用了GPU,就认为DFT求解也自动启用了GPU。
unzip abacus-deepks-gpu-wave686-*.zip
cd abacus-deepks-gpu
bash results.sh
bash plot.sh
以上只读取参考数据并重绘,不启动新计算。重新计算请使用新解压的目录。
1. 选择训练环境与查看数据#
先按ML环境教程准备一次固定DeePKS-kit与依赖,然后在本包目录:
bash use-toolchain.sh ../abacus-ml-env/toolchain
ls data/train
ls data/heldout
dm_eig.npy是描述符,energy.npy和e_base.npy是Hartree能量。本版ABACUS导出的能量已经是Hartree,不能沿用旧接口脚本再除以2。训练只有6个水分子几何,2个留出几何不参与拟合或停止条件;不代表覆盖液态水或化学反应。
2. 选一张卡提交#
P100:
sbatch p100.slurm
V100 16G:
sbatch v100.slurm
一个解压目录只选一种执行。想比较两种设备,复制为两个独立目录分别提交,避免同时写model.pth。脚本分别指定gpu-8p100-hs、gpu-8v100-16g-hs,申请一张对应16GB显卡、1个CPU核和4GB主存。脚本保留Slurm分配的CUDA_VISIBLE_DEVICES,不要自行写成任意卡号。
关键原生训练参数:
train_paths = ['data/train']
test_paths = None
hidden_sizes = [16, 16]
n_epoch = 1200
start_lr = 0.003
decay_steps = 300
decay_rate = 0.5
force_factor = 0.0
seed = 68017
device = 'cuda:0'
这里只训练能量修正,未做受力损失拟合。PyTorch2.8.0+cu126,DeePKS-kit固定develop提交bf7175bf5;NumPy公开API兼容写法与CPU教程相同。
3. 训练后得到哪些文件#
ls model.pth model.ptg
cat NATIVE-RECEIPT.json
cat GPU-training-predictions.csv
model.pth:原生训练检查点。model.ptg:把训练模型移到CPU后导出的TorchScript模型,可供CPU ABACUS读取。GPU-training-predictions.csv:八个已有几何上的冻结密度预测。
程序先在GPU原生求值,再把同一权重导出到CPU读取;本例二者最大差约1.39×10⁻¹⁷ Ha。两种GPU模型在本组八个构型上的预测一致;模型文件序列化哈希可以不同,不应仅凭文件哈希判断预测是否相同。
4. 本集群两种显卡的实际结果#
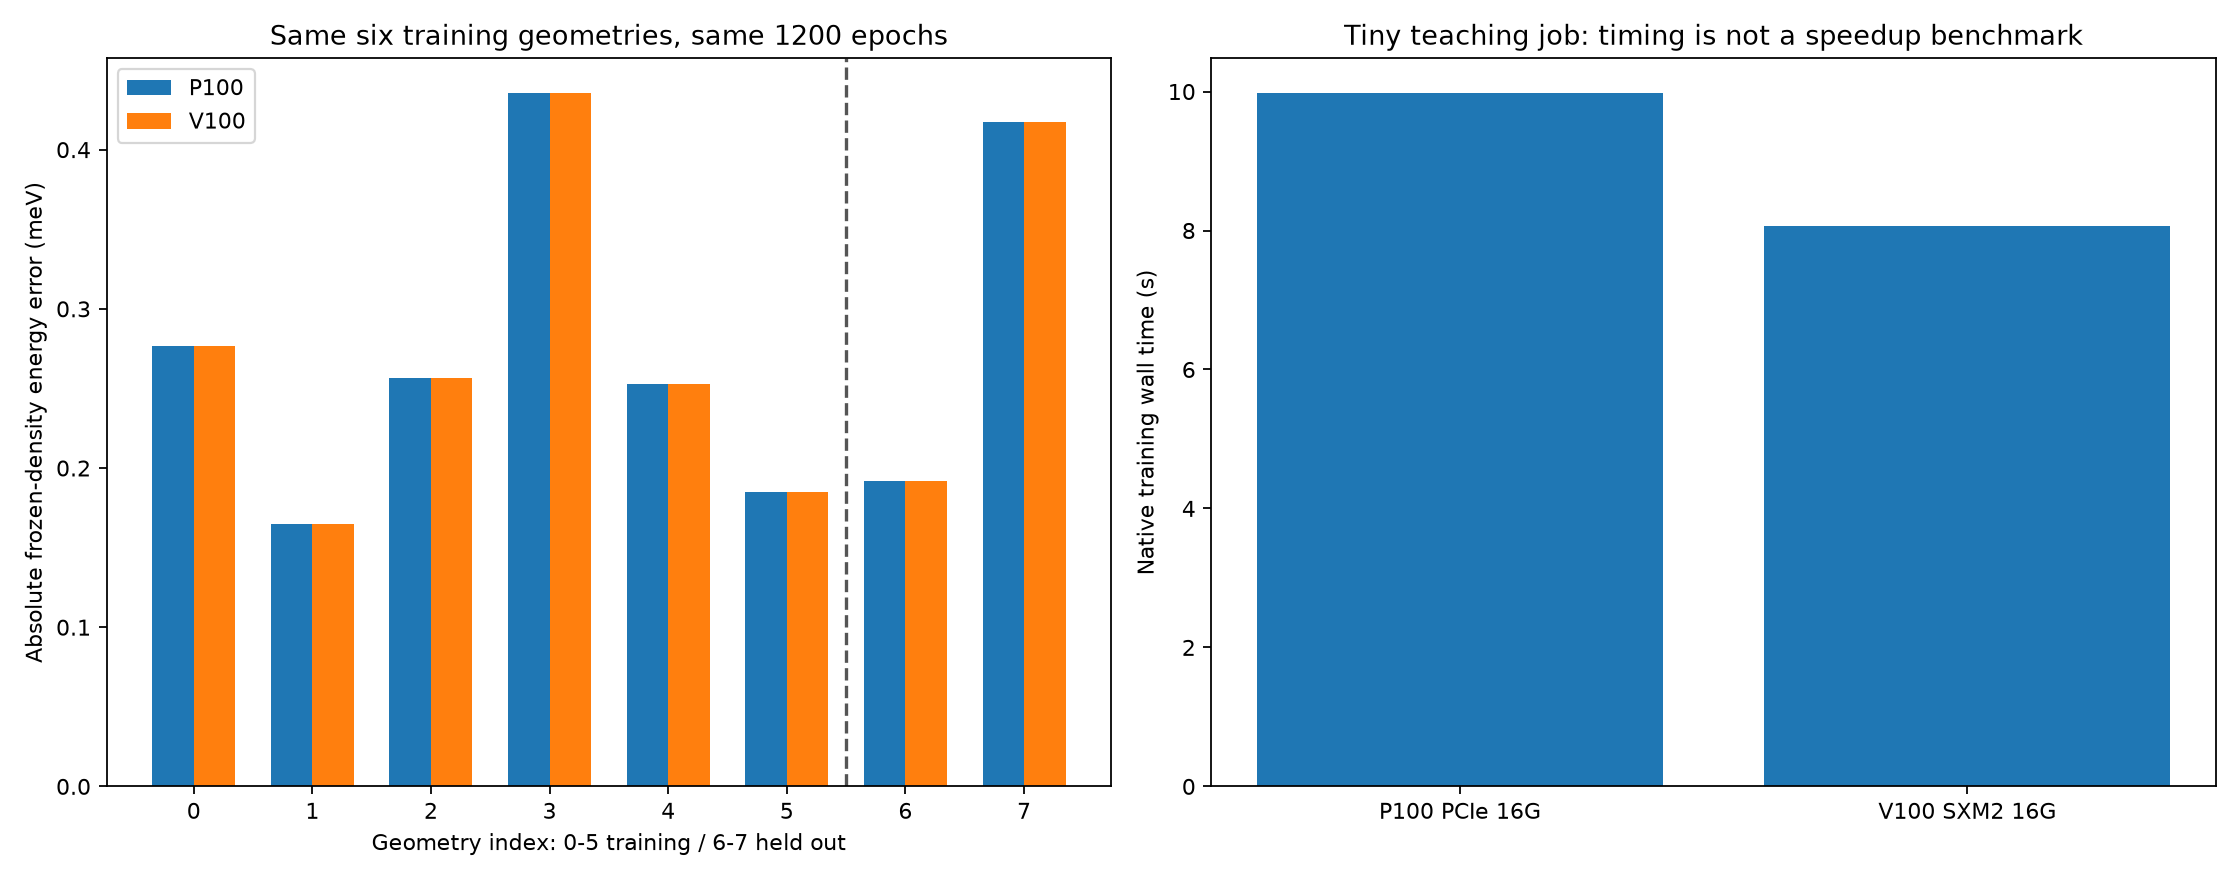
| 单卡 | 本例原生训练用时 | 两个留出构型冻结密度总能MAE |
|---|---|---|
| P100 16G PCIe | 9.98 s | 0.00030459 eV |
| V100 16G SXM2 | 8.06 s | 0.00030459 eV |
这个模型很小,初始化和软件开销占比明显,上述时间不是GPU加速比基准。误差是已有描述符上的冻结密度预测,不能与修正SCF后的0.00019617 eV直接混为同一种指标。
5. 将模型用于ABACUS#
把model.ptg复制到修正SCF实例的模型目录,保持相同投影基、元素和描述符定义,再按该篇提交计算。
cp model.ptg ../abacus-deepks-water/training/model.ptg
路径中的目标目录应已经按SCF教程准备;在新目录做推断,避免覆盖以前的训练结果。真正自洽推断会改变电子密度,应读取新SCF能量和受力,不能把本篇CSV当成已经重新运行过SCF的数据。