
ABACUS DeePKS:训练与导出模型
调用DeePKS-kit完成六帧能量差训练,保存PyTorch模型并导出供ABACUS读取的TorchScript。
阅读本篇目录
接着标签与描述符完成的16个单点,本篇把六个训练几何组成数据集,用DeePKS-kit学习LDA到PBE的能量差,再导出ABACUS可读取的模型。
unzip abacus-deepks-water-wave680-*.zip
cd abacus-deepks-water
bash results.sh
bash plot.sh
以上仅读取已完成的参考数据并重绘,未启动新计算。reference-data/是本集群实算参考,重新执行的原生结果放在work/、提取的数值和图片放在analysis/。每次完整重算使用新解压的目录,避免覆盖已有结果。
本组使用独立CPU环境。先编译一次,再在本资料包目录选择它:
bash use-toolchain.sh ../abacus-ml-env/toolchain
程序为固定ABACUS 3.11.0-beta10;编译器icx/icpx/ifx 2024.2、Intel MPI 2021.13、顺序MKL 2024.2,链接现有PyTorch 2.8.0+cu126,本文实际使用CPU。公共3.10.1模块保持原用途。计算脚本通过cpu-8173m申请56核独占整节点,小例内部采用少量进程,仍按整节点计费;本篇不作CPU节点性能对照。CPU资源暂不可用时可先查看参考数据。
1. 确认上一阶段已结束#
ls work/water5-lda/OUT.dk/deepks_dm_eig.npy
grep FINAL_ETOT_IS work/water5-pbe/OUT.dk/running_scf.log
sbatch train.slurm
训练脚本读取已经完成的结果,不重新提交DFT。它检查配对结构与文件是否一致,把基础能量、目标能量及差值放在data/train中,两个未参与训练的构型放在data/heldout中。
ls data/train
cat training/TRAINING-ARGS.json
| 文件 | 内容 |
|---|---|
| dm_eig.npy | 每帧、每原子的18维投影描述符 |
| e_base.npy | LDA基础能量,Ha |
| energy.npy | PBE目标能量,Ha |
| l_e_delta.npy | 目标减基础的能量差,Ha |
| atom.npy | 原子序数和Bohr坐标 |
| conv.npy | 对应结构是否已收敛 |
2. 本例实际训练设置#
train.py调用DeePKS-kit原生训练接口,主要设置为:
from deepks.model.train import main
main(
    train_paths=['data/train'],
    test_paths=None,
    model_args=dict(hidden_sizes=[16,16], output_scale=100,
                    use_resnet=True, actv_fn='mygelu'),
    data_args=dict(batch_size=6, group_batch=1),
    preprocess_args=dict(preshift=True, prescale=False,
                         prefit=True, prefit_ridge=0.001,
                         prefit_trainable=False),
    train_args=dict(n_epoch=1200, start_lr=0.003,
                    decay_steps=300, decay_rate=0.5,
                    force_factor=0.0),
    seed=68017, device='cpu')
完整可执行参数以包内train.py为准。固定1200轮、随机种子68017;两层各16个神经元。训练使用六帧,两个独立检查构型不用于拟合、超参数选择或提前停止。
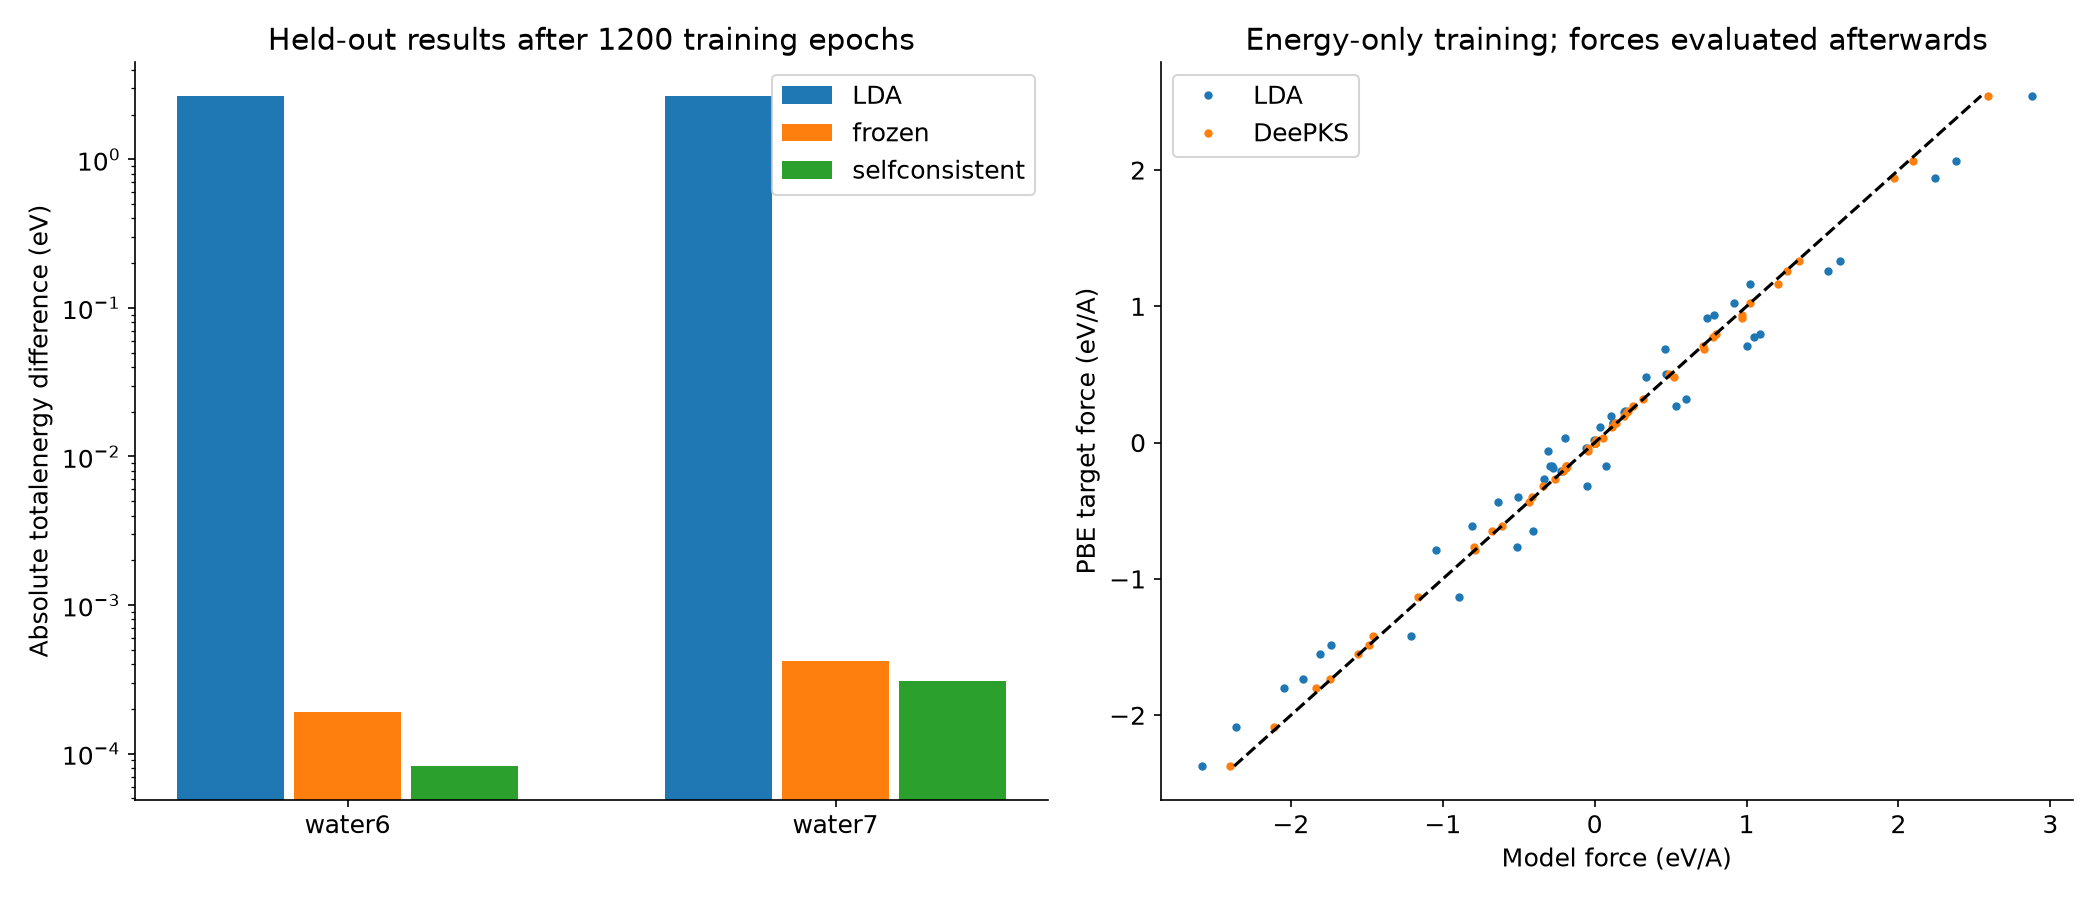
force_factor=0表示只使用能量差标签。训练后的力来自模型加入自洽泛函后的导数,不能称作“已经使用力标签训练”。本例CPU训练很小,增加GPU不会改变数据覆盖不足的问题。
3. 查看原模型与导出文件#
ls training/model.pth training/model.ptg
cat TRAINING-FINISHED.json
model.pth是训练检查点,model.ptg是TorchScript。脚本通过DeePKS-kit的CorrNet.compile_save导出,再对真实八个描述符比较Python与TorchScript输出;本次两者逐值相同。ABACUS的deepks_model填写model.ptg。
head training/DeePKS-fixed-density-predictions.csv
固定LDA密度上评估模型时,六帧训练构型相对PBE的总能MAE为约0.000262 eV,两个独立检查构型为约0.000305 eV。该列还未重新更新电子密度,下一篇会实际进行修正自洽。
4. 如何扩展自己的数据#
先覆盖目标化学组成、键长、角度、体积或相变范围,再划分训练与独立检查集。不要把同一构型的复制帧分到两边,也不要根据独立检查误差反复挑选模型后仍把它当作未使用的测试集。本例仅八个水分子几何,不能推广为通用水势、溶液或反应模型。
接着加载模型进行自洽。训练方法依据:DeePKS-kit官方说明与本组固定源码。