
ABACUS与DeePTB:训练模型并预测能带
从六个训练结构出发,在P100上训练H和S模型,再对独立结构预测全部八条能带。
阅读本篇目录
本例用同一批Si标签,在单张P100 16G上训练DeePTB模型,同时学习哈密顿量H和重叠矩阵S,再从新结构的几何信息预测能带。参考模型由本集群实际训练得到,没有借用上游预训练权重。
unzip abacus-deeptb-wave696-*.zip
cd abacus-deeptb
bash results.sh
bash plot.sh
1. 先用参考模型走一遍#
bash use-tools.sh ../abacus-ml-env ../abacus-ml-labels
bash prepare.sh
bash predict.sh
ls analysis
prepare.sh按固定划分整理数据并生成train.json,不会开始训练。predict.sh默认读取trained-model/nnenv.best.pth,只从元素、晶胞和坐标创建预测输入;参考H和S只在预测结束后比较误差。
输出analysis/Si-DeePTB-summary.csv、Si-DeePTB-bands.csv,以及每个结构的预测矩阵HDF5。
2. 看懂模型输入与训练配置#
每个Si使用1s1p轨道,2个Si共8个轨道。使用2层SLEM等变嵌入、7Å邻居范围,输出E3TB矩阵。完整配置随包提供,核心部分如下:
{
  "common_options": {
    "basis": {
      "Si": "1s1p"
    },
    "device": "cuda",
    "dtype": "float32",
    "overlap": true,
    "seed": 69617
  },
  "model_options": {
    "embedding": {
      "method": "slem",
      "r_max": {
        "Si": 7.0
      },
      "irreps_hidden": "8x0e+8x1o+4x2e",
      "n_layers": 2,
      "avg_num_neighbors": 70,
      "tp_radial_emb": true
    },
    "prediction": {
      "method": "e3tb",
      "neurons": [
        32,
        32
      ]
    }
  },
  "train_options": {
    "num_epoch": 1200,
    "batch_size": 2,
    "val_batch_size": 2,
    "optimizer": {
      "lr": 0.005,
      "type": "Adam"
    },
    "lr_scheduler": {
      "type": "rop",
      "factor": 0.7,
      "patience": 50,
      "min_lr": 1e-05
    },
    "loss_options": {
      "train": {
        "method": "hamil_abs"
      },
      "validation": {
        "method": "hamil_abs"
      }
    },
    "save_freq": 200,
    "validation_freq": 10,
    "display_freq": 20
  },
  "data_options": {
    "train": {
      "root": "data/train",
      "prefix": "Si",
      "get_Hamiltonian": true,
      "get_overlap": true
    },
    "validation": {
      "root": "data/validation",
      "prefix": "Si",
      "get_Hamiltonian": true,
      "get_overlap": true
    }
  }
}
train只含6个结构,validation含2个结构;独立测试目录不写入训练配置。overlap: true表示同时学习S,S不是从目标DFT矩阵直接提供给模型。hamil_abs是训练H和S的绝对误差损失,图上的数值不能直接当成能带误差。
3. 自己训练#
sbatch train.slurm
squeue -u "$USER"
tail -n 20 training.log
参考运行使用单P100 16G、2个CPU线程,固定种子69617,1200轮,约14分钟。以验证集损失选出的参考模型为原生epoch 1118检查点。最终一轮的模型不一定最好。
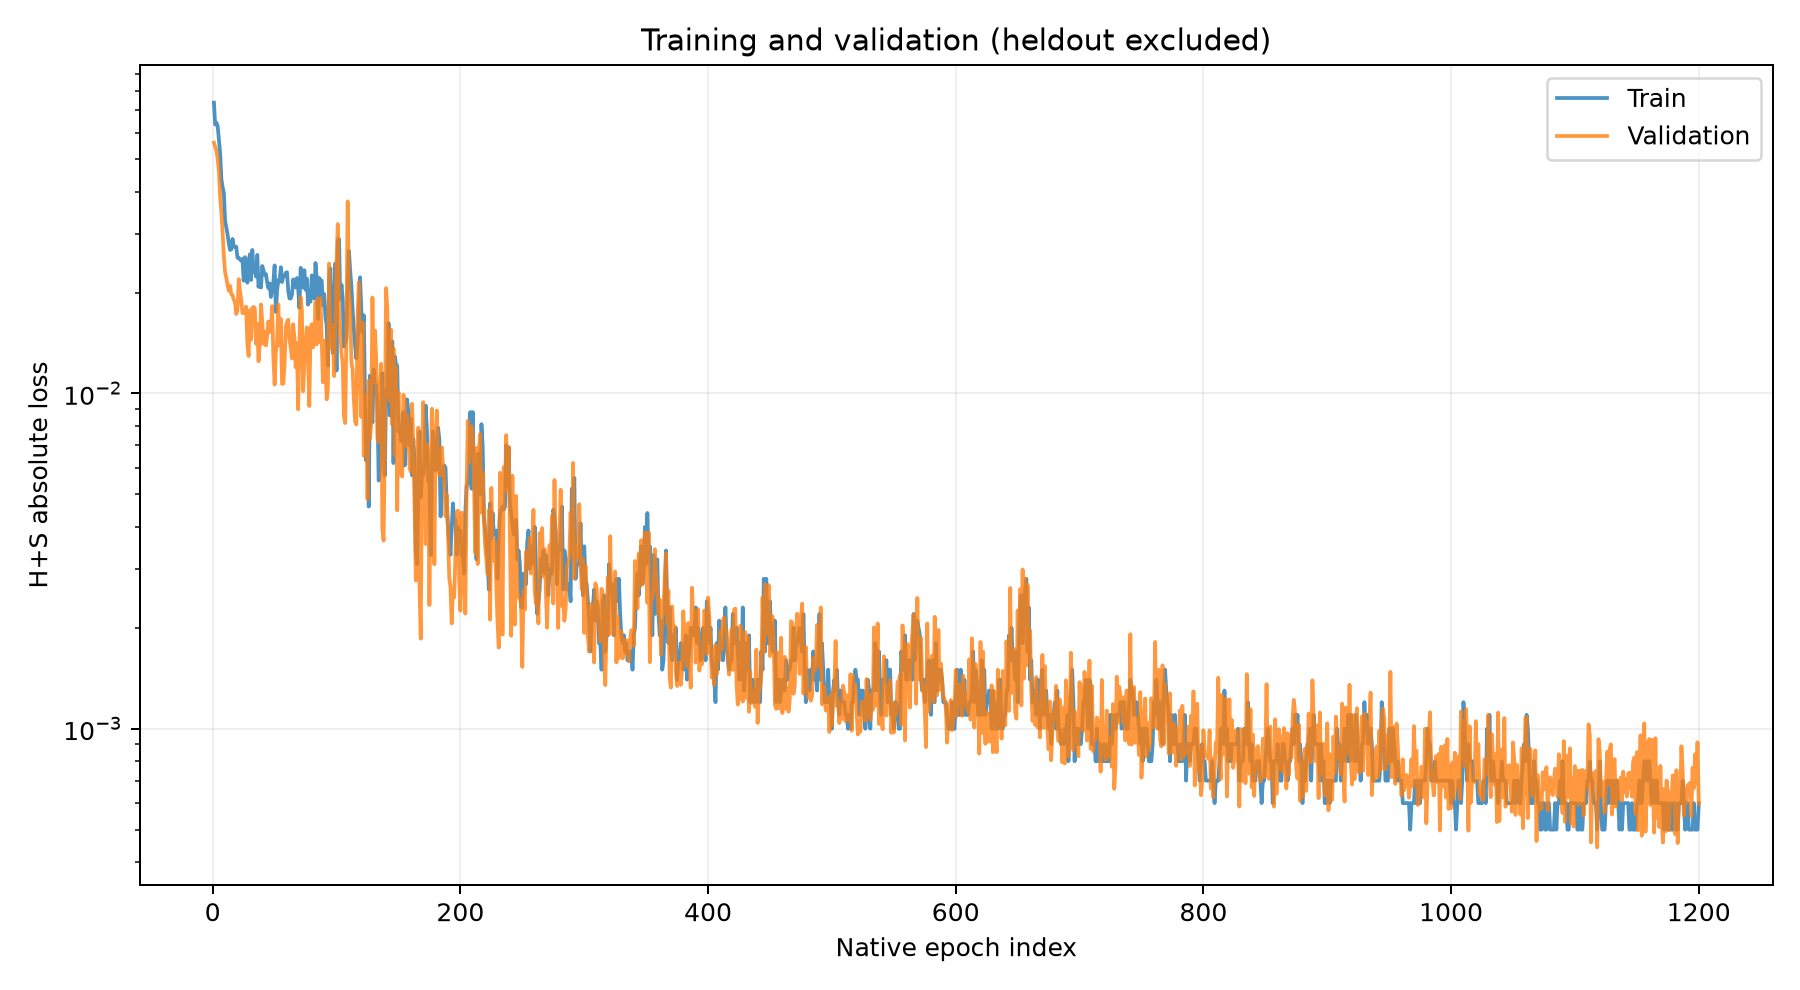
自己的训练完成后,使用自己的验证集最优模型:
export YS_MODEL="$PWD/output/checkpoint/nnenv.best.pth"
bash predict.sh
这样会替换预测时使用的模型路径,不会再次训练。
4. 独立结构的实际结果#
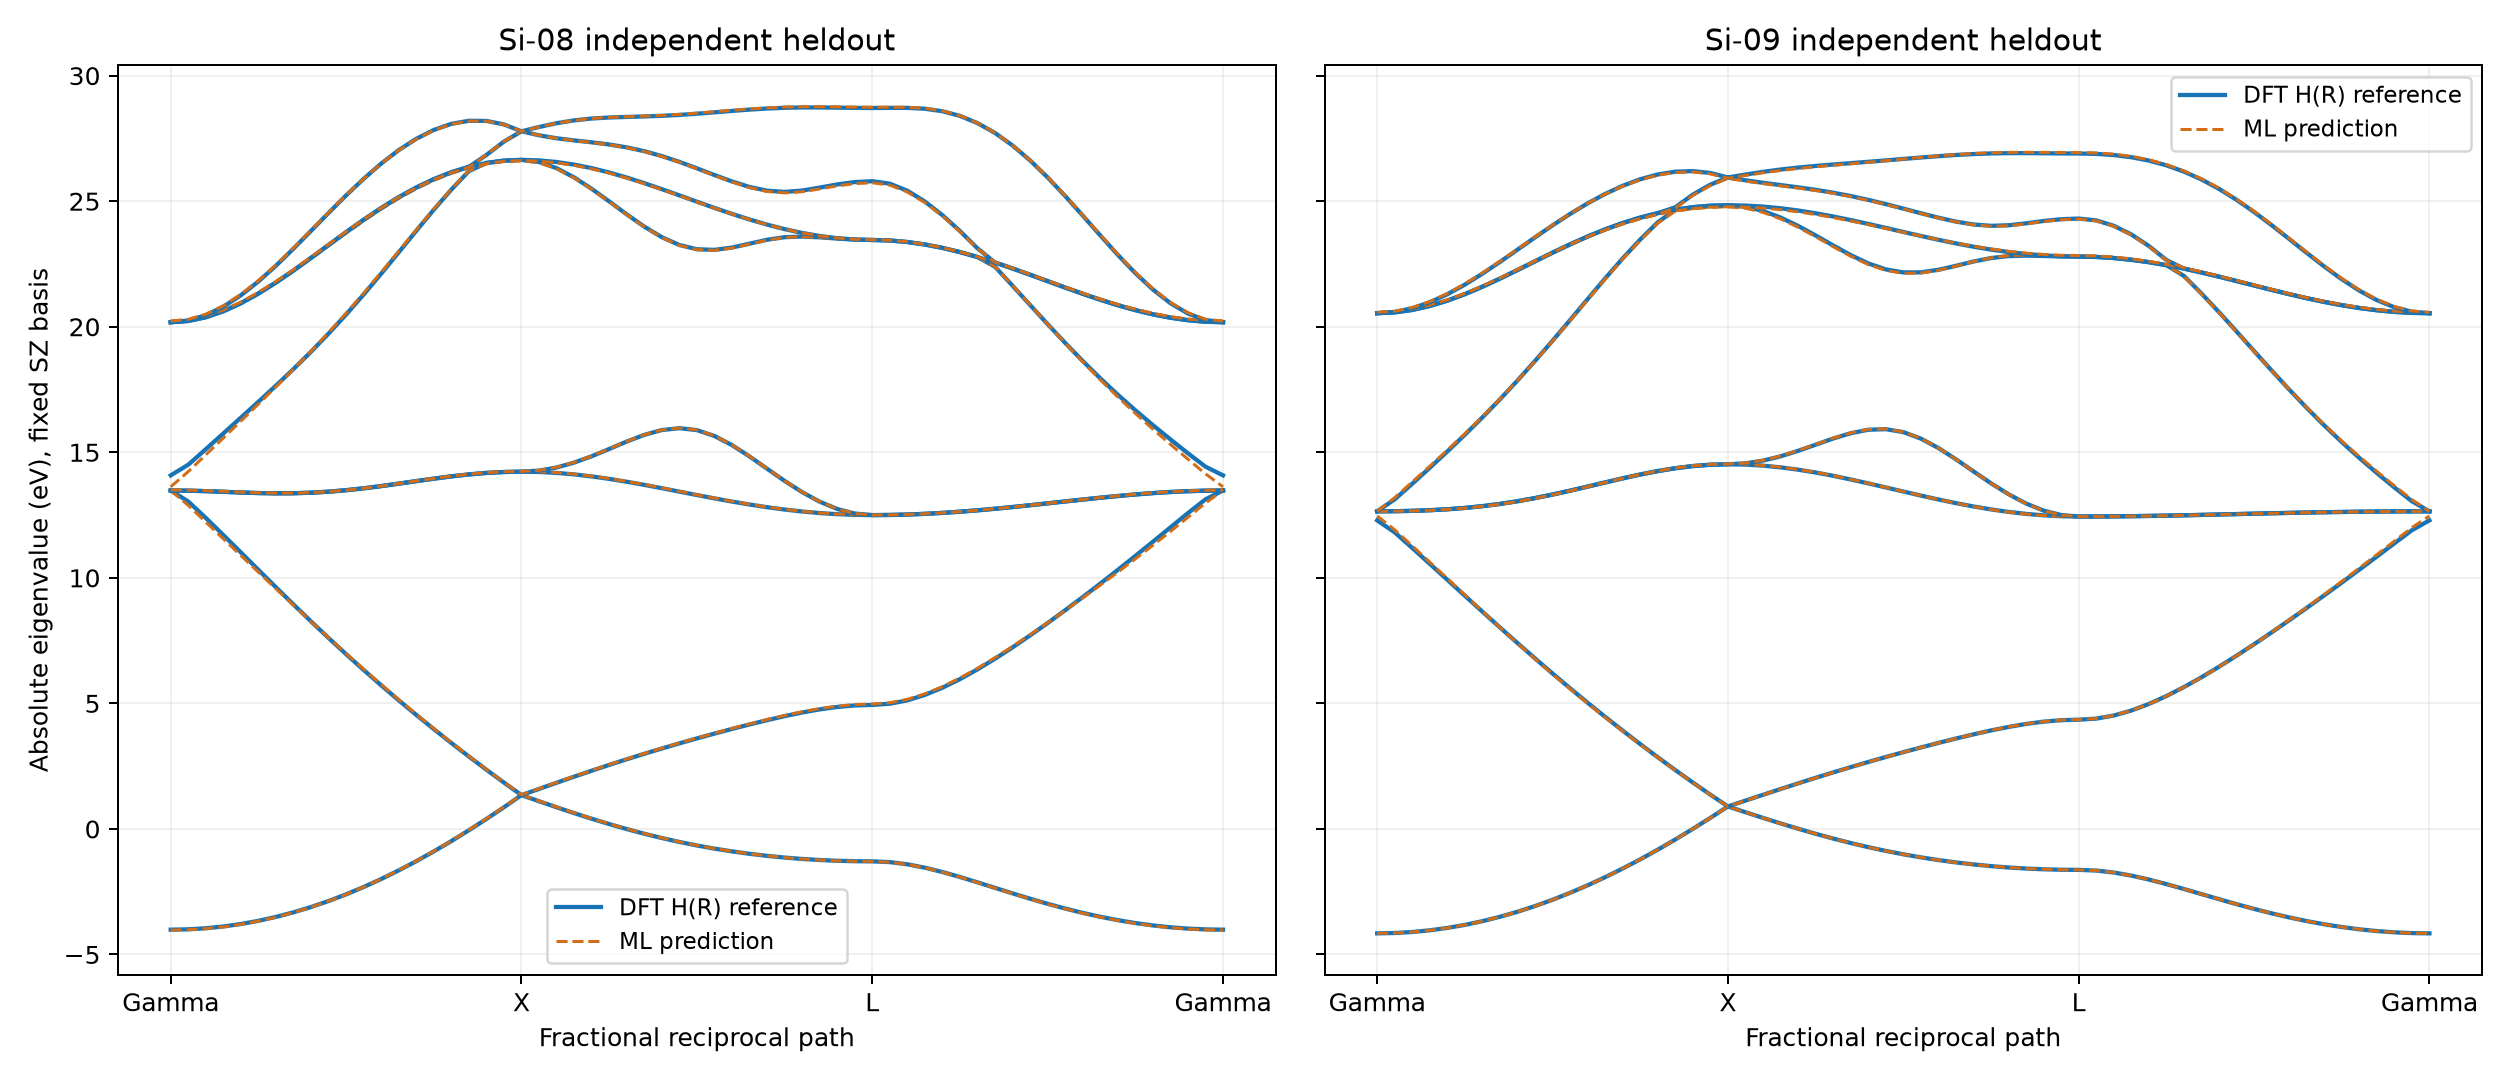
| 测试结构 | H矩阵MAE/eV | S矩阵MAE | 能带MAE/eV | 能带最大误差/eV |
|---|---|---|---|---|
| Si-08,a=5.35Å | 0.000503 | 0.0000254 | 0.02470 | 0.4544 |
| Si-09,a=5.48Å | 0.000482 | 0.0000221 | 0.01910 | 0.1758 |
能带误差统计包含8个原生网格点和Γ–X–L–Γ路径61点的全部8条带,比较绝对能量,没有用整体平移人为减小误差。图中蓝实线是完整DFT实空间矩阵的傅里叶参考,橙虚线是模型预测。
平均误差较小不代表每个k点都精确,个别点最大差异达到0.45eV;CSV保留每一条数据。预测S在全部检查点正定,没有删除小本征值来强行求解。配套脚本还把原生DeePTB本征值与独立的矩阵傅里叶求解比较,检查轨道、相位和单位。
5. 换成自己的体系前#
先增加构型覆盖、收敛DFT基组和k网格,再重新划分训练与独立测试。这个模型只见过同一Si2结构的小范围均匀伸缩,没有学习原子扰动、温度、缺陷或不同元素。训练损失下降不能替代这些构型上的实际误差检查。
原生方法与接口:DeePTB E3训练示例、固定源码。