
pymatgen:替位候选与初始模型
用氧化态条件替位模型生成电中性候选,实际写出六个未松弛模型。
阅读本篇目录
想从现有结构寻找“哪些离子替换值得先试”,可以用pymatgen的经验替位模型生成候选,再自行计算和筛选。这里的分数来自经验统计表,不是新材料稳定的概率,也不是替位形成能。
本例以实际NaCl原胞为几何起点,给Na/Cl指定+1/−1氧化态,离线生成电中性候选,并输出6个未松弛的初始模型。
unzip pymatgen-prototypes-wave707-*.zip
cd pymatgen-prototypes
bash results.sh
bash plot.sh
1. 输入需要带氧化态#
from pymatgen.core import Composition
from pymatgen.analysis.structure_prediction.substitutor import Substitutor

predictor = Substitutor(threshold=0.001)
predictions = predictor.pred_from_comp(
    Composition({'Na+': 1, 'Cl-': 1}))
for result in sorted(predictions, key=lambda x: -x['probability']):
    print(result['substitutions'], result['probability'])
Na+与中性元素Na不是同一输入概念。这里氧化态是NaCl的形式化学标记,不是读取Bader电荷后自动四舍五入。
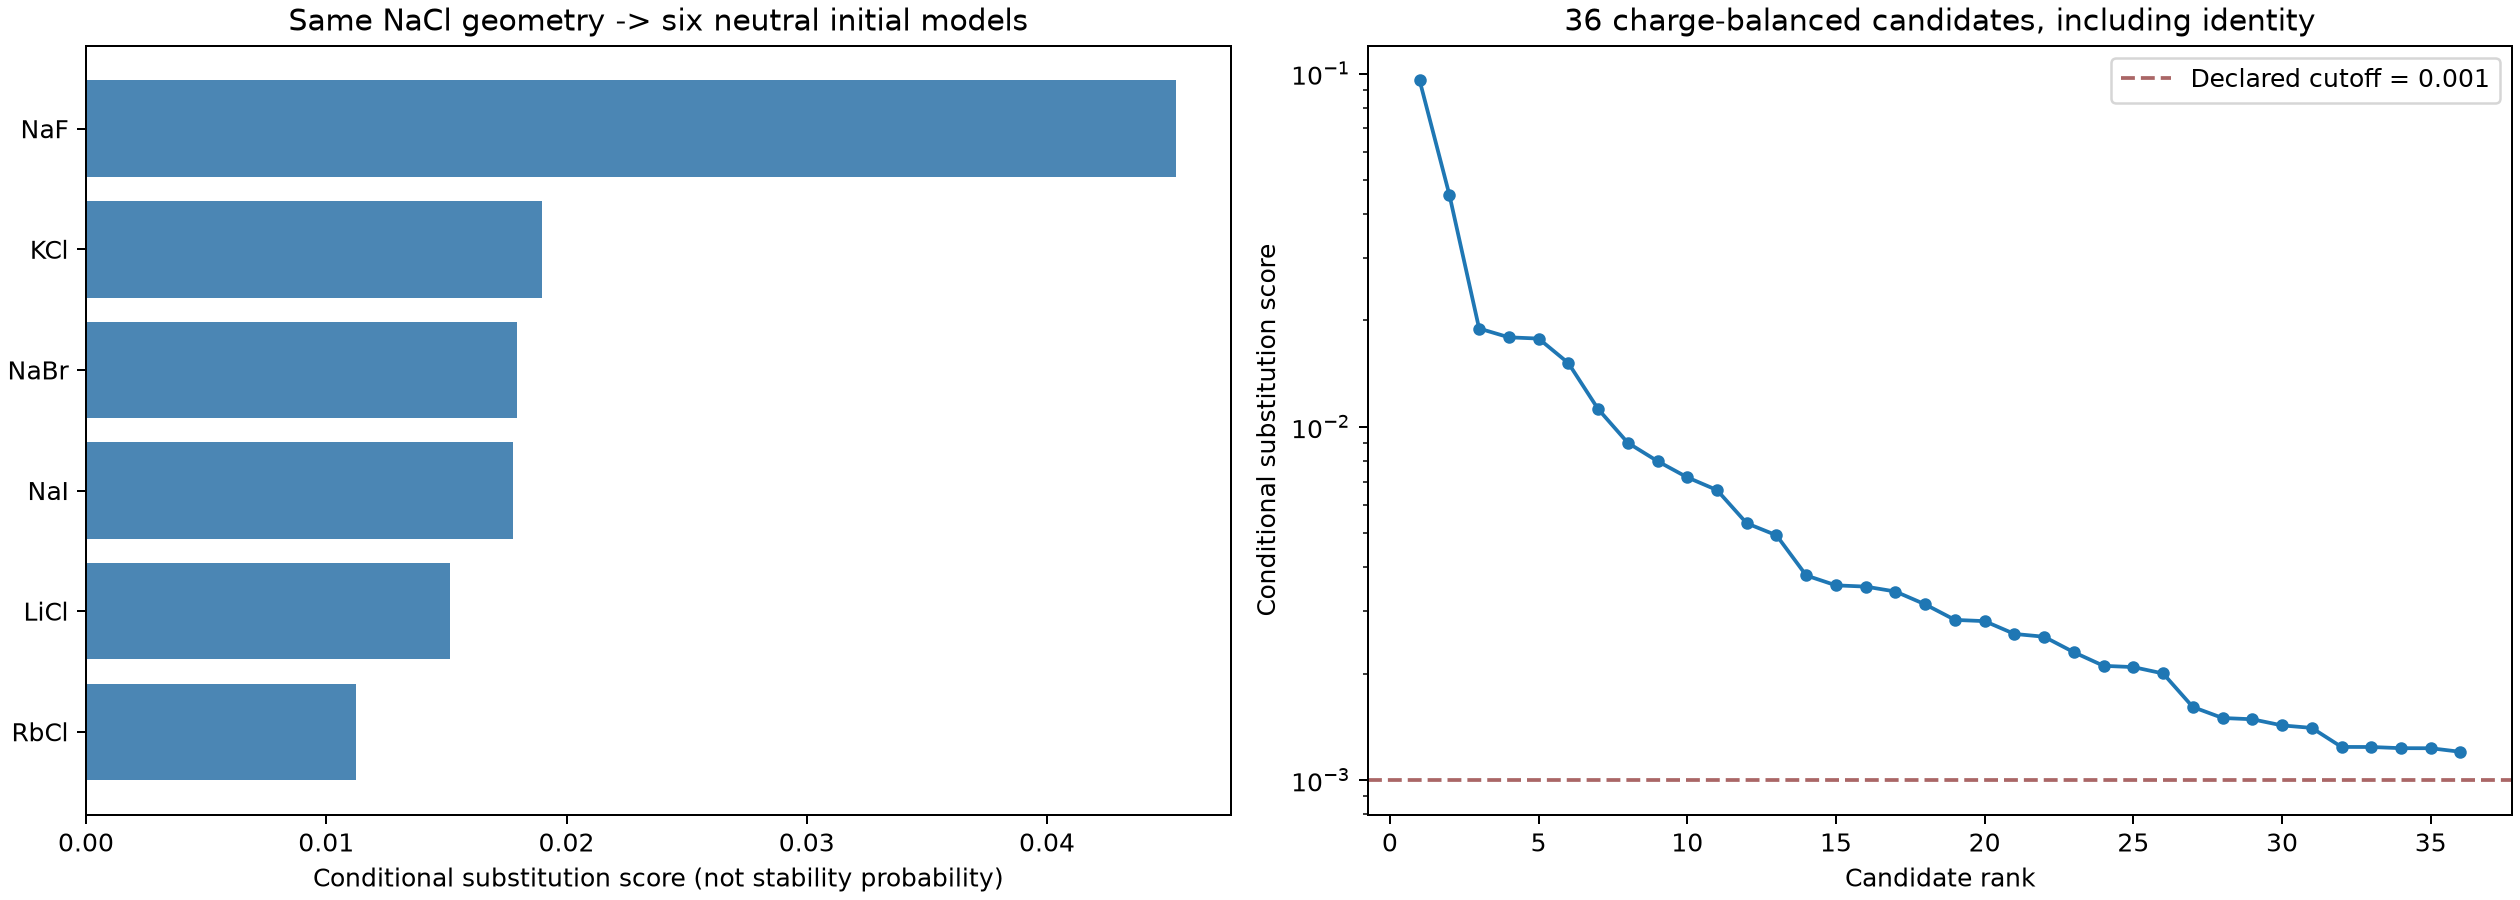
threshold=0.001是候选分数筛选阈值。本次实际得到36个电中性候选,其中包含“Na仍替为Na、Cl仍替为Cl”的恒等映射。恒等映射可以作参照,但不算一个新材料。
2. 实际保留哪些初始模型#
为了让输出可读,本例从候选中固定筛选Li/Na/K/Rb/Cs及F/Cl/Br/I元素范围,按分数降序保留前6个非恒等模型:
| 候选 | 经验条件替位分数 | 实际输出 |
|---|---|---|
| NaF | 0.0453843 | POSCAR-01-NaF |
| KCl | 0.0189794 | POSCAR-02-KCl |
| NaBr | 0.0179200 | POSCAR-03-NaBr |
| NaI | 0.0177745 | POSCAR-04-NaI |
| LiCl | 0.0151528 | POSCAR-05-LiCl |
| RbCl | 0.0112307 | POSCAR-06-RbCl |
这只是本例的显示范围,不表示其他元素不能被预测。完整36条记录在CSV中,分数没有按这六个候选重新归一化。
3. 如何真正写出结构#
from pymatgen.core import Structure, Species

s = Structure.from_file('inputs/POSCAR-NaCl')
s.add_oxidation_state_by_element({'Na': 1, 'Cl': -1})
s.replace_species({Species('Cl', -1): Species('F', -1)})
print(s.composition, s.charge)
s.remove_oxidation_states()
s.to(filename='POSCAR-NaF-initial')
完整包中按每条原生替位映射执行,并保存POSCAR与JSON:
module load pymatgen/2026.9.24
bash run.sh
ls models
环境为Python3.11及pymatgen2026.9.24,使用包内经验替位数据,不需要API key或重新编译软件。
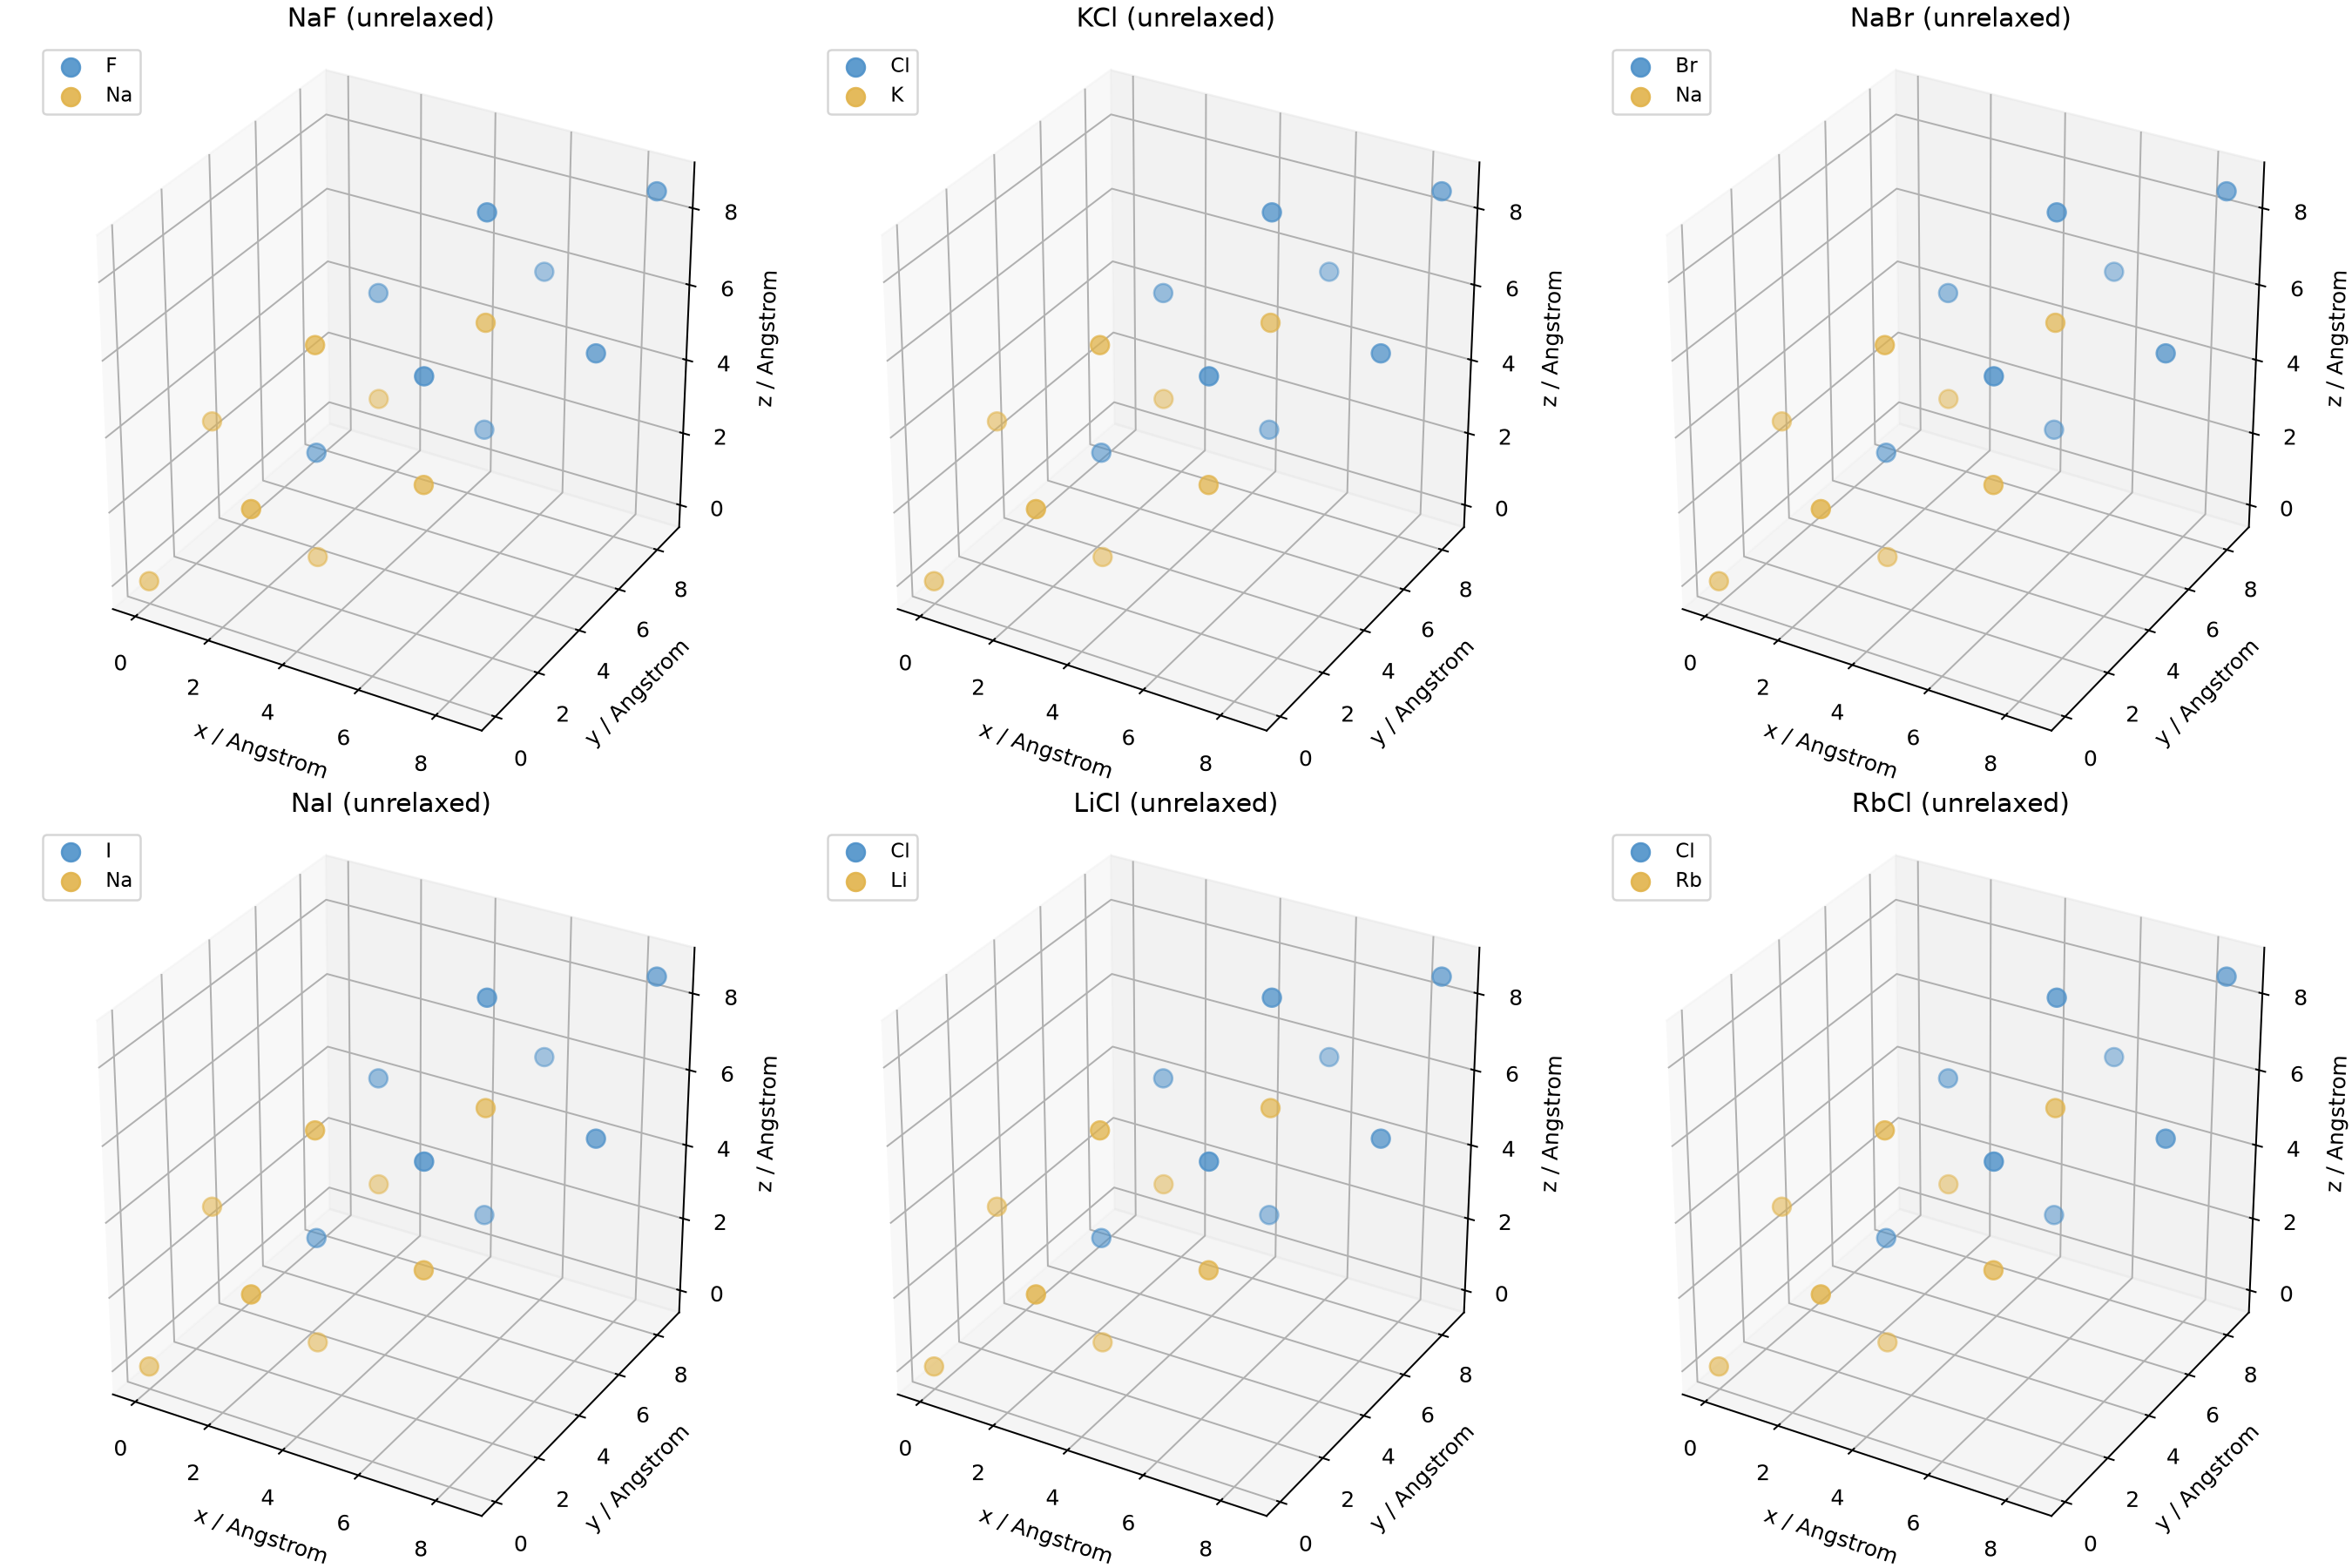
所有模型保持原NaCl晶胞和分数坐标,只替换元素。图为便于观察作2×2×2重复;文件仍是原始两原子模型。NaF、KCl等平衡晶格不同,因此这些结构需要后续合理的晶胞和原子位置优化,不能直接当作平衡结构。
4. 后续DFT要做什么#
先为新元素换正确赝势、电子数、截断和收敛参数;再按目标条件优化晶胞/原子位置,比较同方法的能量及稳定性。不能沿用NaCl的POTCAR,也不能把预测分数填成DFT能量。
若要比较不同组成的形成能,还需要一致的元素或化学势参照。经验替位推荐仅缩小起始搜索范围,不能代替凸包、声子或实验验证。
cat reference-data/Pymatgen-substitution-candidates.csv
替位统计分数及其条件方向见pymatgen结构预测模块。原型识别见离线原型匹配,实际形成能和候选凸包见凸包与Pourbaix图。