
pymatgen:CuNi短程有序度实操
构造三种32原子CuNi排列,统计最近邻Cu–Ni连接,用实际数据解释负、近零与正的有序参数。
阅读本篇目录
同样是50:50的CuNi,Cu和Ni在空间中怎么排列,会改变最近邻的元素配对。本例从自有实际Cu晶格构造32位点模型,只比较几何邻居统计,不计算合金能量。
unzip pymatgen-composition-order-models-wave717-*.zip
cd pymatgen-composition-order-models
module load pymatgen/2026.9.24
bash results.sh
bash plot.sh
环境为pymatgen2026.9.24、Python3.11、NumPy/SciPy和Matplotlib。results.sh读已有结果;plot.sh把参考数据画到figures。run.sh会重新做这套小规模后处理,结果写到新建的analysis,不会启动DFT或MD。已有analysis时请保留它,在另一份解压目录分析。
1. 准备晶格与超胞#
原Cu常规胞晶格常数为3.63502234402532Å,含4个FCC位点。用于建模的等价简明POSCAR为:
Cu FCC source geometry
1.0
3.63502234402532 0 0
0 3.63502234402532 0
0 0 3.63502234402532
Cu
4
Direct
0 0 0
0 0.5 0.5
0.5 0 0.5
0.5 0.5 0
完整原件保存在inputs/POSCAR-Cu。扩为2×2×2后有32个位点,再分配16Cu和16Ni。
python - <<'PY'
import numpy as np
from pymatgen.core import Structure
s = Structure.from_file('inputs/POSCAR-Cu')
s.make_supercell([2, 2, 2])
rng = np.random.default_rng(717012)
cu = set(rng.choice(len(s), len(s)//2, replace=False).tolist())
random_model = Structure(s.lattice,
    ['Cu' if i in cu else 'Ni' for i in range(len(s))], s.frac_coords)
random_model.to(filename='POSCAR-CuNi-my-random')
print(random_model.composition, len(random_model))
PY
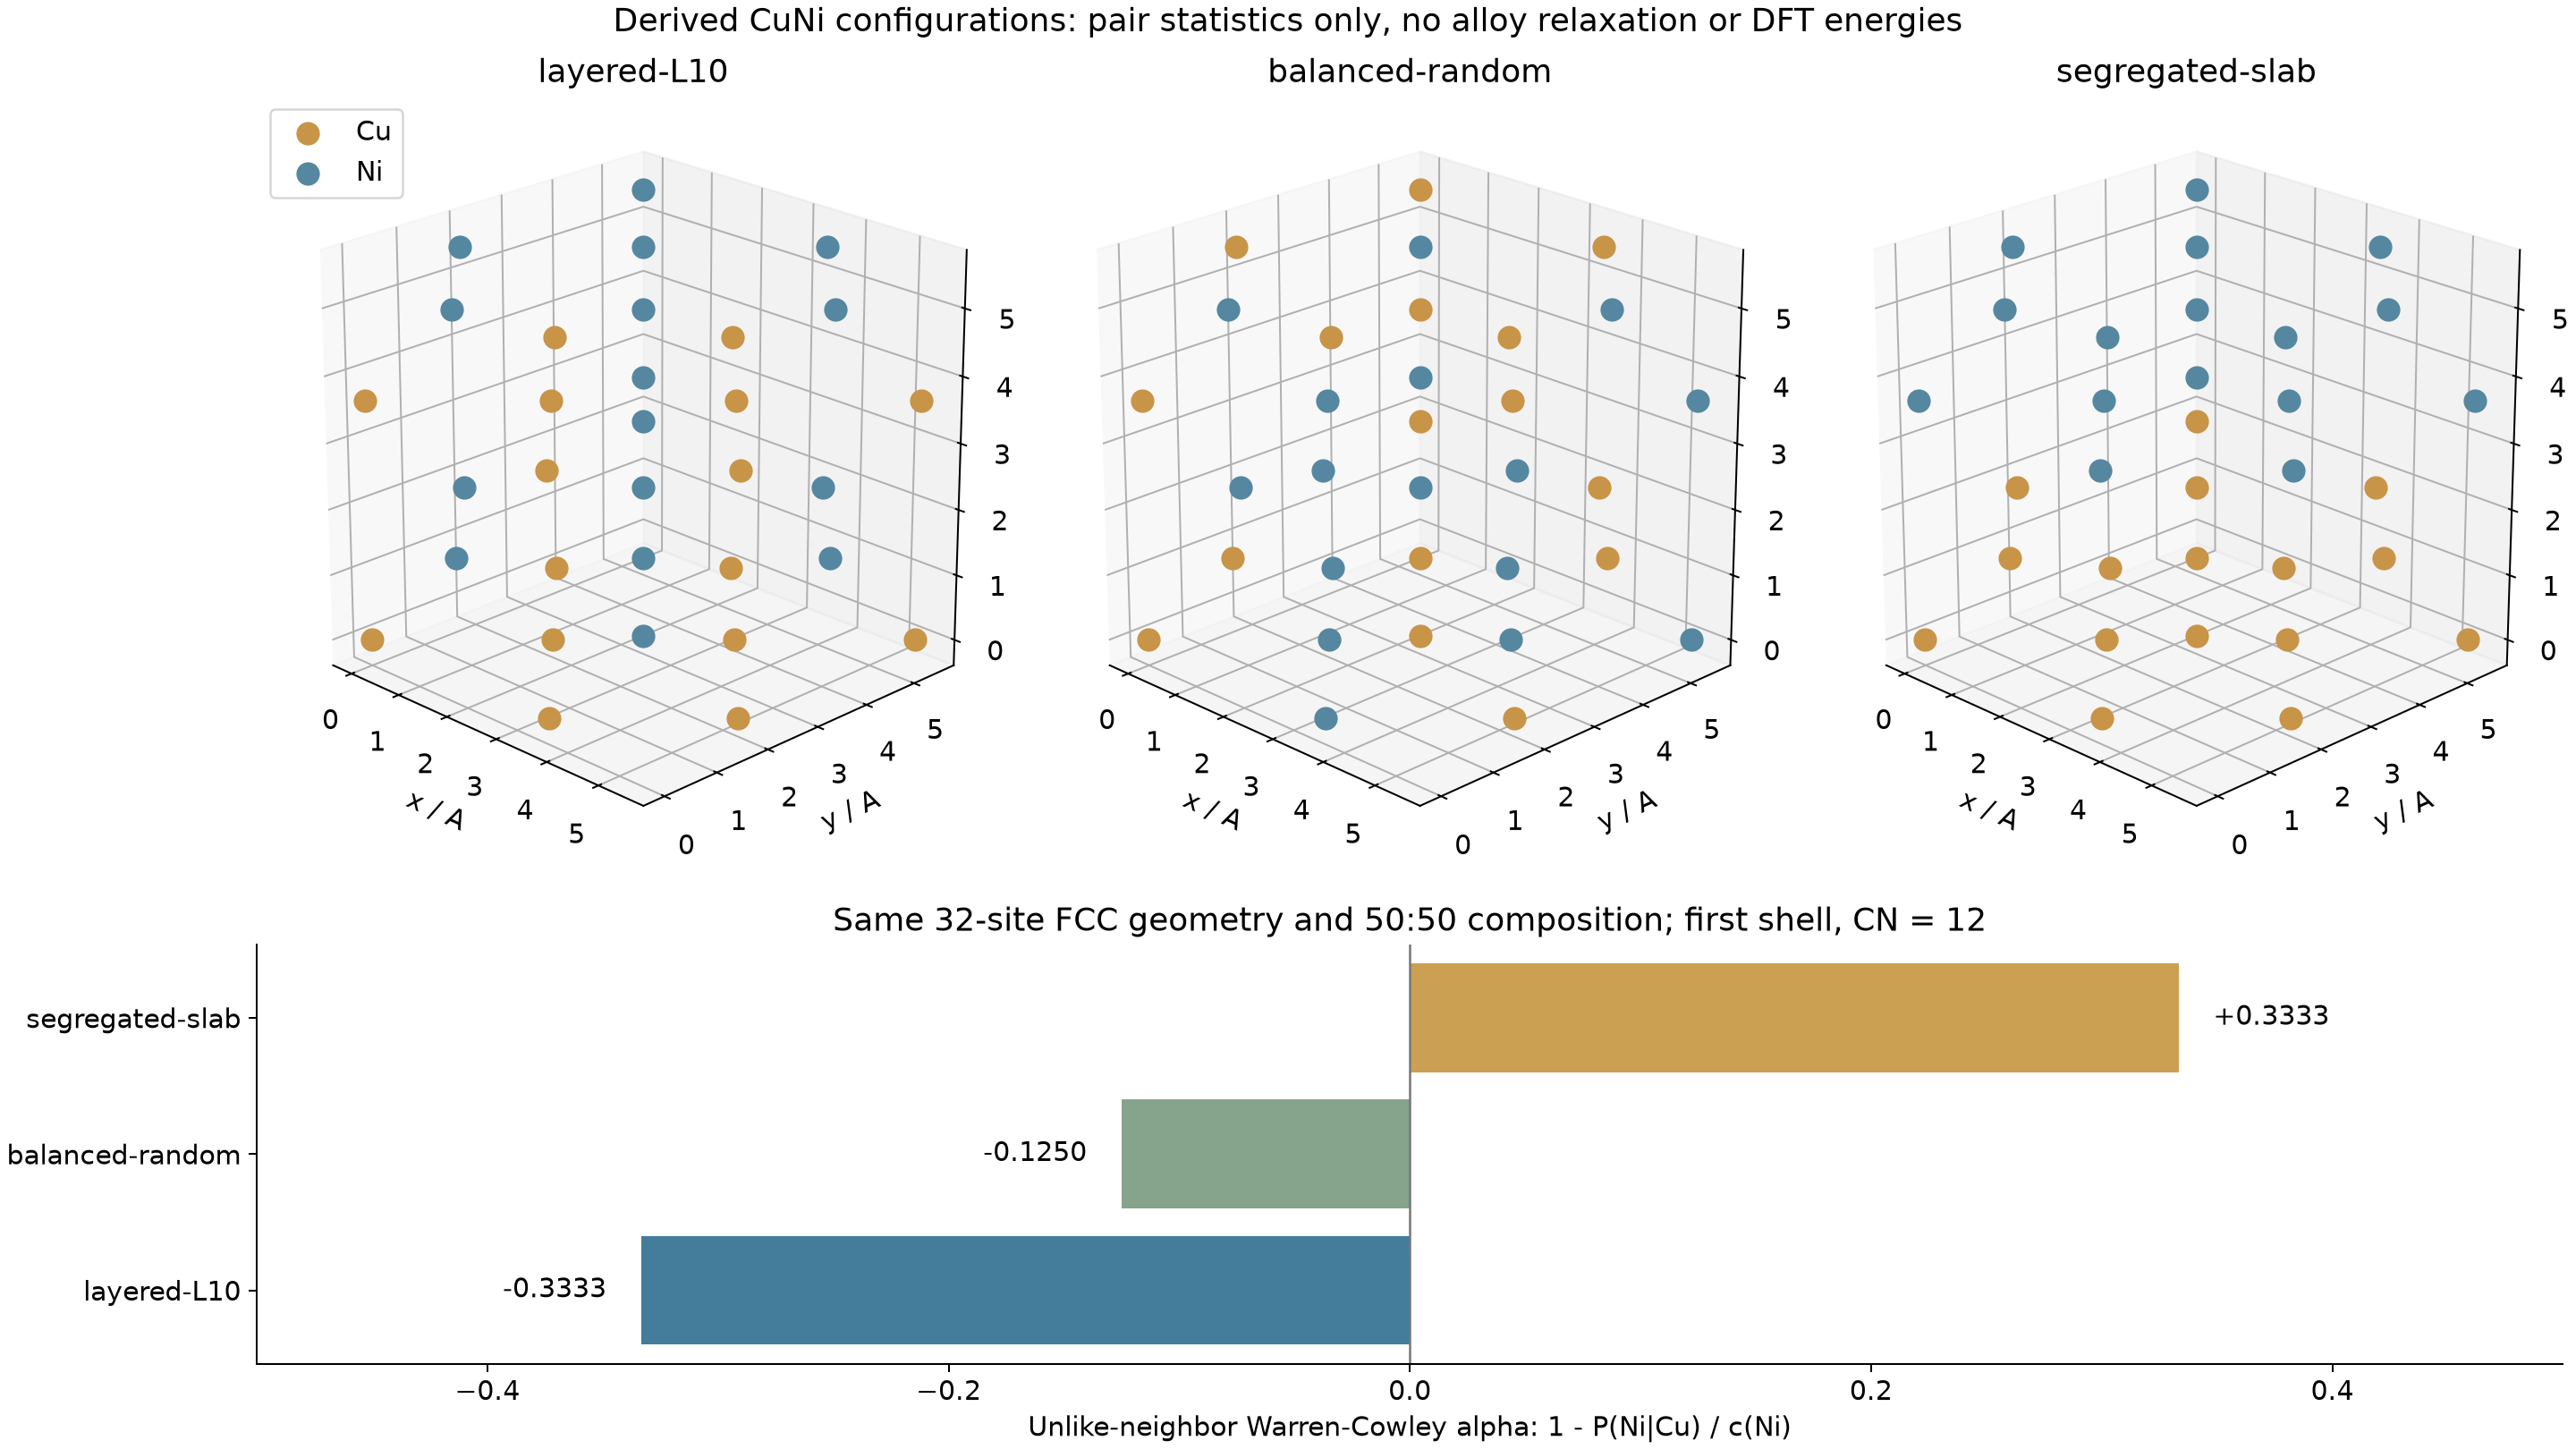
参考包还含沿z规则交替的layered-L10和按z分区的segregated-slab。这里后一个名字表示元素分区排列,仍是三维周期体相胞,没有真空表面。三种模型晶格、坐标、组成相同,只改变元素标签,未重新弛豫。
2. 选择最近邻壳层#
本例FCC最近邻距离为a/√2=2.5703489492Å,每个位点有12个最近邻。接口的r为壳层中心,dr是半宽,本例取0.03Å。
python - <<'PY'
from pymatgen.core import Structure, Element
from pymatgen.analysis.disorder import get_warren_cowley_parameters
for name in ['layered-L10', 'balanced-random', 'segregated-slab']:
    s = Structure.from_file('reference-structures/POSCAR-CuNi-' + name)
    alpha = get_warren_cowley_parameters(s, r=2.5703489492249236, dr=0.03)
    print(name, alpha[Element('Cu'), Element('Ni')])
PY
换成有应变、热运动或不同晶格的结构时,要根据实际径向分布选壳层,不能照抄这个距离。
3. 读懂实际结果#
对异种元素Cu–Ni,本例报告:
α(Cu,Ni)=1−P(Ni|Cu)/c(Ni),其中c(Ni)=0.5。
| 排列 | Cu最近邻中Ni的比例 | α(Cu,Ni) |
|---|---|---|
| 规则交替L1₀型 | 2/3 | −0.333333 |
| 固定种子随机排列 | 0.5625 | −0.125000 |
| 元素分区排列 | 1/3 | +0.333333 |
负值表示异种近邻比该组成的独立随机基准更常见;正值表示异种近邻较少。32原子的单个随机样本并不保证α恰为0,也不是经过SQS优化的结构。
本例刻意展示异种元素项。该版本同种元素对的原生归一化公式不同,不能把字典里的所有项都不加区分地代入上述异种公式。
4. 对照邻居计数#
cat reference-data/CuNi-short-range-order.csv
cat reference-data/CuNi-directed-neighbor-counts.csv
第二个CSV给出中心元素、邻居元素、有向配对数、该中心元素的邻居总数和条件概率。本例另按周期镜像逐对数距离,独立核对了最近邻数和α。
这些结果描述所给排列的几何有序程度,没有推断混合焓、稳定相或有限温度平衡态。用于MD时,可逐帧统计并做时间/空间平均,再分析误差和收敛。
接口见pymatgen短程有序模块。