
MDAnalysis 自定义结果与分块合并
用真实蛋白轨迹演示AnalysisFromFunction、Results和ResultsGroup,保留帧顺序并正确组合不等长数据块。
阅读本篇目录
下载真实轨迹、模块导航与结果合并示例,保存为 example.zip:
python3 -m zipfile -e example.zip .
cd mdanalysis-analysis-guide
bash results.sh
bash plot.sh
使用集群MDAnalysis 2.9.0 / Python 3.11环境。MDAnalysis本身以Python及其编译扩展安装;本例不编译或启动GROMACS,而是分析已经完成的泛素轨迹。下载包包含PDB_CONECT、同序拓扑元数据及1001帧XTC;每20帧取一帧,得到51帧、0—100 ps的分析输入。
当前MDAnalysis不能解析这份原始TPR138,所以这里按既有真实模型的原子顺序读取PDB_CONECT与质量,再处理周期边界。不是删去原子或另外编造了一份轨迹。
1. 从真实轨迹取一个简单量#
本例选择蛋白前两个Cα原子,计算它们之间的距离。完整脚本先按PDB_CONECT和原拓扑质量展开分子,再每20帧取一帧。
bash run.sh
head -n 12 results/Protein-distance-aggregation.csv
在已经创建好Universe对象u后,原生调用为:
from MDAnalysis.analysis.base import AnalysisFromFunction
import numpy as np
pair = u.select_atoms('protein and name CA')[:2]
def distance(atoms):
    return np.linalg.norm(atoms.positions[1] - atoms.positions[0])
analysis = AnalysisFromFunction(distance,pair).run(step=20)
values = analysis.results.timeseries
times = analysis.times
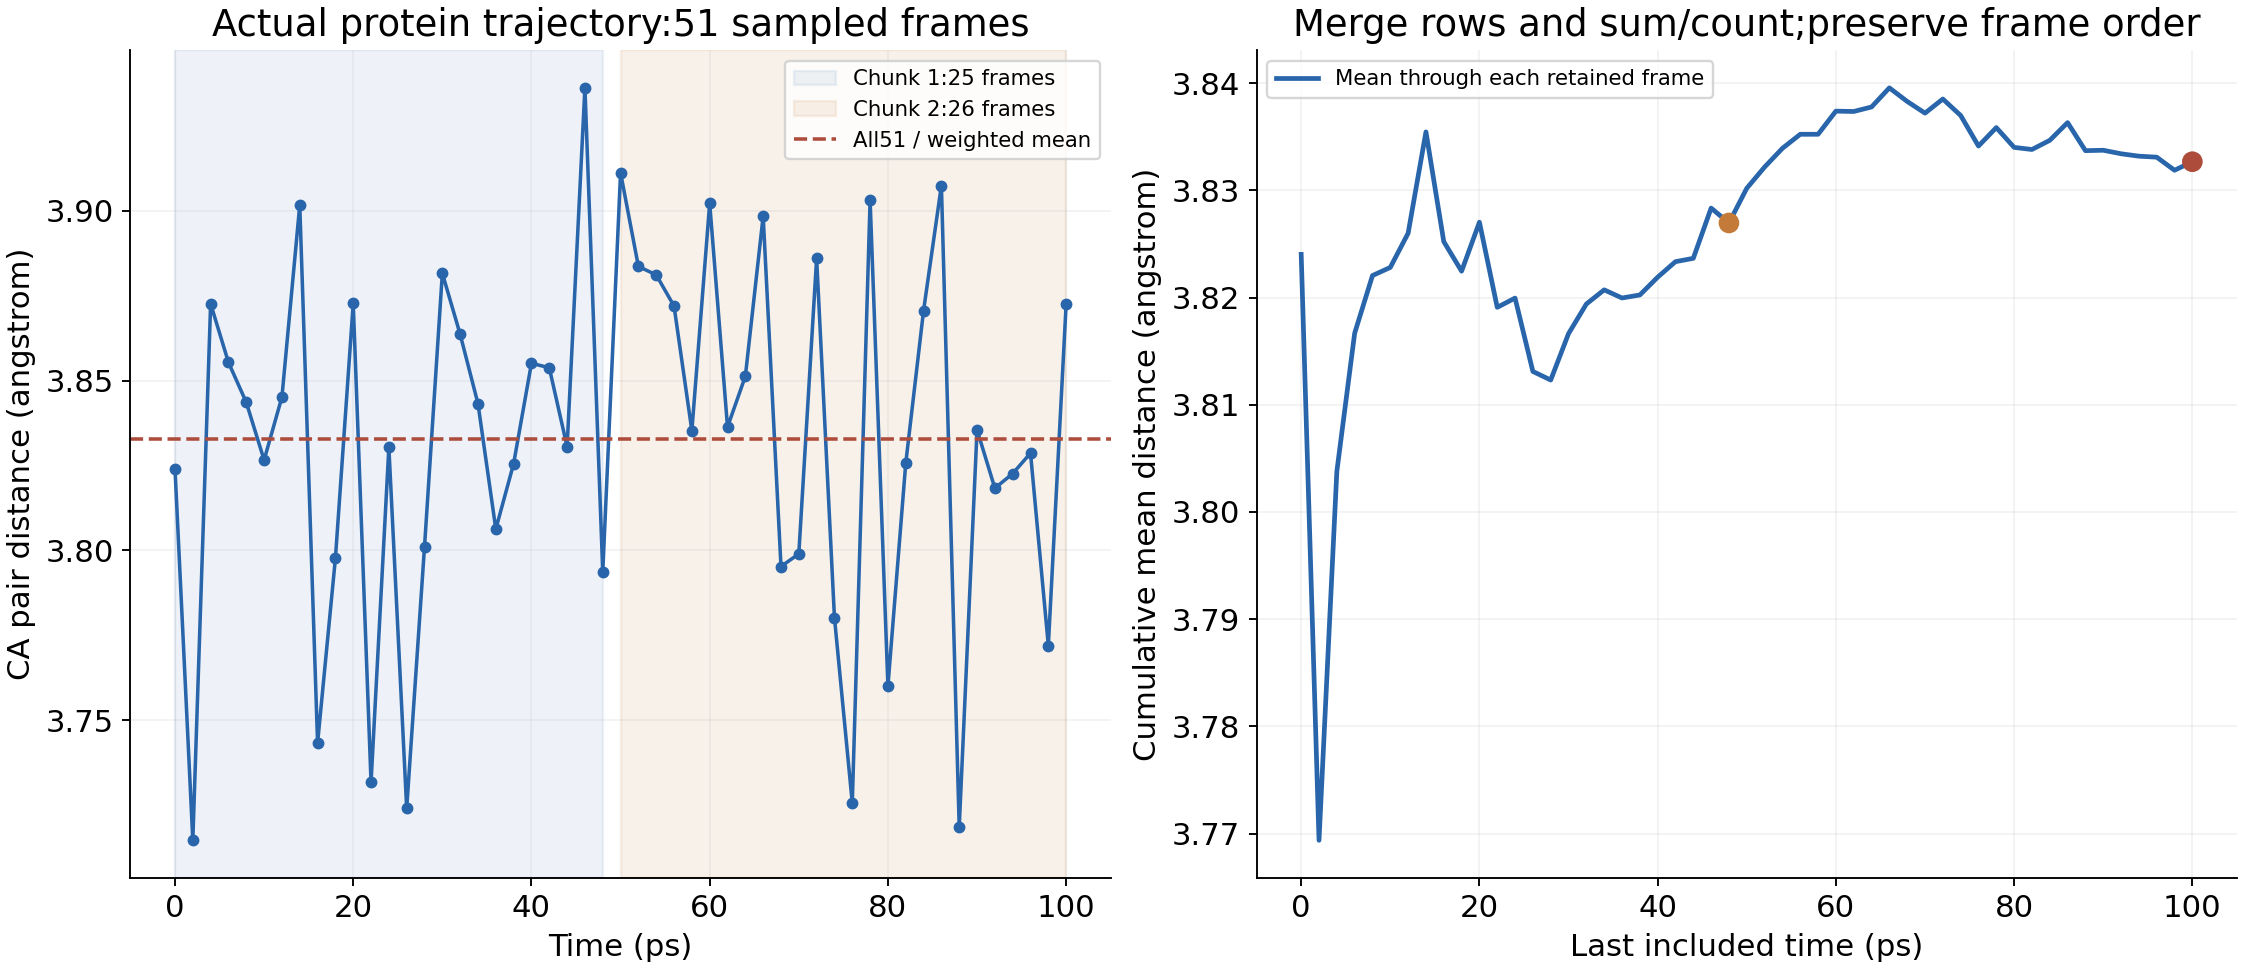
这里的 .run()是遍历已有轨迹帧,不是运行分子动力学。距离单位Å,时间单位ps。完整51帧平均距离为 3.8326709785 Å,只描述这段短轨迹与指定原子对,不是整个蛋白的平均尺寸。
2. Results既支持属性,也支持字典访问#
from MDAnalysis.analysis.results import Results
r = Results()
r.table = np.column_stack([times,values])
print(r.table.shape)
print(r['table'].shape)
本例得到51×2表。两个访问方式读取同一份数据,列含义由你明确记录;Results不会自动推断单位或给数组分配时间。
3. 合并两个长度不同的数据块#
完整实例把51帧分成前25帧和后26帧,然后实际调用原生 ResultsGroup.merge:
from MDAnalysis.analysis.results import ResultsGroup
parts = []
for sl in [slice(0,25),slice(25,None)]:
    parts.append(Results(
        table=np.column_stack([times[sl],values[sl]]),
        sum_distance=np.array([values[sl].sum()]),
        sample_count=np.array([len(values[sl])])) )
group = ResultsGroup(lookup={
    'table': ResultsGroup.ndarray_vstack,
    'sum_distance': ResultsGroup.ndarray_sum,
    'sample_count': ResultsGroup.ndarray_sum})
joined = group.merge(parts)
mean = joined.sum_distance[0] / joined.sample_count[0]
print(joined.table.shape,mean)
结果重新得到51行,帧的顺序与原始分析完全相同;总和除以总计数也与直接计算51帧平均相同。
这里按传入块的顺序堆叠,不会替你按时间排序、去重或发现丢帧。实际并行/分段处理时,应在表中保留帧号或时间,再检查是否覆盖了预期区间。
4. 为什么不能直接平均两个块的均值#
两块的均值分别约 3.8269570732 Å 和 3.8381651181 Å。直接取二者平均得到 3.8325610957 Å,而全数据平均是 3.8326709785 Å,因为两块分别有25与26帧。
等间隔采样的逐帧平均应合并“总和与计数”;若时间间隔不同,还需要按你定义的时间权重处理。分块均值的简单平均只有在适当条件下才等同于全数据平均。
5. 没有聚合规则时怎么办#
ResultsGroup默认要求每个键都有对应聚合函数,缺失时会报错。本次实际得到 No aggregation function for key='table'。这时应根据字段物理含义补规则,不能默认所有数组都直接堆叠,或把所有标量都做算术平均。
本次示例在单进程中说明合并行为,没有宣称分块后启动了多个分析进程。需要实际多进程或Dask,请接着看自定义分析与双进程和Dask后端。
cat reference-results/aggregation.json
head -n 8 reference-data/Protein-distance-aggregation.csv
下载包保留原始分析数值和完整脚本;不需要为查看这些结果重新进行蛋白模拟。