
LAMMPS 并行副本动力学:PRD四副本实操
从四个独立随机种子、partition到事件时钟,演示PRD的输入和结果读取。
阅读本篇目录
下载输入、势表、原生输出与绘图脚本,保存为 example.zip,先查看已有结果:
python3 -m zipfile -e example.zip .
cd lammps-rare-event-examples
bash results.sh
bash plot.sh
实例采用LAMMPS30Sep2026 CPU MPI版,Intel oneAPI/Intel MPI与配套MKL,集群模块 lammps/30Sep2026-8173m。数据使用同一CPU程序在兼容CPU上实际运行;不是CPU计算节点的性能测试。重新计算通过 sbatch 申请CPU资源,模板按集群CPU分区的56物理核规则申请,微型例子本身只使用1或4个MPI进程。
模型和事件判定#
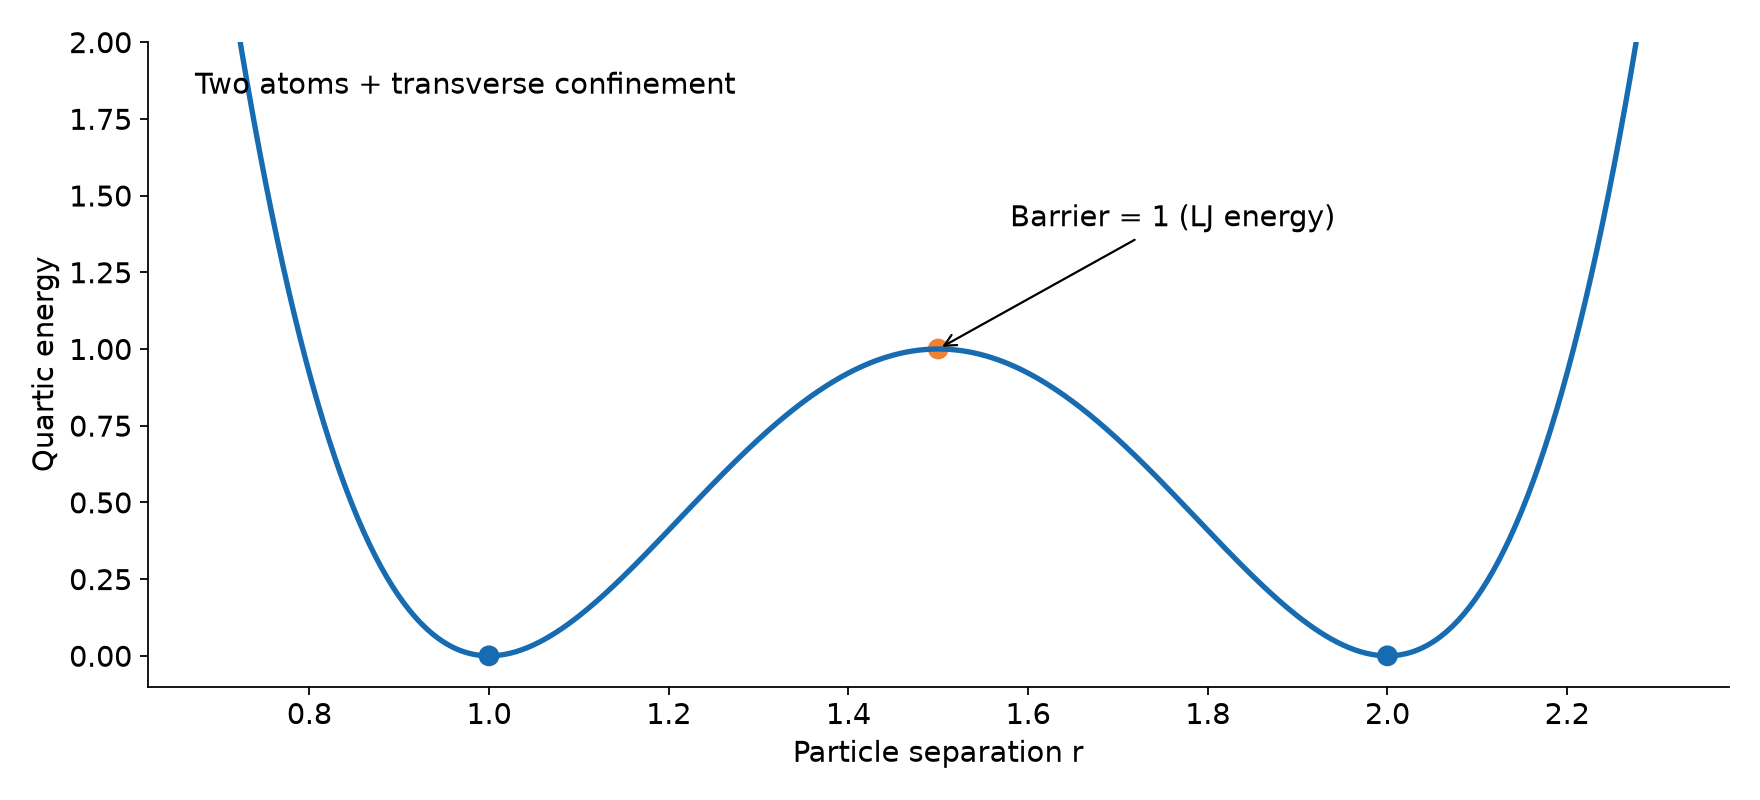
这是自定义教学模型:两粒子质量均为1,初始位置为 (-0.5,0,0) 和 (0.5,0,0)。使用LJ约化单位,径向势为:
U(r) = 16 * ((r - 1.5)^2 - 0.25)^2
r = 1 与 r = 2:两个势阱,U = 0
r = 1.5:鞍点,U = 1
两粒子的y、z方向各有弹簧约束,抑制绕行;弹簧能量计入总势能。势表包含20001点,覆盖r=0.4–3.5。它不对应具体材料,也不是离子对的真实力场。
fix transverse all spring/self 100 yz
fix_modify transverse energy yes
compute event all event/displace .3
每次事件检查前先最小化,比较的是势阱位置而非瞬时热振动。两阱之间每个原子的平衡位移为0.5,本例用0.3作为事件阈值。换实际体系时,应重新选择阈值、势函数和温度。
1. 四个partition各用一个MPI进程#
cat inputs/prd-s74411/in.lmp
sbatch run.slurm prd-s74411
在分配好的资源中,脚本实际执行的核心命令是:
mpirun -np 4 lmp -partition 4x1 -in in.lmp
4x1是四个副本、每个一个MPI进程;不是四个副本各使用四核。输入用world变量为副本分配不同的随机种子。
variable wid world 0 1 2 3
variable noise world 74411 74511 74611 74711
fix bath all langevin .2 .2 .2 ${noise} zero yes
compute event all event/displace .3
prd 60000 50 2 100 50 event 74911 &
    min 1e-10 1e-6 300 3000 temp .2 &
    vel geom gaussian time steps
完整输入先平衡2000步,再进入60000步PRD。50为事件检查间隔,后面的2、100、50分别控制去相位循环和时长、相关性检查时长。它们是本例参数,不能直接保证真实体系的副本独立性。
2. 看主日志,不只看某个副本#
cat reference-results/prd-s74411/prd-events.csv
cat work/prd-s74411/native.log
主输出的 Step 是MD步,Clock 是副本累计的物理时钟步数,Event 是事件编号,Replica是触发事件的副本。其他几列提示关联或同时事件。时钟的单位由 time steps指定为步,乘本例dt=0.002才得到LJ时间。
| 种子 | 最终记录的事件编号 | 最后记录事件的MD步 | 该事件的Clock | Clock乘dt |
|---|---|---|---|---|
| 74411 | 5 | 52850 | 210412 | 420.824 |
| 74429 | 5 | 48850 | 194456 | 388.912 |
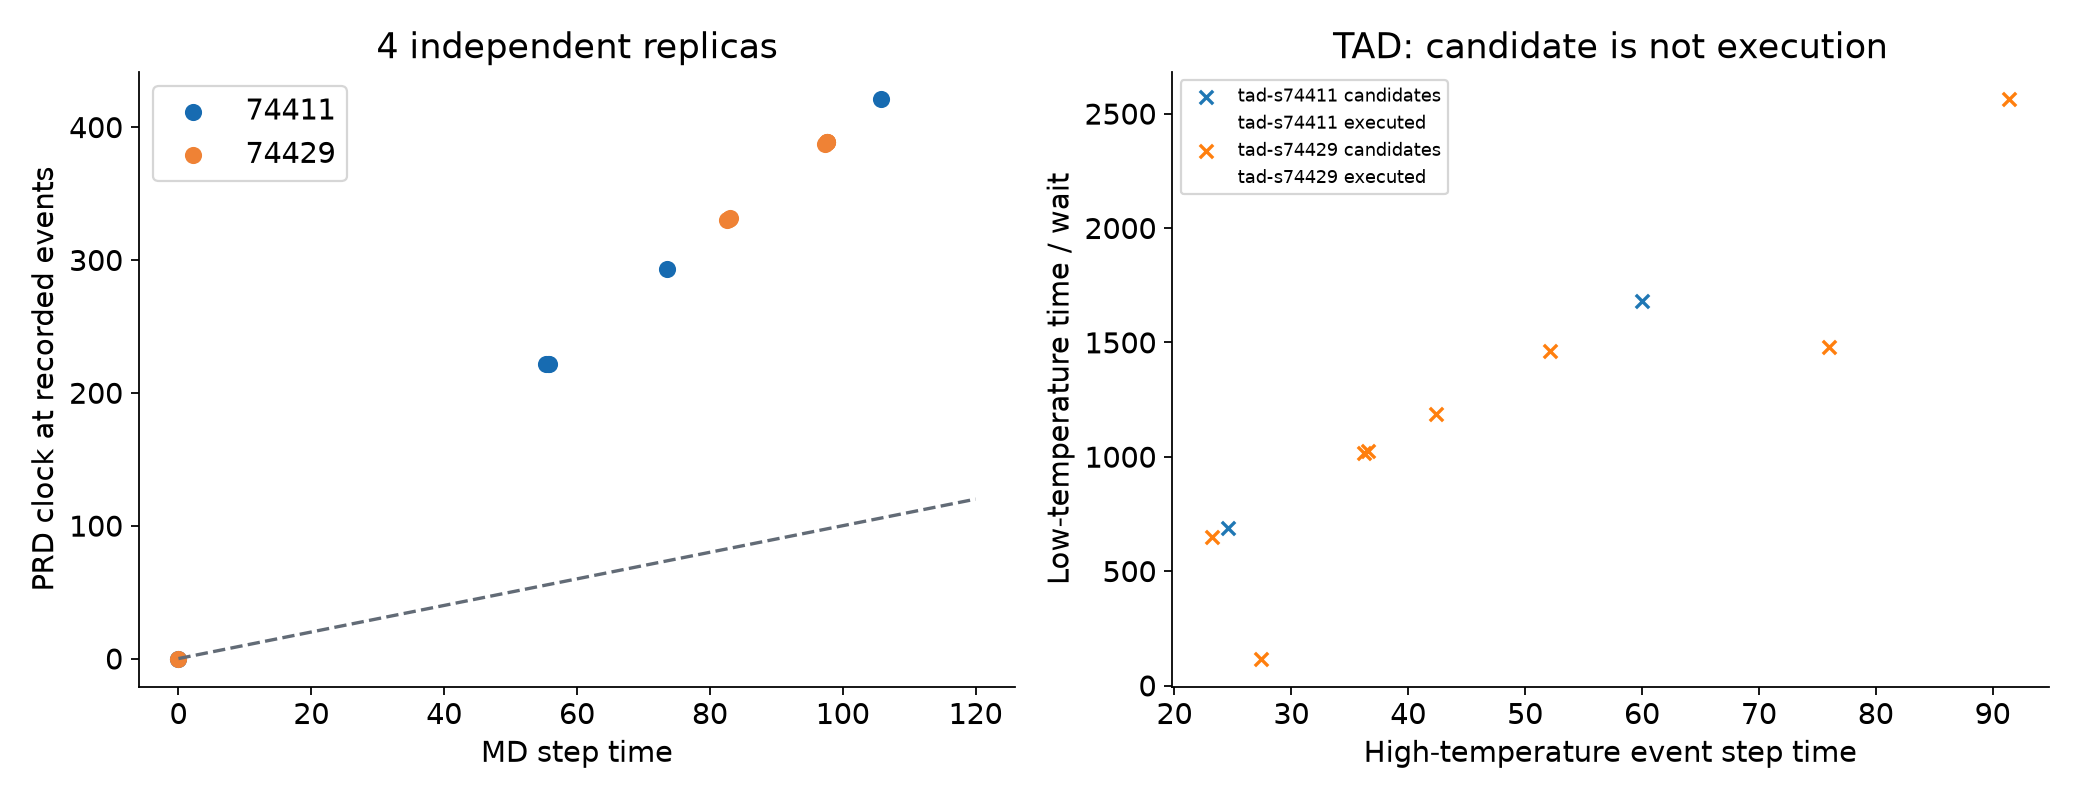
左图仅画输出记录中的事件点,点之间没有补造连续时钟。这里两个最后事件发生在不同MD步,因此不能简单用两行终值比较采样效率。
3. 用到真实材料时怎样调整#
先用普通MD检查势阱内的振动和弛豫时间,再选事件阈值和去相位时间,确认副本没有使用相同噪声序列。对于紧接着发生的快速往返,应延长相关性/去相位检查,判断是否只是同一跃迁的回穿。本次五个事件仅展示程序流程,不能据此报告收敛的材料扩散系数或理想四倍加速。
参数定义见LAMMPS PRD。